Si administras bases de datos en PostgreSQL, seguro te has topado más de una vez con el fenómeno del bloat: el hinchamiento progresivo de tablas e índices en disco. Parece que borraste la mitad de los registros antiguos con DELETE, pero el tamaño de la base en disco no se redujo ni un megabyte. Las consultas empiezan a ir más lento, la caché shared_buffers se contamina con páginas muertas y el espacio libre en el almacenamiento se esfuma ante tus ojos.
¿Qué hacer? ¿Ejecutar VACUUM FULL? En un entorno de pruebas, adelante. Pero en producción VACUUM FULL solicita un bloqueo estricto ACCESS EXCLUSIVE. Congela por completo cualquier operación de lectura y escritura sobre la tabla. Si la tabla pesa un par de terabytes, el servicio se detendrá durante horas y el negocio sufrirá pérdidas millonarias.
Durante años la comunidad se salvó con utilidades externas como pg_repack, pero su instalación exigía permisos de superusuario, triggers y malabares con la replicación. En el próximo lanzamiento de PostgreSQL 19, los desarrolladores del núcleo cerraron por fin esta deuda histórica incorporando el comando nativo REPACK.
Analicemos el análisis técnico de REPACK en PostgreSQL 19 y veamos cómo funciona este mecanismo por dentro.
La maldición de MVCC: cómo las filas muertas inflan las tablas y devoran la memoria
Para entender el valor de REPACK, conviene recordar cómo funciona el modelo de control de concurrencia multiversión de PostgreSQL (MVCC).
Cuando ejecutas una operación UPDATE, Postgres no sobrescribe físicamente los datos en su sitio. En su lugar, marca la versión antigua de la fila como invisible para futuras transacciones (escribiendo el identificador de transacción en el campo xmax) y crea una fila completamente nueva en la página de datos actual o en una contigua. Al ejecutar DELETE, la fila simplemente se marca como eliminada.
El demonio estándar en segundo plano autovacuum hace una labor importante: recorre las páginas, limpia los punteros a tuplas muertas (dead tuples) y actualiza el mapa de espacio libre (Free Space Map — FSM) para que las nuevas filas puedan ocupar los bytes liberados. Sin embargo, solo puede devolver espacio físico al sistema operativo mediante la llamada al sistema truncate en un único caso ideal: cuando se forman páginas completamente vacías justo al final del archivo físico de la tabla.
En la realidad, las filas vivas y muertas están mezcladas de forma caótica a lo largo de millones de páginas de 8 kilobytes:
- Una tabla de 10 millones de filas puede ocupar 200 gigabytes en disco en lugar de los 40 calculados;
- El escaneo secuencial (
Seq Scan) se ve obligado a subir del disco a la memoria RAM gigabytes de basura muerta; - Los árboles de índices B-Tree se fragmentan y pierden densidad espacial.
El comando histórico CLUSTER podía ordenar las filas según un índice, pero, al igual que VACUUM FULL, exigía un bloqueo exclusivo. La base quedaba rehén de su propia arquitectura.
Arquitectura de REPACK CONCURRENTLY: cuatro fases de reconstrucción en línea
La novedad clave de PostgreSQL 19 es el soporte del modificador CONCURRENTLY para el comando nativo REPACK. La sintaxis es sumamente concisa:
-- Reempaquetado en línea de una tabla de pedidos hinchada
REPACK CONCURRENTLY orders;

-- Reempaquetado con ordenación física simultánea de filas por fecha
REPACK CONCURRENTLY orders USING INDEX idx_orders_created_at;
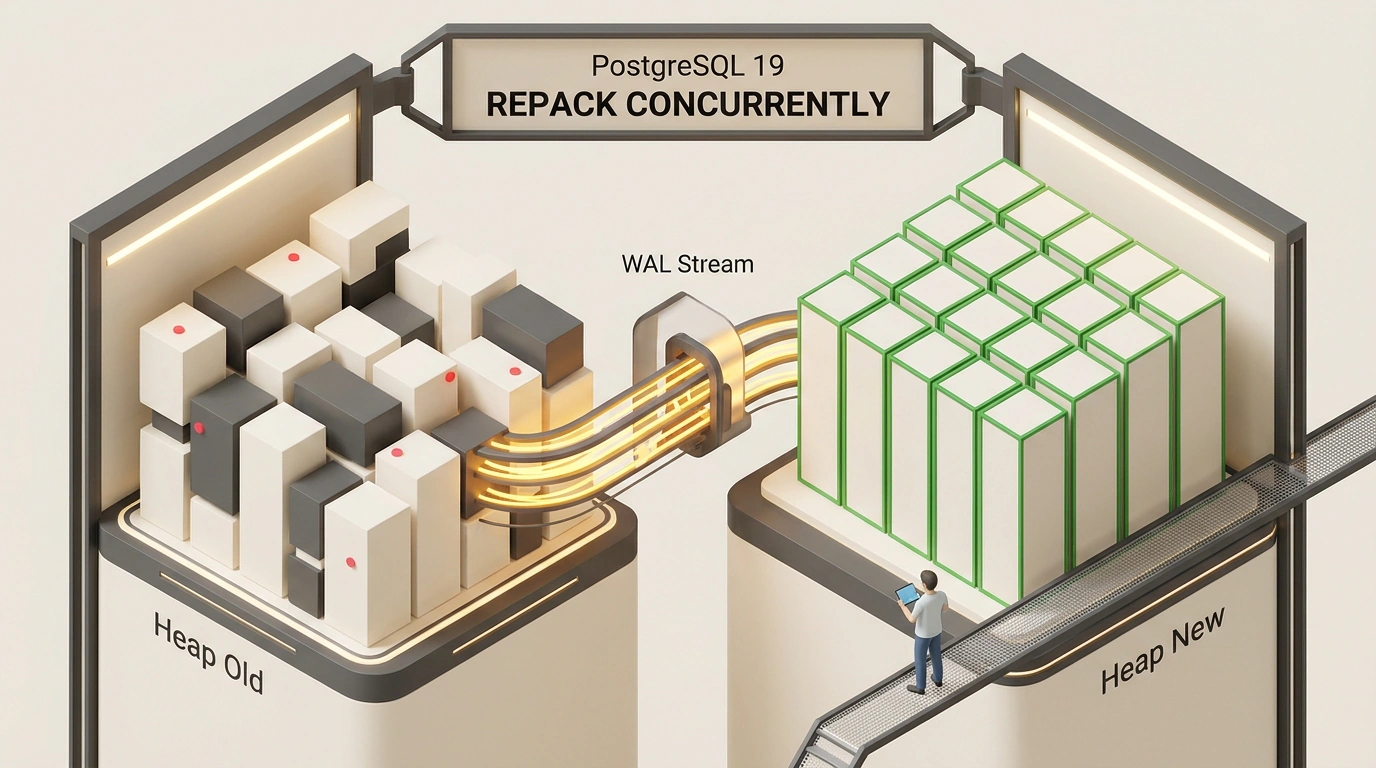
¿Cómo logra Postgres reconstruir por completo una tabla de terabytes sin interrumpir el flujo de transacciones entrantes? El motor ejecuta la operación en cuatro fases estrictas:
- Fase 1: Bloqueo suave y creación del heap de destino:
En lugar del destructivo
ACCESS EXCLUSIVE, el proceso solicita un bloqueo de nivelShareUpdateExclusiveLock. Es totalmente compatible conSELECT,INSERT,UPDATEyDELETEen paralelo. Solo se prohíben otras operaciones DDL pesadas (ALTER TABLE). En el catálogo se crea un archivo temporal de un nuevo heap con unrelfilenodeúnico. - Fase 2: Transferencia en segundo plano de los datos de la instantánea:
El motor lee todas las tuplas vivas de la tabla antigua según la instantánea de la transacción y las empaqueta con la máxima densidad en el nuevo archivo sin huecos vacíos. Si se indica el parámetro
USING INDEX, las filas se ordenan en disco, garantizando una velocidad fenomenal en posteriores consultas por rango (Index Scan). - Fase 3: Decodificación lógica de cambios (Catch-up): Mientras transcurría la fase de transferencia (que en grandes volúmenes puede durar decenas de minutos), los usuarios reales seguían modificando la tabla antigua. El núcleo intercepta estas modificaciones desde el registro de escritura anticipada WAL y las aplica secuencialmente sobre la nueva tabla hasta que el desfase se acerca a cero.
- Fase 4: Intercambio atómico instantáneo:
Durante unos pocos milisegundos se solicita un breve bloqueo exclusivo. Se aplican las últimas decenas de cambios desde el WAL, en la tabla del sistema
pg_classse intercambian los identificadores de archivo y el antiguo archivo hinchado se elimina de forma segura del disco devolviendo los bytes al sistema de archivos del SO.
Decodificación lógica en lugar de triggers: por qué pg_repack ya no hace falta
Si antes utilizabas la utilidad pg_repack, conoces su talón de Aquiles. La utilidad funcionaba mediante triggers de usuario:
- Sobre la tabla de destino se colgaba un trigger que en cada
INSERT/UPDATEduplicaba la fila en una tabla auxiliar de registro; - Esto duplicaba la carga sobre el subsistema de disco y generaba una enorme sobrecarga de CPU;
- Ante un fallo repentino del proceso de la utilidad, los triggers temporales quedaban en la tabla provocando fugas de memoria y bloqueando migraciones;
- En bases de datos gestionadas en la nube (AWS RDS, GCP Cloud SQL), las políticas de seguridad solían bloquear la instalación de la extensión.
En PostgreSQL 19 los ingenieros del núcleo optaron por un camino radicalmente distinto: aprovecharon el mecanismo nativo de decodificación lógica del WAL.
El mismo mecanismo sobre el que se construye la replicación lógica de Postgres ahora lee el registro binario de escritura anticipada directamente desde el núcleo. Sin triggers de usuario, sin doble escritura y sin riesgo de dejar la tabla con catálogos dañados. Si la operación REPACK CONCURRENTLY se interrumpe por un fallo del sistema, el archivo temporal simplemente es borrado por el recolector de basura en segundo plano y la tabla en producción sigue funcionando sin un solo error.
Como comentamos en detalle al analizar el REPACK CONCURRENTLY integrado en PostgreSQL 19, integrar el mecanismo en el núcleo convierte el mantenimiento de bases de datos de una arriesgada operación nocturna en un procedimiento rutinario en segundo plano.
Requisitos de espacio en disco y permisos de acceso: cómo ejecutarlo con seguridad en producción
A pesar de todas las bondades del modo CONCURRENTLY, tiene dos requisitos de ingeniería importantes que no debes olvidar al planificar los trabajos:
- Reserva de espacio en disco:
Dado que la tabla antigua con todos sus índices y la nueva copia en reconstrucción coexisten temporalmente en la misma unidad de disco, el espacio libre en el volumen debe ser de al menos el 110–120% del tamaño físico actual de la tabla. Si el disco está lleno al 90%, está terminantemente prohibido ejecutar
REPACK CONCURRENTLY: la base caerá por falta de espacio. - Asignación de memoria RAM:
La velocidad de ordenación de filas y construcción de índices en la fase 2 depende directamente del parámetro
maintenance_work_mem. En la configuración estándar suele estar limitado a 64 MB. Para tablas de terabytes, antes de iniciar la sesión se recomienda subir temporalmente el límite:
-- Asignamos 2 GB de memoria para ordenación en la sesión actual
SET maintenance_work_mem = '2GB';

-- Ejecutamos la limpieza en línea con ordenación física
REPACK CONCURRENTLY billing_transactions USING INDEX idx_billing_created;
En cuanto a los permisos de acceso, PostgreSQL 19 introduce el privilegio granular MAINTAIN. Ya no hace falta repartir entre los administradores los permisos del todopoderoso superusuario postgres:
GRANT MAINTAIN ON TABLE billing_transactions TO devops_engineer;
La llegada de REPACK nativo al núcleo supone una revolución largamente esperada en el mantenimiento de bases de datos. Por fin, librarse del bloat ha dejado de exigir guardias nocturnas y el riesgo de detener los procesos de negocio.