Durante dos décadas en el mundo del posicionamiento en buscadores reinó un feudalismo absoluto. Las reglas del juego eran simples, cínicas y dependían por completo del grosor de la billetera corporativa: si tenías presupuestos millonarios para enlaces externos, un equipo de cien especialistas técnicos y un dominio antiguo con historial, ocupabas de forma garantizada la primera línea en cualquier consulta comercial de alto volumen. Para un negocio regional pequeño, un taller especializado o una startup joven, asaltar el top en búsquedas como «entrega de flores» o «servicios jurídicos» se parecía a intentar derribar un muro de hormigón a cabezazos.
Pero la aparición de los buscadores generativos —Google AI Overviews, ChatGPT Search, Perplexity AI, Gemini y la renovada Alisa— derrumbó la vieja estructura de clasificación. En la industria surgió un fenómeno que los expertos bautizaron como la paradoja de la autoridad: los modelos de lenguaje generativos citan y recomiendan cada vez más en el primer párrafo de sus respuestas no a los viejos portales pesados, sino a recursos de nicho compactos.
El equipo de la agencia NP Digital, liderado por Neil Patel, realizó un análisis profundo de la metodología Generative Engine Optimization (GEO). Resultó que para ganar en los nuevos resultados se requieren acciones exactamente opuestas a la compra clásica de enlaces. Desarmemos capa por capa cómo funciona la mecánica de la búsqueda con IA y cómo una marca pequeña puede superar a los titanes del mercado.
1. La paradoja de la autoridad: por qué los presupuestos millonarios en enlaces ya no salvan a las corporaciones
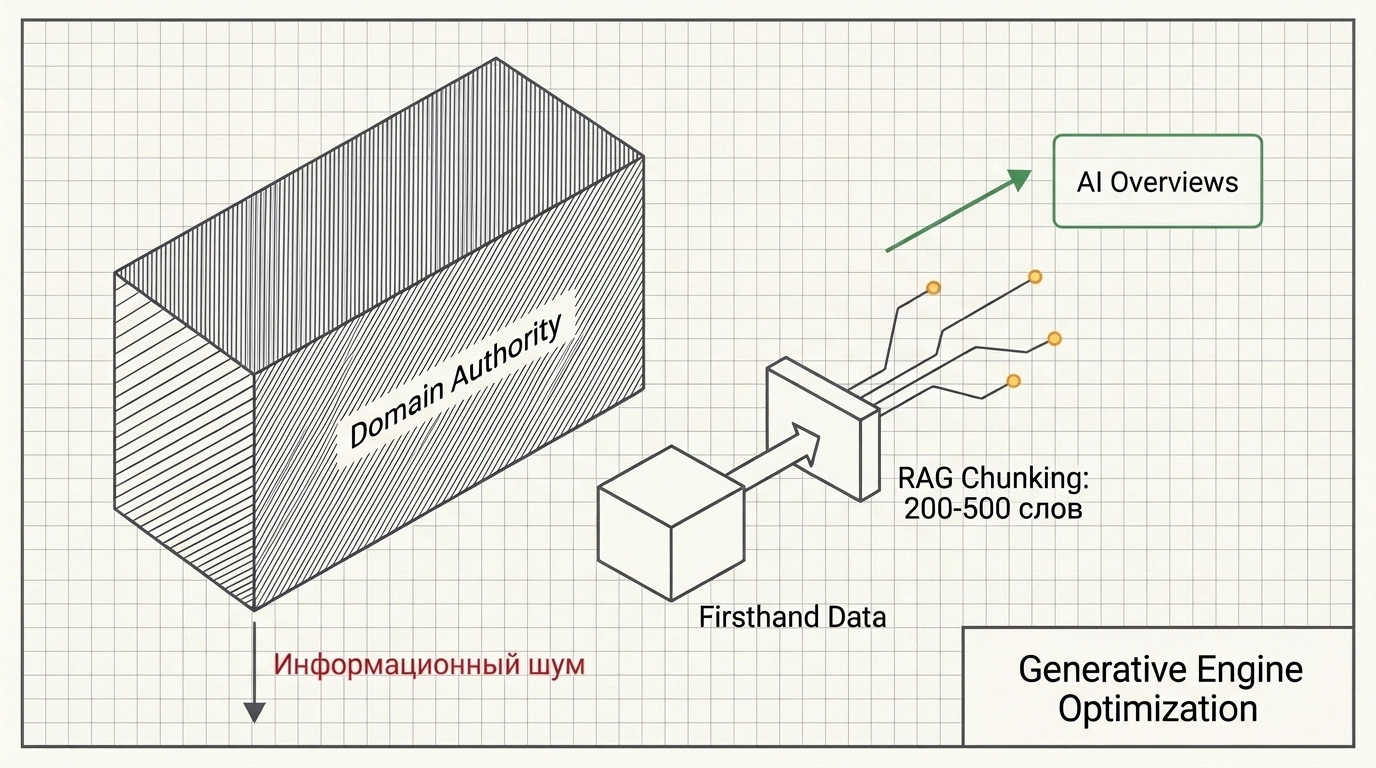
En el SEO clásico, las pequeñas empresas siempre tropezaban con el círculo vicioso del «huevo y la gallina»: para posicionarse en Google o Yandex, un sitio necesitaba miles de enlaces naturales y una alta autoridad de dominio (Domain Authority). Pero para conseguir esos enlaces, el sitio ya debía estar en las primeras posiciones y atraer a millones de lectores. Salir de ese bucle sin enormes inyecciones financieras era prácticamente imposible.
Las corporaciones explotaron este mecanismo durante décadas. Compraban enlaces en mercados, lanzaban redes de sitios satélite (PBN) y producían en serie artículos larguísimos inflados con párrafos «aguados» para retener palabras clave y volumen. Si un gran marketplace o un banco nacional publicaba un artículo de 15,000 caracteres donde lo útil ocupaba tres líneas y el resto se llenaba con reflexiones abstractas sobre la importancia de elegir un socio fiable, los rastreadores de búsqueda igual lo ponían en primer lugar gracias al peso colosal de enlaces del dominio.
En los sistemas generativos, esta lógica sufre un fallo sistémico. Las redes neuronales no calculan el grafo clásico de PageRank en el momento de generar la respuesta. Su tarea es sintetizar una respuesta concisa y factualmente impecable para una pregunta compleja, a menudo conversacional, del usuario. Y aquí las sábanas de texto corporativas juegan en contra de sus creadores: tienen una concentración demasiado baja de datos concretos por cada mil caracteres. Como se señalaba en el análisis sobre las nuevas reglas de visibilidad en buscadores en la era de las IA generativas, el robot simplemente extrae un fragmento conciso de un sitio de nicho, pasando por alto por completo al mastodonte corporativo.
Cuando un usuario le pregunta a Perplexity: «¿Qué bomba elegir para un pozo de 45 metros de profundidad con alto contenido de arena?», el sitio corporativo de un banco o un agregador entrega un largo artículo introductorio sobre la historia del suministro de agua. En cambio, un centro de ingeniería local de Vorónezh publica una tabla exacta con tres modelos de bombas con rodetes flotantes, mediciones de presión real e indicación del diámetro máximo admisible de los granos de arena. La IA toma al instante la tabla de Vorónezh para su respuesta y coloca el enlace al sitio de los ingenieros en lo más alto.
2. La cocina interna de la búsqueda con IA: cómo los pipelines RAG y la extracción de entidades cambian las reglas del juego
Para entender cómo aparecer en las citas de la IA, hay que mirar bajo el capó de los agentes de búsqueda modernos. A diferencia de los algoritmos tradicionales que trabajan con listas de documentos, los buscadores generativos utilizan la arquitectura RAG (Retrieval-Augmented Generation) — generación aumentada por recuperación de datos.
Cuando una persona introduce una pregunta compleja, el proceso se despliega en tres etapas consecutivas:
- Búsqueda vectorial y fragmentación semántica (Chunking): El buscador no lee las páginas enteras como lo hace un humano. El documento se corta en bloques semánticos de entre 200 y 500 palabras. Cada fragmento se convierte en un embedding vectorial: un punto matemático en un espacio multidimensional de significados. El buscador busca los fragmentos más cercanos al vector de la consulta del usuario según la distancia del coseno.
- Evaluación de densidad factual y consenso cruzado: Los fragmentos extraídos pasan a la fase de puntuación. El modelo compara los hechos obtenidos de distintas fuentes. Si varios recursos independientes mencionan las mismas características técnicas, fórmulas y rangos de precios, el algoritmo considera esos datos verificados. Si en cambio en un sitio solo hay paja verbal abstracta, el fragmento se descarta como ruido informativo.
- Síntesis final con inserción de citas: El modelo de lenguaje redacta el texto final, colocando enlaces y notas al pie hacia aquellas fuentes primarias cuyas formulaciones, términos y cálculos sirvieron de base para cada tesis de la respuesta.
Un estudio fundamental de investigadores de la Universidad de Princeton, que probaron nueve métodos distintos de optimización para GEO en miles de escenarios de búsqueda, confirmó: incluir en el contenido estadísticas verificadas, citas exactas de especialistas del sector y hechos numéricos comprobables aumenta la probabilidad de que el recurso aparezca en la respuesta final del sistema generativo en un 30–40%. Los algoritmos necesitan bloques de construcción para razonar, no extensas divagaciones filosóficas.
3. El arma de los equipos pequeños: producir datos de primer orden (Firsthand Data)
La principal ventaja de un negocio local pequeño frente a una corporación sin rostro es el contacto directo con la realidad viva. Las corporaciones cargan con aprobaciones engorrosas, cumplimiento normativo y filtros legales que dejan sus publicaciones esterilizadas hasta el punto de una corrección política insípida. No pueden escribir que un modelo popular de equipo falla en el 30% de los casos por una válvula de plástico defectuosa, porque el fabricante de ese equipo es su anunciante principal.
Bodegón industrial de objetos sobre el banco de un taller: botes con gramos exactos de esmalte automotriz, cuaderno de mediciones de consumo de materiales y una pieza pintada de parachoques.
Tú tienes en tus manos datos de primer orden (Firsthand Data) únicos que no posee ningún modelo de lenguaje en el mundo:
- Cifras reales de gastos y costes en tu región.
- Estadísticas vivas de averías y fallos de equipos de marcas concretas basadas en registros de taller.
- Tiempos exactos de ejecución de servicios y escollos poco evidentes en la instalación.
- Resúmenes de errores típicos de clientes con los que tu equipo de ventas se topa a diario.
Veamos un escenario concreto. Un taller local de chapa y pintura decide escribir un material sobre el pintado de parachoques de automóviles. Un portal corporativo publica el artículo estándar: «El pintado de un parachoques es un proceso delicado que requiere equipamiento profesional». El taller local actúa distinto: el maestro fotografía las etapas de aplicación de imprimación sobre plástico, publica el desglose exacto de consumo de materiales por pieza (120 gramos de imprimación, 150 gramos de esmalte base, 130 gramos de barniz) y muestra qué ocurre con la pieza al cabo de un año si se ahorra en el promotor de adherencia.
Cuando un usuario pregunta a una IA de búsqueda: «¿Por qué se descascara la pintura de un parachoques plástico después del invierno?», el modelo no encontrará respuesta en las corporaciones. Tomará el fragmento concreto del artículo del taller, citará los regímenes de temperatura de secado y pondrá el enlace a la publicación de los maestros. Esto es exactamente lo que exigen los estándares de evaluación E-E-A-T: demostrar experiencia práctica real (Experience).
4. Huella digital fuera de tu propio sitio: por qué Reddit y las bases sectoriales pesan más que el PageRank
El viejo paradigma nos enseñaba: lleva todo el tráfico exclusivamente a tu dominio y mantén una defensa cerrada. En el mundo del GEO, esa estrategia conduce al aislamiento. Las IA de búsqueda se entrenan con todo el abanico del internet público, construyendo el grafo de entidades (Entity Graph) de tu marca a partir de menciones externas.
Los estudios de citación muestran que en los bloques de Google AI Overviews el foro Reddit ocupa el segundo lugar en frecuencia de fuentes, solo por detrás de YouTube. Los chatbots ChatGPT y Perplexity rastrean activamente foros abiertos de discusión, directorios sectoriales, canales de expertos y bases de reseñas.
Si el algoritmo ve que el nombre de tu empresa es mencionado con regularidad por personas reales en comunidades especializadas, foros y chats profesionales en el contexto de resolver una tarea concreta de ingeniería o marketing, el modelo vincula tu marca con esa entidad. Se genera un efecto de validación cruzada: el buscador confía en tu sitio no porque tú mismo hayas escrito sobre tu excelencia, sino porque un consenso externo independiente confirma tu competencia.
Sobre cómo construir un armazón reputacional en bases de conocimiento y auditar la presencia de marca en IA ya contamos en detalle en el estudio sobre la auditoría de marca en respuestas de redes neuronales y búsqueda de ChatGPT. Para poner en marcha este proceso no hace falta hacer spam con enlaces: basta con responder dudas reales de usuarios en hilos especializados, compartir cálculos y publicar resúmenes de pruebas prácticas en plataformas abiertas.
5. Estructura técnica para rastreadores de IA: pirámide invertida y microdatos
Incluso el material factual más valioso pasará inadvertido si el robot de búsqueda se enreda en una maquetación compleja o no logra extraer rápido la esencia. Para comunicarse con los motores generativos, el texto debe organizarse según el principio de la pirámide invertida (Inverted Pyramid).
La esencia del principio es puramente utilitaria:
- Respuesta directa en la primera frase. Las primeras 40–50 palabras bajo un título o subtítulo deben dar una respuesta clara y cerrada a la pregunta planteada. Nada de introducciones líricas ni frases de relleno sobre «en el mundo actual de tecnologías en rápido desarrollo». El robot debe llevarse al instante una formulación lista para su fragmento generativo.
- Argumentación y pruebas. A continuación van los cálculos concretos, referencias metodológicas, comparaciones de alternativas y datos tabulares.
- Matices y limitaciones. Al final de la sección se detallan casos particulares, excepciones a la regla y consejos prácticos de implementación.
Un cimiento técnico obligatorio son los microdatos Schema.org. Implementar bloques estructurados FAQPage, HowTo, Product y TechArticle en formato JSON-LD permite a los rastreadores leer las entidades sin necesidad de interpretar el código HTML circundante. Esto elimina cualquier duda del buscador sobre qué cifra corresponde al precio y cuál al plazo de garantía.
Además, los robots de búsqueda generativa son sumamente sensibles a la limpieza del marcado semántico. Usar etiquetas de listas, enumeraciones con viñetas y frases cortas multiplica por varias veces la probabilidad de un análisis sin errores frente a los párrafos continuos. Si un material incluye un algoritmo paso a paso, cada punto debe ir claramente numerado y acompañado de un subtítulo conciso. Lo mismo aplica a las tablas: publica los datos comparativos en texto limpio o tablas HTML, no en capturas de pantalla. La IA lee las celdas como pares listos de «propiedad — valor» y los traslada con máxima precisión a la respuesta generada.
6. La economía de la era Zero-Click: cómo exprimir clientes del tráfico oscuro sin clics directos
El principal miedo de los emprendedores ante el GEO suena así: «Si el usuario lee la respuesta de la IA directamente en el buscador, no entrará a mi sitio. ¿Para qué gastar recursos en contenido si hay menos clics?».
Este fenómeno recibió el nombre de Zero-Click Search (búsqueda sin clics). En efecto, la era de las visitas fáciles y baratas por consultas informativas generales se marcha para no volver. Según monitoreos del sector, hasta el 60–70% de las sesiones de búsqueda informativa terminan hoy en la primera página sin un solo clic hacia enlaces externos.
Sin embargo, en lugar de clics llega un nuevo tipo de conversión: la creación de demanda de marca y la monetización del tráfico oscuro:
- Efecto ancla de experto: Cuando un cliente potencial ve una y otra vez que el asistente de búsqueda inteligente cita a tu empresa como fuente principal de cifras verificadas, se forma en él una sólida percepción de liderazgo experto. El siguiente paso del usuario ya no será una búsqueda abstracta, sino escribir directamente el nombre de tu marca en la barra de búsqueda.
- Registro de términos propios: Si no llamas a tu método simplemente «configuración de anuncios», sino que lo empaquetas bajo un nombre memorable (por ejemplo, «Matriz de filtrado integral de demanda»), la IA mencionará exactamente ese término al citarte. El lector interesado irá a buscar la fuente original de la metodología de autor.
- Seguimiento del eco de marca en analítica integral: La analítica web tradicional pierde el rastro de los usuarios que llegan tras interactuar con AI Overviews. Para cuantificar este efecto, sigue la dinámica de búsquedas de marca en Yandex Wordstat y Google Trends, y añade una pregunta obligatoria en el formulario de solicitud: «¿Cómo supiste por primera vez de nuestra empresa?».
La hoja de ruta paso a paso para que un pequeño negocio llegue al top de los resultados generativos se resume en cuatro pasos claros:
- Auditoría de preguntas reales de clientes: reúne las 50 dudas técnicas más frecuentes que escuchan tus comerciales o técnicos en primera línea.
- Publicación de protocolos primarios: sube para cada pregunta una ficha factual concisa con cifras, mediciones y cálculos en lugar de reflexiones generales.
- Implementación de microdatos FAQPage y Product: configura la generación automática de bloques JSON-LD para que los rastreadores lean las entidades al instante.
- Distribución de tesis en comunidades especializadas: comparte resúmenes de pruebas en plataformas externas independientes, creando un consenso externo alrededor de la marca.
Vencer a los gigantes en la era de la búsqueda generativa no es cuestión de presupuesto. Es cuestión de atreverse a compartir cifras reales, hablar a la audiencia con lenguaje humano y empaquetar tu experiencia práctica de tal modo que ninguna red neuronal pueda pasar de largo.