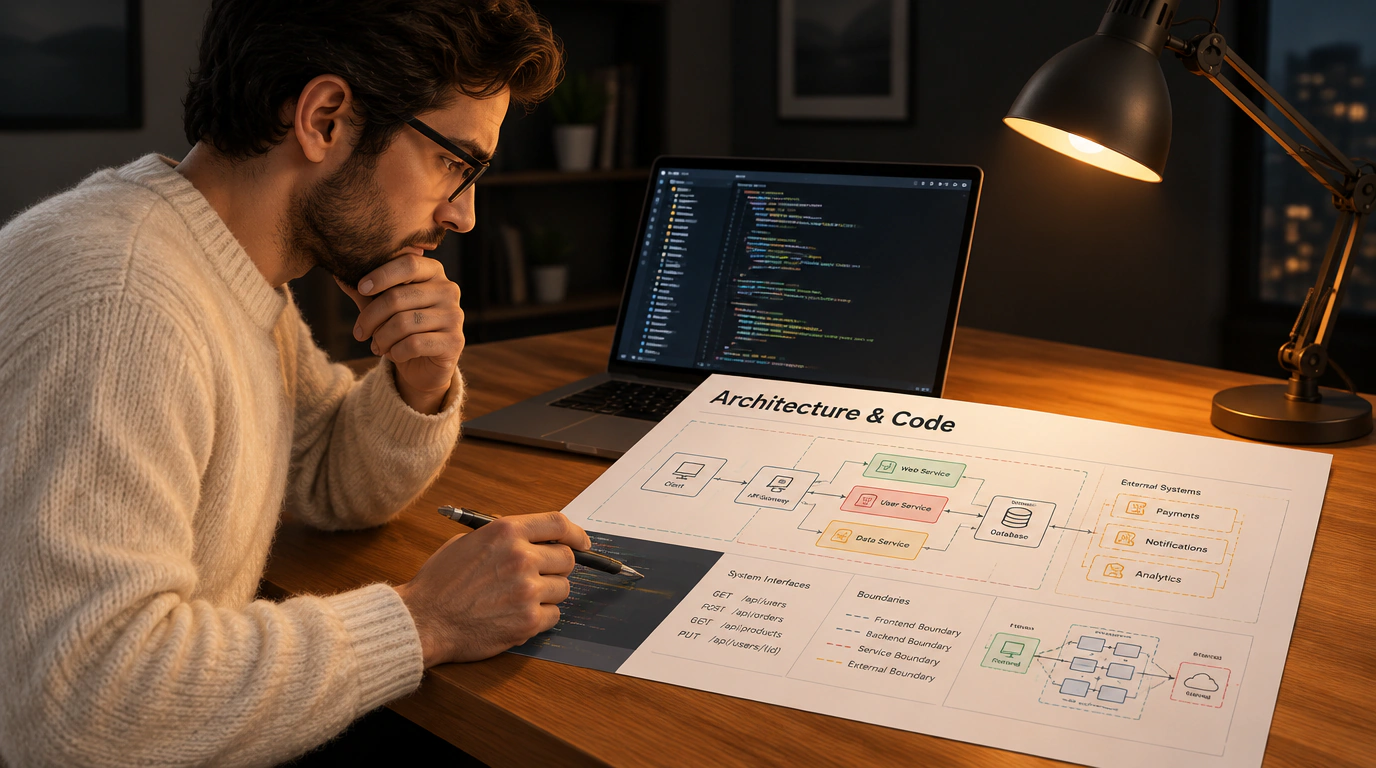
En los últimos meses, en las comunidades profesionales y redes sociales no cesa la euforia en torno al fenómeno del «vibe coding». El concepto dibuja un futuro idílico: el programador ya no necesita mirar líneas de código, entender algoritmos ni pelearse a mano con la sintaxis. Basta con esbozar una especificación o un prompt en lenguaje humano en el chat de un agente de programación, y la red neuronal generará amablemente la implementación, escribirá las pruebas y comprobará ella misma que pasen. Incluso ha surgido un lema popular: «No leas el código, simplemente confía en el proceso».
A primera vista, la tentación es enorme. La velocidad con la que aparecen los prototipos impresiona de verdad. Sin embargo, detrás de ese brillo exterior se esconde una grave trampa de ingeniería.
El conocido divulgador de los principios fundamentales de la programación Timur Shemsedinov (HowProgrammingWorks), en su charla «Не читай код: худший совет эпохи ИИ» (primera parte del ciclo fundamental «Arquitectura e IA»), realizó un análisis despiadado de este engaño. Su tesis principal resulta aleccionadora: renunciar a la lectura reflexiva del código es el consejo más peligroso de la ola tecnológica actual, que conduce con garantía al colapso arquitectónico del sistema en cuestión de pocos meses.
El código como único contrato formal del sistema
Para entender la raíz del problema, hay que hacerse una pregunta sencilla: ¿qué es en realidad el código fuente?
Muchos perciben el código como una instrucción puramente técnica para el compilador o la máquina virtual: una especie de boilerplate inevitable de bajo nivel del que dan ganas de librarse cuanto antes. Es un error profundo. El código fuente es el único modelo formal estricto del sistema, que fija las reglas del dominio, el tratamiento de estados límite, la propiedad de la memoria y el comportamiento ante fallos.
El lenguaje humano natural es, por su naturaleza, difuso, ambiguo y lleno de suposiciones contextuales. Cuando escribes en un prompt: «Crea un servicio de suscripciones y cobra una vez al mes», omites inevitablemente cientos de detalles invisibles. ¿Qué hacer ante un reembolso parcial? ¿Cómo manejar webhooks duplicados del banco? ¿Dónde pasan los límites de las transacciones?
La red neuronal generará código apoyándose en probabilidades promedio de su conjunto de entrenamiento. Pero si el desarrollador no lee el resultado obtenido, el sistema empieza a vivir su propia vida oculta. Renunciar a leer el código significa renunciar voluntariamente al control sobre cómo ejecuta exactamente el programa la tarea de negocio.
La ilusión de la verificación mutua: por qué falla la revisión entre agentes
Quienes defienden la autonomía total de la IA suelen replicar: «¡Pero podemos configurar un segundo agente! Que un bot escriba el código y un segundo bot en el papel de tech lead haga el code review y rechace las malas soluciones».
En teoría suena convincente. En la práctica aparece la llamada falacia de autoverificación de la IA (AI self-verification fallacy).
Ambos modelos —tanto el generador como el revisor— se entrenaron con los mismos corpus de código fuente y comparten los mismos sesgos probabilísticos. Los modelos son excelentes generando código localmente válido: una función aislada estará formateada con pulcritud, llevará bonitos comentarios y pasará con éxito el 95% de las pruebas sintéticas. Pero los modelos generativos son prácticamente incapaces de retener el contexto arquitectónico global de un repositorio grande con miles de archivos.
El agente revisor aprobará encantado el Pull Request porque la función es sintácticamente impecable. Pero no notará que esa función violó en secreto la frontera entre capas de abstracción, accedió directamente a una tabla ajena de la base de datos saltándose el servicio de dominio o creó una condición de carrera oculta en un entorno multihilo.
Degradación de las costuras arquitectónicas: acoplamiento oculto
La verdadera catástrofe de la generación ciega no llega el primer día, sino tras medio año de explotación activa. En la arquitectura clásica del software, las métricas clave de salud de una base de código son el bajo acoplamiento (low coupling) y la alta cohesión (high cohesion). Cada módulo debe responder de una tarea clara e interactuar con el resto del mundo a través de contratos de interfaz estrictamente definidos.
Cuando el agente lleva las riendas del código, los límites entre módulos se difuminan a una velocidad alarmante:
- Para cerrar rápido un ticket, el modelo duplica estructuras de datos en cinco sitios distintos en lugar de reutilizar un tipo común.
- En el código se cuelan sin hacer ruido efectos secundarios: mutación de variables globales, dependencias implícitas del estado de temporizadores del sistema, accesos descontrolados al sistema de archivos.
- Las capas de la arquitectura se hunden unas dentro de otras: los controladores empiezan a ejecutar consultas SQL directamente, y las utilidades de formateo de fechas de pronto envían peticiones de red.
El sistema se convierte rápidamente en un monolito frágil de «código espagueti». En cierto momento se alcanza un punto de no retorno: intentar corregir una errata en el módulo de notificaciones rompe el cálculo del carrito de compras en el extremo opuesto del proyecto. El coste total de propiedad (TCO) de ese código se dispara a las nubes y el equipo acaba reconociendo que sale más barato reescribir el proyecto desde cero.
Cambio de paradigma: de teclear símbolos a la lectura analítica
¿Significa la crítica de Shemsedinov que debamos tirar las redes neuronales y volver a teclear boilerplate a mano en Vim? Por supuesto que no. La IA es un multiplicador magnífico de productividad si se usa con los ojos abiertos.
Simplemente, en la profesión de programador se está produciendo un desplazamiento tectónico:
- La habilidad de codificación mecánica (teclear rápido con los dedos clases plantilla, bucles y estructuras de datos) se devalúa de verdad a gran velocidad. La máquina lo hace mejor y más rápido que el humano.
- La habilidad de lectura analítica profunda del código, por el contrario, se convierte en el principal superpoder profesional del ingeniero.
El desarrollador de la era de los agentes de programación avanzados y de la lucha contra la erosión arquitectónica de los sistemas, sobre la que reflexionamos en análisis anteriores, ya no es un albañil que coloca cada ladrillo a mano. Se convierte en arquitecto general y severo inspector de control técnico.
El ingeniero debe escanear de un vistazo cien líneas generadas y detectar en treinta segundos: ajá, aquí hay una complejidad cuadrática $O(N^2)$ gratuita, aquí falta cerrar el descriptor de archivo y esta línea rompe el aislamiento transaccional.
Para proteger la base de código frente a la erosión arquitectónica al trabajar con agentes, introduce en el CI linters arquitectónicos (por ejemplo, dependency-cruiser para TypeScript/JavaScript o ArchUnit para Java). Fija en la configuración reglas estrictas: la capa de controladores no tiene derecho a importar directamente la capa de acceso a BD. Si el agente genera una importación torcida, el linter bloqueará la compilación al instante.
Equilibrio maduro de ingeniería
La conclusión práctica es sencilla y pragmática. Delega en los agentes el trabajo en borrador: generación de plantillas de pruebas, parseo de formatos, migraciones rutinarias y redacción de documentación. Pero nunca apagues tu propio pensamiento crítico.
Si no entiendes cómo funciona cada línea de código confirmada en main, ya no controlas tu producto. La verdadera madurez de ingeniería no consiste en pulsar el botón «Generar» más rápido que nadie, sino en detectar a tiempo la grieta arquitectónica antes de que el edificio se derrumbe bajo la carga.