Si a tu equipo le ha tocado desplegar modelos de lenguaje abiertos —por ejemplo, la familia Qwen 2.5, Llama 3 o los checkpoints recientes de DeepSeek— en vuestro propio entorno cerrado, seguro que has sentido todo el dolor del mercado actual de cómputo. Conseguir un pool monolítico de varias decenas de aceleradores NVIDIA H100 en un solo proveedor cloud hoy es o imposible por las colas, o absurdamente caro.
En la práctica, la infraestructura se convierte rápido en un mosaico. Dos nodos con A100 alquilados en AWS, un clúster con L40S corriendo en un neocloud especializado como CoreWeave o Lambda Labs, y un par de servidores con tarjetas de consumo RTX 4090 en instalaciones propias para experimentos. A nivel de un único pod en Kubernetes el stack está claro desde hace tiempo: usamos el motor vLLM o SGLang, configuramos PagedAttention y conectamos el autoescalado con KEDA. Pero en cuanto los pods pasan de la decena y los clústeres están repartidos por tres continentes, el equipo de plataforma se ahoga en el enrutamiento manual de tráfico y la conciliación de versiones.
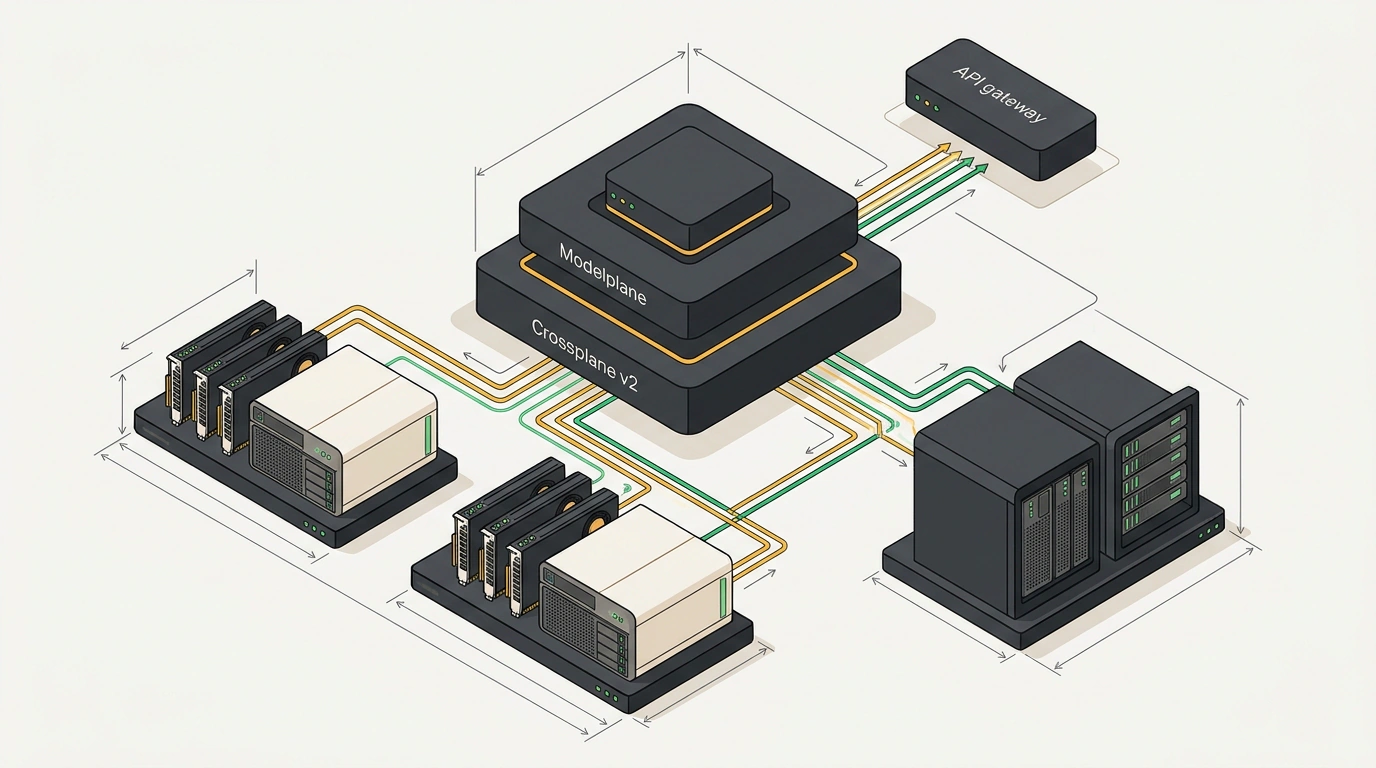
La respuesta arquitectónica a este caos la propuso Nic Cope, uno de los mantenedores clave del proyecto Crossplane durante los últimos ocho años. Su nuevo proyecto abierto Modelplane convierte un zoológico fragmentado de GPUs en una única plataforma de inferencia gestionada, utilizando las abstracciones probadas de Kubernetes.
Arquitectura de la capa de control: Crossplane v2 en lugar de operadores artesanales
La principal valentía de ingeniería de Modelplane reside en aquello a lo que su autor renunció conscientemente. El primer impulso de cualquier arquitecto en una situación así habría sido sentarse a escribir desde cero otro pesado operador de Kubernetes en Go con una decena de controladores personalizados, bucles de reconciliación hechos a mano y una lógica frágil de sincronización de estados.
Cope tomó otro camino: Modelplane está construido íntegramente sobre las abstracciones nativas del núcleo de Crossplane v2: definiciones de recursos compuestos (Composite Resource Definitions, XRD), composiciones (Compositions) y funciones de composición (Composition Functions). En lugar de reinventar la rueda, el proyecto aprovecha los mecanismos listos del núcleo:
- bucles de reconciliación fiables (reconciliation loops);
- finalizadores de eliminación de recursos;
- protección automática frente a la deriva de configuración en tiempo de ejecución;
- el modelo nativo de espacios de nombres (Namespaced Composites), introducido en la segunda versión mayor de Crossplane, que libró a la plataforma de la engorrosa dupla Claim/XR.
Las propias funciones de composición están escritas en Python, el lenguaje principal del aprendizaje automático moderno. Gracias a la generación de esquemas y clases estrictamente tipadas mediante la nueva CLI de Crossplane, se logró describir la lógica de ubicación de modelos de forma compacta y sin riesgo de erratas en diccionarios YAML interminables.
Gestión declarativa: filtros CEL para memoria de vídeo
En Modelplane están claramente separadas dos áreas de responsabilidad:
- Los ingenieros de plataforma operan con las entidades de clúster
InferenceClustereInferenceClass. Conectan proveedores cloud de Crossplane, solicitan máquinas virtuales y vigilan la salud física de los nodos. - Los desarrolladores de ML trabajan exclusivamente a nivel de los espacios de nombres de proyecto mediante el recurso
ModelDeployment. No necesitan conocer direcciones IP ni topología de red: simplemente declaran qué modelo quieren ejecutar y cuánta memoria de vídeo requiere.
Para formular los requisitos de hardware se utiliza el lenguaje Common Expression Language (CEL). Veamos cómo luce un manifiesto típico de despliegue de modelo:
apiVersion: modelplane.ai/v1alpha1
kind: ModelDeployment
metadata:
  name: qwen3-8b
  namespace: ml-team
spec:
  replicas: 2
  engines:
  - name: qwen-engine
    members:
    - role: Standalone
    nodeSelector:
      devices:
      - name: gpu
        count: 1
        selectors:
        - cel: device.capacity["gpu.nvidia.com"].memory.compareTo(quantity("20Gi")) >= 0
    template:
      spec:
        containers:
        - name: engine
          image: vllm/vllm-openai:v0.23.0
          args:
          - "--model=Qwen/Qwen3-8B"
          - "--served-model-name=qwen"
Fíjate en el selector CEL: en lugar de atarse rígidamente a un modelo concreto de tarjeta como nvidia.com/gpu-model: A100-SXM4-80GB, el manifiesto declara un umbral mínimo de memoria de vídeo de 20 gigabytes. El planificador de Modelplane encontrará por sí mismo un nodo libre adecuado, ya sea L40S, A100 o una tarjeta de instancia recortada en la nube.
Circuito de infraestructura: Composite Resource Definitions
En el nivel de plataforma, la capa de control traduce las peticiones de alto nivel del equipo de desarrollo en recursos de infraestructura concretos. A continuación se muestra un ejemplo de manifiesto Composition que vincula una clase de inferencia de plataforma con un clúster físico:
apiVersion: apiextensions.crossplane.io/v1
kind: Composition
metadata:
  name: inference-cluster-aws
  labels:
    provider: aws
    tier: high-memory
spec:
  compositeTypeRef:
    apiVersion: modelplane.ai/v1alpha1
    kind: InferenceCluster
  mode: Pipeline
  pipeline:
  - step: provision-gpu-nodes
    functionRef:
      name: function-python-placement
    input:
      apiVersion: modelplane.ai/v1alpha1
      kind: PlacementConfig
      minVramPerNode: "80Gi"
      spotTolerance: true
La función de ubicación function-python-placement consulta al vuelo las métricas de disponibilidad de cuotas en las cuentas conectadas, levanta instancias spot para ahorrar presupuesto y configura dinámicamente la pasarela perimetral de enrutamiento.
Planificación dinámica y pasarela compatible con OpenAI
Para los servicios de aplicación de la empresa, toda esta compleja arquitectura híbrida se ve como un servicio remoto habitual con el protocolo OpenAI API (/v1/chat/completions).
La pasarela basada en Kubernetes Gateway API recibe la petición entrante para el modelo qwen, comprueba la longitud actual de las colas en los backends de vLLM y redirige el flujo de tokens al pod menos cargado. Si una de las ubicaciones pierde energía de repente o el proveedor cloud revoca un servidor spot, el controlador de Crossplane traslada al instante la carga al clúster de respaldo sin cortar las sesiones activas de los clientes.
Combinado con las prácticas de ingeniería para construir sistemas agénticos tolerantes a fallos que detallamos en la guía de ingeniería de agentes de IA, este enfoque permite no reescribir el código del backend al cambiar de proveedor de capacidad de cómputo.
Al configurar las colas en Modelplane, utiliza el escalado de KEDA mediante la métrica vllm_num_requests_waiting. Escalar por el uso clásico de CPU o memoria GPU no sirve de nada: los motores de inferencia reservan el 90% de la VRAM para la caché KV nada más arrancar, por lo que el verdadero indicador de sobrecarga es precisamente el tamaño de la cola de prompts en espera.
Compromisos de ingeniería y sobrecarga de red
Sería un error considerar Modelplane una bala de plata mágica que resuelve gratis los problemas de los sistemas distribuidos. Por una abstracción universal hay que pagar con compromisos de ingeniería.
El reto principal es la conectividad de red. Para que los pods de inferencia en distintas nubes puedan intercambiar tráfico de forma segura y descargar pesados pesos de modelos desde un registro común, hace falta tender una red overlay sobre las ubicaciones (WireGuard, Cilium ClusterMesh o Cloudflare Magic WAN). Transferir los pesos de un modelo de 70 mil millones de parámetros con un tamaño de 140 gigabytes por internet público lleva un tiempo considerable, por lo que el almacenamiento en caché de artefactos en discos NVMe locales de los nodos sigue siendo un requisito obligatorio.
No obstante, para equipos de plataforma maduros el enfoque de Nic Cope marca un nuevo estándar: en lugar de inflar un zoológico de scripts bash desechables, obtenemos una arquitectura declarativa limpia, escalable según las reglas nativas de Kubernetes.