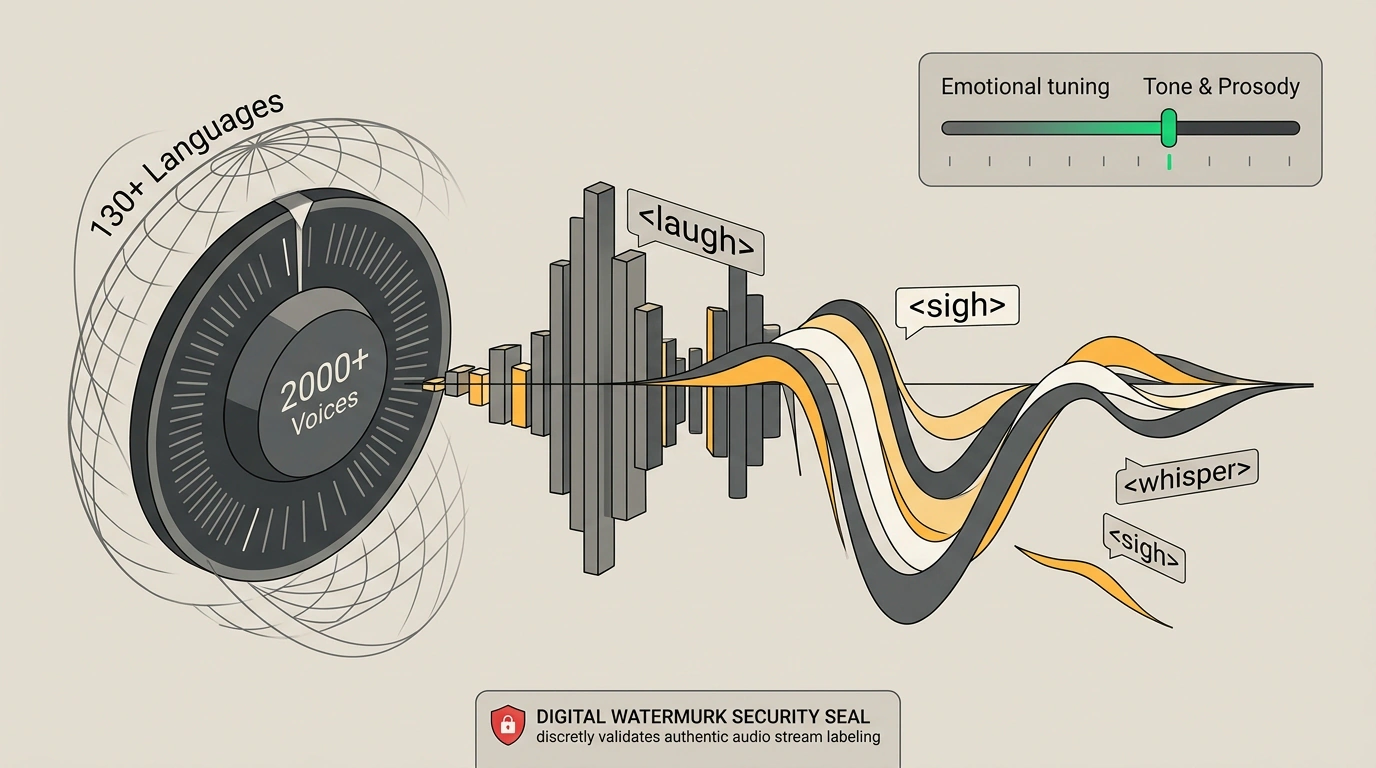

Автоматическое преобразование текста в речь долго страдало от монотонности: механический диктор безошибочно вычислялся на слух из-за отсутствия живых интонаций. Компания Google представила специализированные модели Gemini 3.8 Flash TTS и Flash-Lite TTS, превращающие генерацию аудио в управляемый процесс с библиотекой из более чем 2000 голосов.
Технологию можно сравнить с работой профессионального актера дубляжа у студийного микрофона: вместо зачитывания сухого текста по слогам он чутко следует авторским ремаркам, меняет интонацию от шепота до воодушевления, делает выразительные паузы и смеется в нужный момент сценария.
Преодоление «зловещей долины»: почему роботизированные дикторы утомляют
Классические синтезаторы речи работают по жестким словарям фонем, подходя для коротких навигационных подсказок, но проигрывая в озвучке подкастов и обучающих курсов.
Главное отличие семейства Gemini 3.8 TTS заключается в глубоком семантическом понимании текста. Модели анализируют не просто цепочку букв, но контекст повествования: иронию, драматическое напряжение, риторические вопросы и восклицания. Это устраняет слуховую усталость и позволяет генерировать живую человеческую речь на ста тридцати языках и локальных диалектах — от квебекского французского до шотландского английского.
Текстовая режиссура: как промпт задает характер и интонации диктора
В моделях реализована концепция Prompt-Driven Voice Styling. Разработчикам больше не требуется собирать многочасовые записи дикторов для дорогостоящего клонирования голоса. Тембр, возраст, профессию и подачу можно задать естественным языком в системном описании — например: «Доброжелательный инженер тридцати лет, увлеченно рассказывающий о сложной технологии простыми словами».
Кроме того, модель поддерживает разметку просодии и эмоций непосредственно в тексте. Специальные теги вида <laugh>, <sigh> и <pause time="500ms"/> позволяют режиссеру аудиодорожки расставлять естественные вздохи, смешки и паузы, делая темп речи абсолютно неотличимым от живой записи.
Программный синтез через официальный SDK с тегами эмоций
Для вызова флагманской модели gemini-3.8-flash-tts используется официальный клиент Google GenAI. Настройки языка, скорости и настроения передаются через структурированный блок speech_metadata:
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ.get("GEMINI_API_KEY"))

# Синтез выразительной речи с интонационными тегами и метаданными
response = client.models.generate_content(
    model="gemini-3.8-flash-tts",
    contents="Привет! <laugh> Вы не поверите, какие обновления выкатила команда разработки. </laugh> Разберем главные детали.",
    config=types.GenerateContentConfig(
        response_mime_type="audio/mp3",
        speech_config=types.SpeechConfig(
            voice_config=types.VoiceConfig(
                prebuilt_voice_config=types.PrebuiltVoiceConfig(voice_name="Puck")
            ),
            speech_metadata={
                "language_code": "ru-RU",
                "speaking_rate": 1.05,
                "emotional_tone": "enthusiastic_and_clear"
            }
        )
    )
)

with open("output_announcement.mp3", "wb") as f:
    f.write(response.candidates[0].content.parts[0].inline_data.data)
Высокоскоростной Flash-Lite TTS и потоковые сценарии
Когда на первом месте стоит минимальная сетевая задержка и высокая пропускная способность — например, в телефонных ассистентах службы поддержки или голосовых интерфейсах реального времени — применяется облегченная версия gemini-3.8-flash-lite-tts. Она использует идентичный протокол параметров, но генерирует поток в разы быстрее:
# Высокопроизводительный вызов облегченной модели Flash-Lite TTS
response_lite = client.models.generate_content(
    model="gemini-3.8-flash-lite-tts",
    contents="Ваш заказ успешно оформлен и передан в курьерскую доставку.",
    config=types.GenerateContentConfig(
        response_mime_type="audio/wav",
        speech_config=types.SpeechConfig(
            speech_metadata={
                "language_code": "ru-RU",
                "emotional_tone": "calm_support"
            }
        )
    )
)
Масштабирование контента и прикладной вывод
Появление Gemini 3.8 Flash TTS открывает возможность массовой автоматической локализации контента: один и тот же подкаст или обучающий урок теперь можно выпустить на десятках языков с сохранением оригинальной эмоциональной окраски спикера. Единая схема API и выбор между максимальным творческим качеством (Flash) и рекордной скоростью (Flash-Lite) делают интеграцию речевого интеллекта доступной для любых прикладных сервисов.