

Долгое время в индустрии искусственного интеллекта господствовало негласное правило: для решения сложнейших задач математики и логики необходимы гигантские модели с десятками или сотнями миллиардов параметров. Считалось, что глубокие цепочки рассуждений (reasoning traces) физически не помещаются в компактные веса, требуя огромных вычислительных кластеров и гигабайт видеопамяти.
Релиз итальянской исследовательской лаборатории Paradigma полностью опровергает этот миф. Команда представила модель Limite 1B - Violetto — плотный авторегрессионный трансформер размером всего в один миллиард параметров, который весит скромные 2,1 ГБ и распространяется под свободной лицензией Apache 2.0.
Несмотря на миниатюрный размер, модель установила абсолютный рекорд среди открытых компактных сетей на олимпиадных тестах 2026 года, оставив далеко позади признанных тяжеловесов индустрии.
Олимпиадные бенчмарки: победа над гигантами
На соревновательных математических тестах высокой сложности Limite 1B продемонстрировала феноменальные результаты:
- AIME 2026 (Американская математическая олимпиада): модель набрала 94,01% правильных ответов. Для сравнения: сильная открытая сеть VibeThinker-1.5B показала 70,94%, MiniCPM-5-2B набрала 90,21%, а значительно более крупная Qwen-3.5-9B остановилась на отметке 90,42%;
- HMMT (Гарвардско-Массачусетский математический турнир, февраль 2026): 83,62%;
- Beyond AIME: сложнейший тест на математическую креативность принес модели 74,25%, тогда как тридцатимиллиардный гигант Muse Glimmer 30B набрал на тех же задачах всего 50,0%;
- Apex Shortlist: соревновательный бенчмарк олимпиадного шорт-листа зафиксировал 50,80% точности.
Как уместить математический интеллект в 2,1 ГБ
Секрет такой эффективности кроется не в масштабировании железа, а в принципиально иной методологии подготовки данных и обучения:
- Обучение с нуля на микро-датасете: вместо сжатия гигантских веб-дампов команда Paradigma обучила модель «с чистого листа» на тщательно отобранном датасете объемом менее 300 миллиардов токенов;
- Верифицируемое обучение с подкреплением (RLVR): в точных науках ответ либо строго верен, либо ошибочен. Модель обучалась по методике Reinforcement Learning with Verifiable Rewards, где алгоритмический компилятор автоматически проверял корректность каждого шага доказательства, отсекая тупиковые ветви;
- Огромный контекст в 131k токенов: поддержка окна контекста до 131 072 токенов позволяет компактной модели удерживать в памяти громоздкие математические формулы, промежуточные выкладки и длинные доказательства теорем.
Парадигма ансамбля: «комната ярких учеников»
Самый интересный практический вывод из релиза Violetto — концепция высокочастотных рассуждений (High Frequency Reasoning).
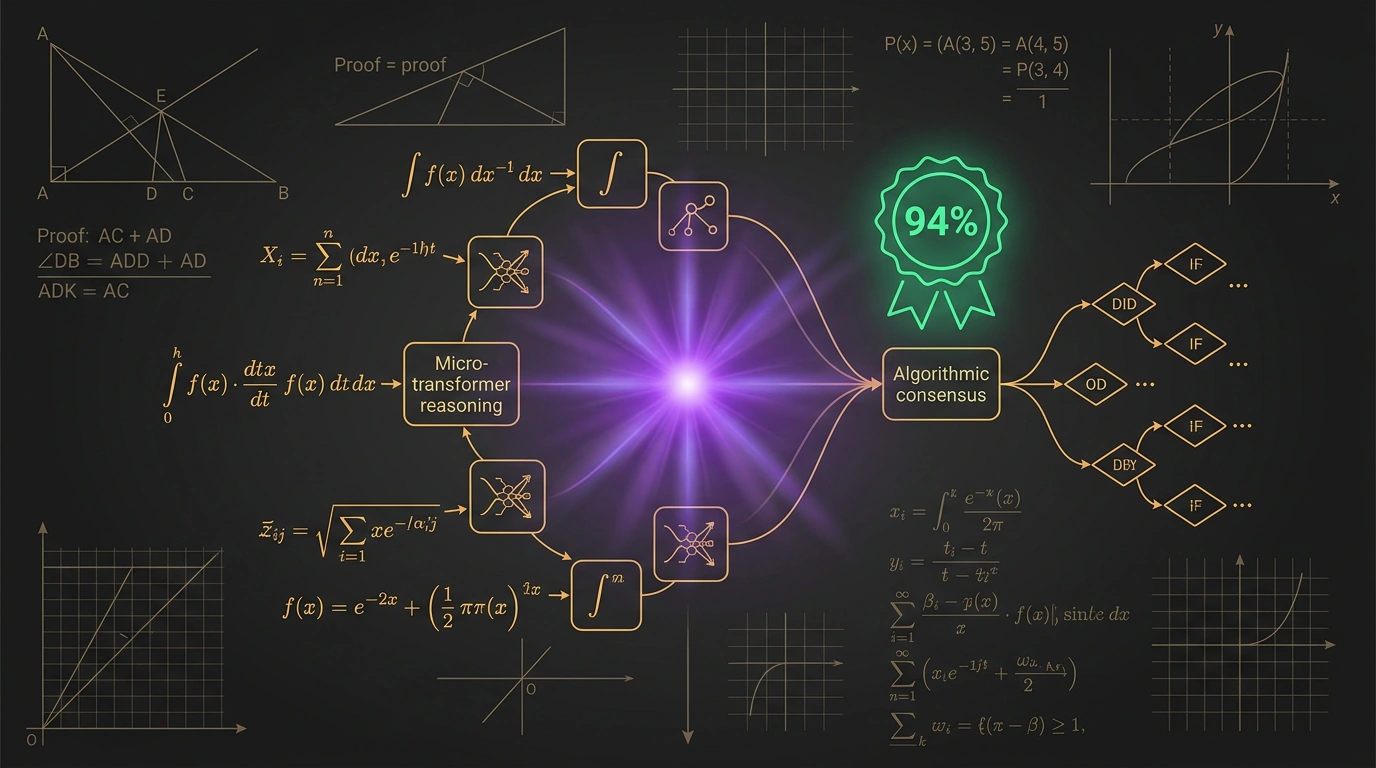
Вместо того чтобы отправлять сложную задачу в монолитную 70B-модель и ждать полминуты генерации единственной длинной цепочки, архитектура Paradigma предлагает альтернативный подход. За счет того, что модель 1B требует всего ~2 ГБ VRAM и работает с огромной скоростью, система запускает параллельный ансамбль из 6–8 независимых экземпляров Violetto.
Каждая копия модели генерирует собственную траекторию доказательства. Затем легковесный алгоритмический судья сопоставляет полученные формулы и числовые ответы, выбирая консенсусный результат. Такой ансамбль работает на обычной потребительской видеокарте или процессоре ноутбука Apple Silicon быстрее и надежнее, чем один тяжеловесный облачный гигант.
Границы применения и практический вывод
При всей своей мощи Limite 1B — строго специализированный инструмент. Это не диалоговый ассистент: модель не проходила классический instruction-tuning для поддержания светской беседы. Если задать ей обычный житейский вопрос, она попытается найти в нем математическую пропорцию или уравнение (scope drift).
Однако для инженерных задач, символьных вычислений, проверки алгоритмов и верификации кода релиз Paradigma доказывает: будущее ИИ принадлежит не только колоссальным дата-центрам, но и сверхэффективным локальным моделям.