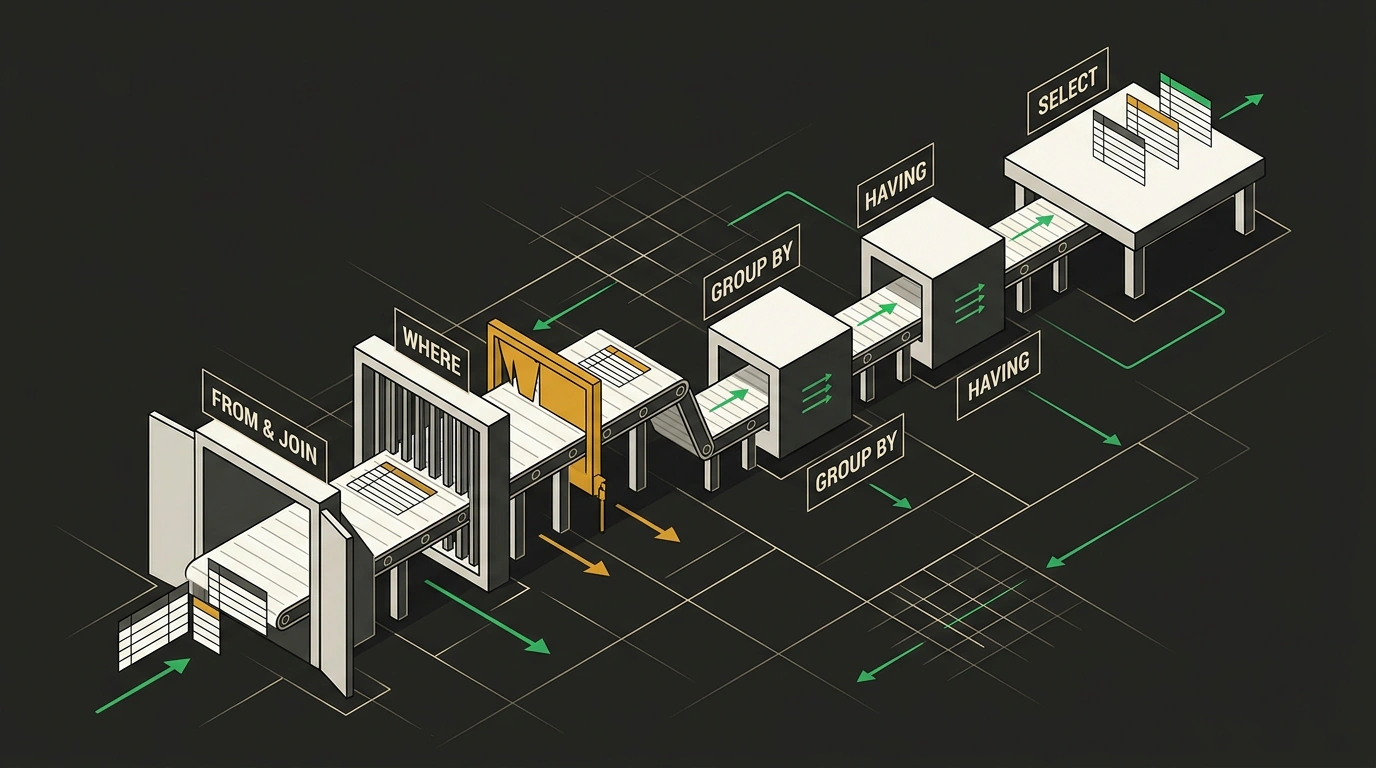

В большинстве языков программирования код исполняется ровно так, как написан: сверху вниз, строка за строкой. Однако в SQL все иначе. Это декларативный язык: разработчик формулирует, что он хочет получить, а движок СУБД решает, как это извлечь. Из-за этого порядок написания команд кардинально расходится с внутренним логическим конвейером обработки данных (Logical Query Processing).
Хотя любой запрос на чтение начинается со слова SELECT, движок базы данных (PostgreSQL, MySQL, Oracle) начинает вычисления с другого конца:
FROMиJOIN: сбор целевых таблиц, вычисление декартова произведения и применение условийON.WHERE: построчная фильтрация строк до любых группировок.GROUP BY: разделение строк на группы по указанным ключам.HAVING: фильтрация сформированных групп по агрегатным условиям (COUNT,SUM).SELECT: расчет скалярных выражений и присвоение псевдонимов (алиасов).DISTINCT: удаление дублирующихся строк из проекции.ORDER BY: финальная сортировка (здесь алиасы изSELECTуже доступны).LIMITиOFFSET: отсечение заданного количества строк.
Почему алиасы не работают в фильтрах и где прячется цена GROUP BY
Осознание этого конвейера объясняет типичные ошибки. Классический пример: попытка написать WHERE total_amount > 1000, где total_amount — псевдоним из блока SELECT. СУБД выдает ошибку «колонка не существует», ведь на этапе WHERE (шаг 2) блок SELECT (шаг 5) еще не вычислялся.
Та же логика определяет разницу между WHERE и HAVING. Фильтрация в WHERE отсекает записи в самом начале, сокращая объем данных в памяти. Если же простые условия перенести в HAVING, СУБД потратит процессорное время на группировку миллионов строк, чтобы затем их отбросить.
Избавляемся от повторных вычислений с помощью CTE
Когда в фильтрации нужно вычисляемое поле, надежный подход — вынести логику в обобщенное табличное выражение (CTE) с ранним отсечением:
-- ОШИБКА: алиас total_price недоступен в WHERE на шаге 2
-- SELECT id, quantity * price AS total_price FROM orders WHERE total_price > 1000;

-- ЭФФЕКТИВНО: раннее отсечение статуса и декомпозиция через CTE
WITH filtered_orders AS (
    SELECT
        id,
        user_id,
        quantity * price AS total_price,
        created_at
    FROM orders
    WHERE status = 'completed' -- Шаг 2: отбрасываем лишнее до группировки
)
SELECT
    user_id,
    SUM(total_price) AS user_spending
FROM filtered_orders
WHERE total_price > 1000
GROUP BY user_id
HAVING COUNT(id) >= 2
ORDER BY user_spending DESC
LIMIT 10;
Ловушка функций в индексах и маскировка ошибок через DISTINCT
Вторая частая беда — нарушение принципа SARGability (Search Argument Able). Когда столбец оборачивают в функцию (например, WHERE EXTRACT(YEAR FROM created_at) = 2026), база не может использовать B-Tree индекс и запускает полный перебор таблицы (Sequential Scan). Предикат нужно формулировать как диапазон дат для индексного сканирования.
Не менее опасен бездумный DISTINCT. Часто разработчик замечает дубликаты после некорректного JOIN и гасит их с помощью DISTINCT. Но это маскирует ошибку связывания и заставляет базу делать тяжелую сортировку в памяти. Если нужно лишь проверить наличие связанных записей, полусоединение через EXISTS работает намного быстрее:
-- НЕЭФФЕКТИВНО: функция ломает индекс, а DISTINCT маскирует дубликаты
SELECT DISTINCT u.id, u.email
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE EXTRACT(YEAR FROM o.created_at) = 2026;

-- ОПТИМИЗИРОВАНО: полусоединение EXISTS без сортировки и диапазон дат для B-Tree
SELECT u.id, u.email
FROM users u
WHERE EXISTS (
    SELECT 1
    FROM orders o
    WHERE o.user_id = u.id
      AND o.created_at >= '2026-01-01 00:00:00'
      AND o.created_at < '2027-01-01 00:00:00'
);
Главное правило: доверяй оптимизатору, но проверяй EXPLAIN
Логический конвейер описывает стандарт языка SQL. На практике оптимизатор стоимости (Cost-Based Optimizer) в PostgreSQL может менять физические операции местами — например, проталкивать предикаты внутрь сканирования индексов, если результат гарантированно совпадает.
Поэтому сверяйте гипотезы с реальностью через команду EXPLAIN (ANALYZE, BUFFERS). Понимание логического порядка помогает отсекать узкие места еще при написании запроса, сохраняя ресурсы базы данных под высокой нагрузкой.