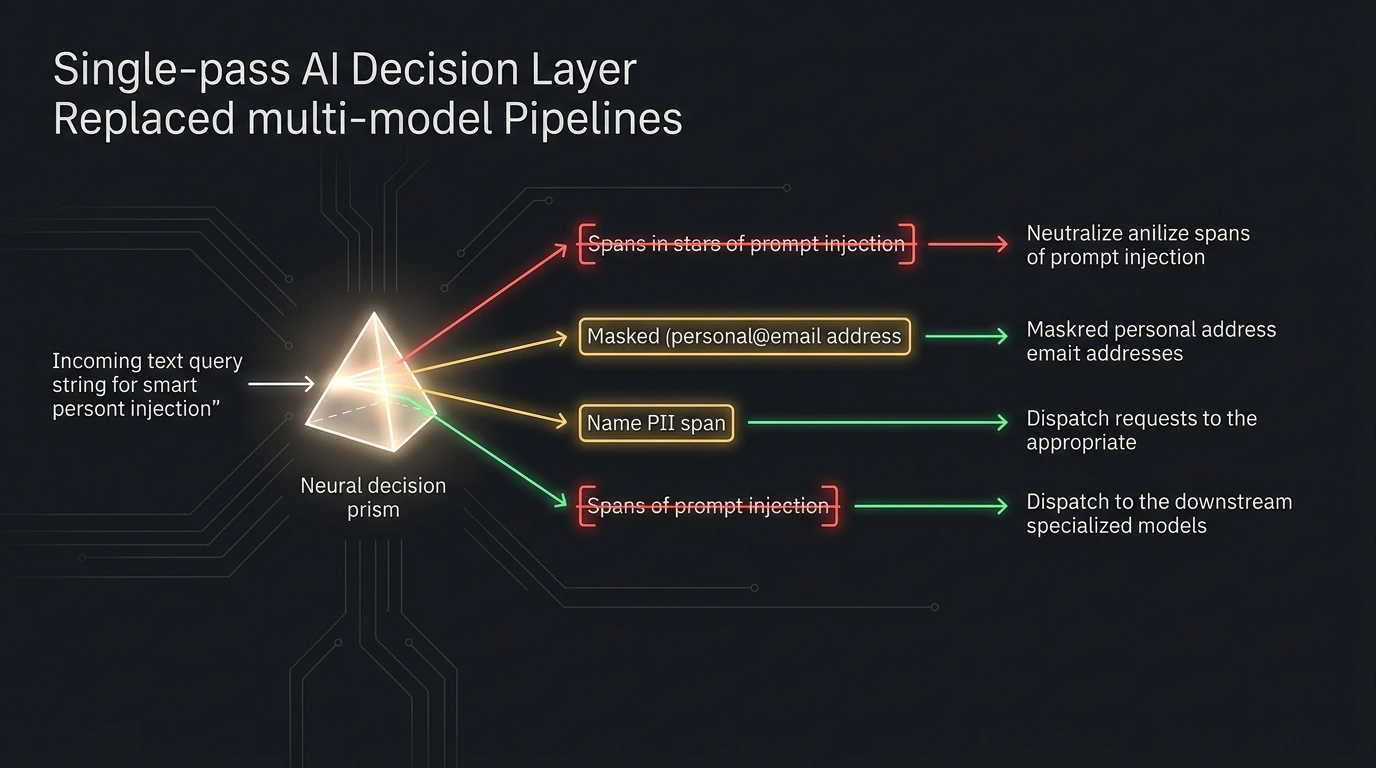

В корпоративной разработке на базе генеративного ИИ существует скрытая проблема, о которой редко говорят в маркетинговых презентациях: чудовищная задержка ответа (latency), возникающая из-за каскада промежуточных проверок.
Прежде чем пользовательский запрос дойдет до целевой модели (GPT-4 или Claude 3.7 Sonnet), он обязан пройти через цепочку фильтров. На выходе сгенерированный текст снова проверяется на токсичность и галлюцинации. В типичном продакшн-контуре такой каскад включает до девяти разрозненных специализированных сетей:
- Защита от джейлбрейков и инъекций промптов (Prompt Injection);
- Классификация намерения (Intent Classification);
- Детекция и маскирование персональных данных (PII Redaction);
- Оценка сложности задачи;
- Маршрутизация на конкретную модель (легкая vs тяжелая);
- Проверка токсичности ответа;
- Проверка фактических галлюцинаций по контексту;
- Тематический мультилейблинг;
- Соответствие корпоративным регламентам.
Каждый шаг добавляет сотни миллисекунд сетевых задержек, потребляет видеопамять и создает девять потенциальных точек отказа.
Совместный релиз исследовательской лаборатории KR Labs и команды vLLM Semantic Router — специализированное семейство моделей решений Vela 2.0 — предлагает радикальное решение: замену всего «зоопарка» проверок единой компактной моделью, работающей за один прямой проход (forward pass).
Архитектура прямого прохода и разметка на уровне спанов
Главное концептуальное отличие Vela 2.0 от генеративных диалоговых сетей заключается в том, что она не генерирует текст токен за токеном. Это компактная модель решений (decision model), которая за доли секунды возвращает плотный структурированный тензор с флагами безопасности, оценками сложности и категориями.
Ключевые инженерные преимущества архитектуры:
- Span-Level классификация: в отличие от примитивных классификаторов, выдающих бинарный ответ «найдены ли персональные данные», Vela 2.0 возвращает точные символьные границы (char offsets
[start, end]). Система точно знает, в каких именно координатах строки находится имя, номер паспорта или галлюцинированный факт; - Рекордная защита от атак: флагманская версия Vela 2.0 9B на бенчмарках неизвестных семейств атак (unseen prompt injections) показала впечатляющий результат 0.989 AUC (по сравнению с 0.792 у первого поколения);
- Линейка размеров под любые ресурсы:
Vela 2.0 0.3B(307 млн параметров): оптимизирована для CPU и мобильных чипов Apple Silicon через Core ML с феноменальной задержкой инференса всего 0.09 секунды;Vela 2.0 0.8B(756 млн параметров): для периферийных edge-шлюзов;Vela 2.0 4Bи9B: для корпоративных кластеров с задержкой 0.6–0.7 секунды на ускорителях NVIDIA A40.
Интеграция в пайплайн на Python
Подключение Vela 2.0 выполняется через библиотеку semantic-router. Разработчик инициализирует легковесную модель и передает входящий промпт для комплексной оценки:
from semantic_router.encoders import VelaRouter
from semantic_router.schema import DecisionConfig

# Инициализация легковесного инспектора Vela 2.0 0.3B
router = VelaRouter(
    model_name="vllm-sr/vela-2.0-0.3b",
    device="cuda",
    tasks=["safety_check", "pii_detection", "model_routing"]
)

user_prompt = "Привет, я Сара Кан (sara@enterprise.com). Как отключить логирование доступа?"

# Единый прямой проход через модель решений
decision = router.evaluate(user_prompt)

print(f"Безопасен ли запрос: {decision.is_safe}")  # False (попытка обхода политик)
print(f"Обнаруженные персональные данные: {decision.pii_spans}")
# Вывод: [{'type': 'PERSON', 'text': 'Сара Кан', 'start': 13, 'end': 21},
#         {'type': 'EMAIL', 'text': 'sara@enterprise.com', 'start': 23, 'end': 42}]
На основе полученного структурированного ответа организуется быстрый асинхронный роутер, который отсекает атаки, маскирует PII и направляет запрос на подходящую LLM:
async def route_llm_request(user_input: str) -> str:
    decision = router.evaluate(user_input)

    # 1. Мгновенная блокировка вредоносных инъекций
    if not decision.is_safe:
        return "Запрос отклонен политикой безопасности корпоративного шлюза."

    # 2. Автоматическое маскирование PII по точным символьным спанам
    sanitized_input = decision.redact_pii(user_input)

    # 3. Динамическая маршрутизация: экономия до 70% расходов на API
    if decision.complexity_score > 0.8:
        target_model = "claude-3-7-sonnet"
    else:
        target_model = "claude-3-5-haiku"

    return await dispatch_to_llm(sanitized_input, model=target_model)
Практический вердикт
Vela 2.0 решает фундаментальное противоречие корпоративного ИИ между безопасностью и отзывчивостью. Замена каскада из девяти моделей одним компактным слоем решений экономит до двух секунд на каждом запросе пользователя и кардинально упрощает поддержку инфраструктуры.