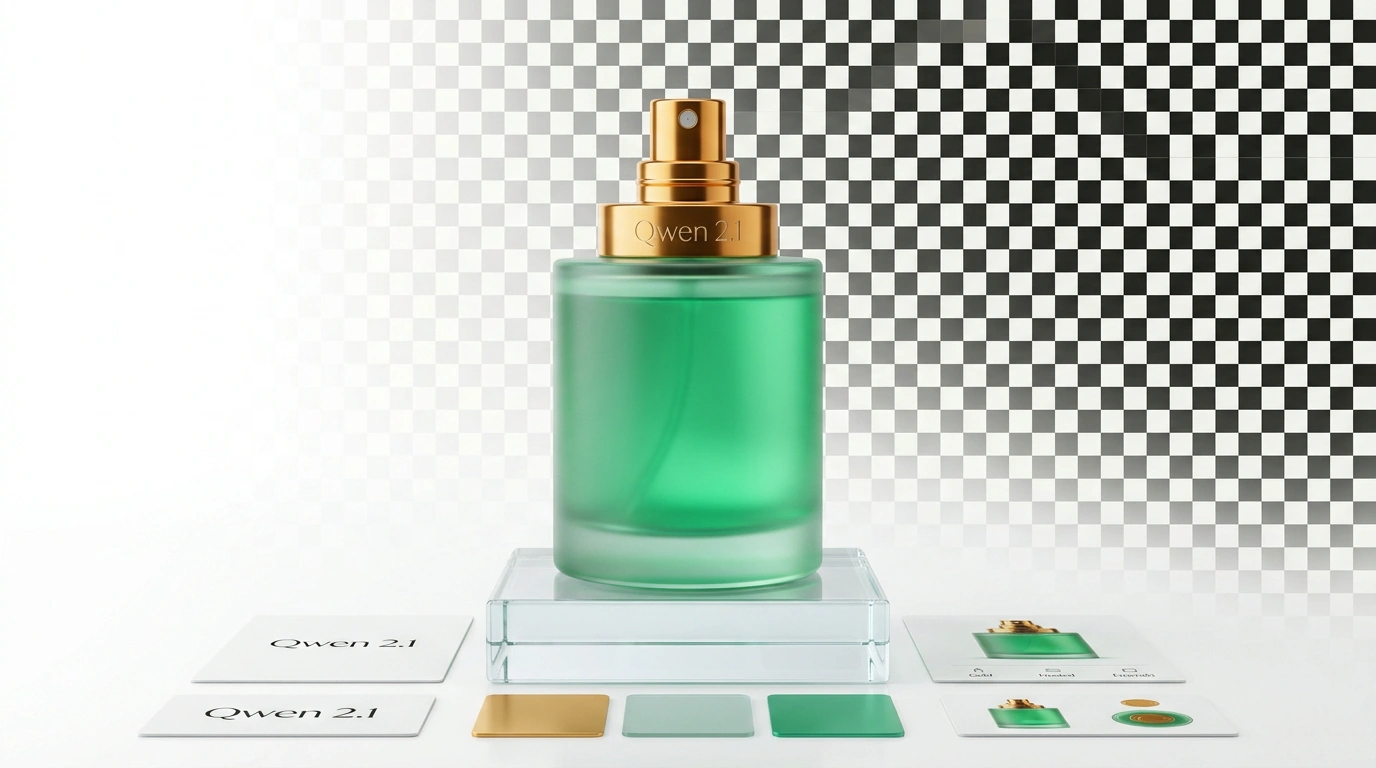

Если ты хоть раз готовил карточки товаров для интернет-магазина или верстал рекламный промо-лендинг, ты отлично знаешь эту боль. Тебе присылают фото реального флакона духов или кроссовок на пестром складе, и начинается бесконечная возня в графическом редакторе: вырезать маску, аккуратно стереть фон, попытаться сохранить тонкие полупрозрачные грани стекла или волоски меха, а потом часами бороться с «паразитной» зеленой или серой каймой по краям.
Автоматические утилиты вроде rembg или сегментационные нейросети типа Segment Anything (SAM) часто делают картинку топорной: срезают естественные блики, превращают стеклянные стенки в непрозрачный пластик и безжалостно убивают капли воды и дым. В классических диффузионных моделях вроде Midjourney или Stable Diffusion фон всегда генерируется монолитным — приходится сначала генерировать объект на белом фоне, а затем вырезать его сторонними скриптами.
Команда Alibaba выкатила открытую мультимодальную модель Qwen Image 2.1 с 7 миллиардами параметров, которая переворачивает этот пайплайн с ног на голову. Модель умеет генерировать прозрачный фон нативно прямо в процессе диффузии и способна одновременно ориентироваться на до 10 референсных изображений.
Как работает нативный RGBA VAE
Главный технологический трюк релиза кроется в архитектуре автоэнкодера (VAE). Традиционные диффузионные модели работают в трехканальном латентном пространстве ($R, G, B$) — для них прозрачности как физической величины просто не существует. Любая попытка отрезать задний план — это внешняя хирургическая операция над уже готовыми пикселями.
Инженеры Qwen внедрили 64-канальный RGBA VAE, в котором альфа-канал ($A$) кодируется и диффундирует наравне с цветовыми каналами. Модель буквально «понимает», какая часть объекта является полностью непрозрачной, где находится полупрозрачное затемненное стекло, а где пиксели должны быть абсолютно пустыми ($A = 0$).
На выходе ты сразу получаешь честный 32-битный PNG-файл без каких-либо артефактов обтравки, ореолов или фальшивых теней.
До 10 референсов: контроль геометрии и айдентики
Вторая большая проблема генеративных сетей при работе с брендами — «галлюцинации» геометрии. Если тебе нужно показать один и тот же товар в пяти ракурсах или вписать физический продукт в новый интерьер, промпт-инжиниринг обычно бессилен: флакон меняет пропорции, этикетка сползает, а шрифт превращается в эльфийские руны.
В Qwen Image 2.1 встроили механизм мультиреференсного кондиционирования. Ты можешь «скормить» сети пачку до 10 кадров одновременно:
- 3–4 снимка реального товара с разных ракурсов для фиксации геометрии;
- 2 кадра с фирменной палитрой бренда и паттернами;
- 2 примера желаемой студийной схемы освещения;
- референс позы человека или композиции кадра.
Трансформерная архитектура с перекрестным вниманием (cross-attention) сопоставляет элементы референсов и воссоздает предмет в новой сцене с поразительной точностью формы, надписей и текстуры материала.
Скрипт сборки предметной карточки через API
Покажу, как это выглядит на практике при вызове официального эндпоинта DashScope. Мы кодируем пачку референсов в Base64, задаем текстовую инструкцию и активируем режим нативной прозрачности.
import os
import requests
import base64

API_KEY = os.getenv("DASHSCOPE_API_KEY")
ENDPOINT = "https://dashscope.aliyuncs.com/api/v1/services/aigc/text2image/image-synthesis"

def encode_image(file_path: str) -> str:
    """Кодируем локальный графический референс в формат base64 data URI."""
    with open(file_path, "rb") as image_file:
        encoded = base64.b64encode(image_file.read()).decode("utf-8")
        return f"data:image/png;base64,{encoded}"

# Собираем до 10 исходных референсов (ракурсы товара, текстура стекла, студийный свет)
reference_list = [
    encode_image(f"./references/perfume_view_{i}.png")
    for i in range(1, 4)
]

payload = {
    "model": "qwen-image-2.1-turbo",
    "input": {
        "prompt": (
            "A luxury cosmetic glass perfume bottle, emerald green frosted glass with gold spray cap. "
            "Isolated subject on a completely transparent background, clean edges, studio product lighting, "
            "realistic reflections on the glass surface."
        ),
        "negative_prompt": "opaque background, white background, solid color backdrop, clipping artifacts",
        "reference_images": reference_list,
        "output_format": "rgba_png",
        "transparency_mode": "native_alpha"
    },
    "parameters": {
        "width": 1024,
        "height": 1024,
        "steps": 8,  # Ускоренный дистиллированный режим инференса
        "guidance_scale": 5.0,
        "seed": 42
    }
}

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
    "X-DashScope-Async": "enable"
}

response = requests.post(ENDPOINT, headers=headers, json=payload).json()
task_id = response["output"]["task_id"]
print(f"Генерация запущена. Идентификатор задачи: {task_id}")
После старта генерации мы опрашиваем статус фоновой задачи и забираем чистый PNG:
import time

def download_transparent_result(task_id: str, save_path: str = "product_isolated.png"):
    status_url = f"https://dashscope.aliyuncs.com/api/v1/tasks/{task_id}"
    req_headers = {"Authorization": f"Bearer {API_KEY}"}

    while True:
        task_data = requests.get(status_url, headers=req_headers).json()
        status = task_data["output"]["task_status"]

        if status == "SUCCEEDED":
            download_url = task_data["output"]["results"][0]["url"]
            img_bytes = requests.get(download_url).content
            with open(save_path, "wb") as f:
                f.write(img_bytes)
            print(f"Готово! Чистый RGBA-файл сохранен в {save_path}")
            break
        elif status in ["FAILED", "CANCELED"]:
            error_msg = task_data["output"].get("message", "Неизвестная ошибка")
            raise RuntimeError(f"Сбой генерации изображения: {error_msg}")

        time.sleep(2)

download_transparent_result(task_id)
Скорость инференса и локальный запуск
Особого внимания заслуживает режим Turbo: благодаря продвинутой дистилляции шаг сэмплирования удалось сократить всего до 8 итераций. На современных ускорителях (уровня NVIDIA RTX 4090 или серверных A100) синтез кадра в разрешении $1024 \times 1024$ занимает от 2 до 4 секунд.
Если ты планируешь разворачивать веса локально через ComfyUI или Diffusers:
- Для работы полной 7B-модели со всеми 10 активными референсами требуется около 24 ГБ VRAM.
- Если использовать квантование NF4 или GGUF, модель комфортно помещается в 12–16 ГБ VRAM, позволяя запускать студийный генератор прямо на рабочей станции разработчика.
При всей мощи архитектуры держи в голове важное ограничение: если скормить модели 10 референсов с конфликтующими стилями (например, один снимок в жестком контровом свете неонового клуба, а другой — в рассеянном полуденном солнце), внимание трансформера размывается, и результирующий объект может получить смазанные текстуры или странные пропорции. Референсы должны дополнять друг друга, а не спорить между собой.