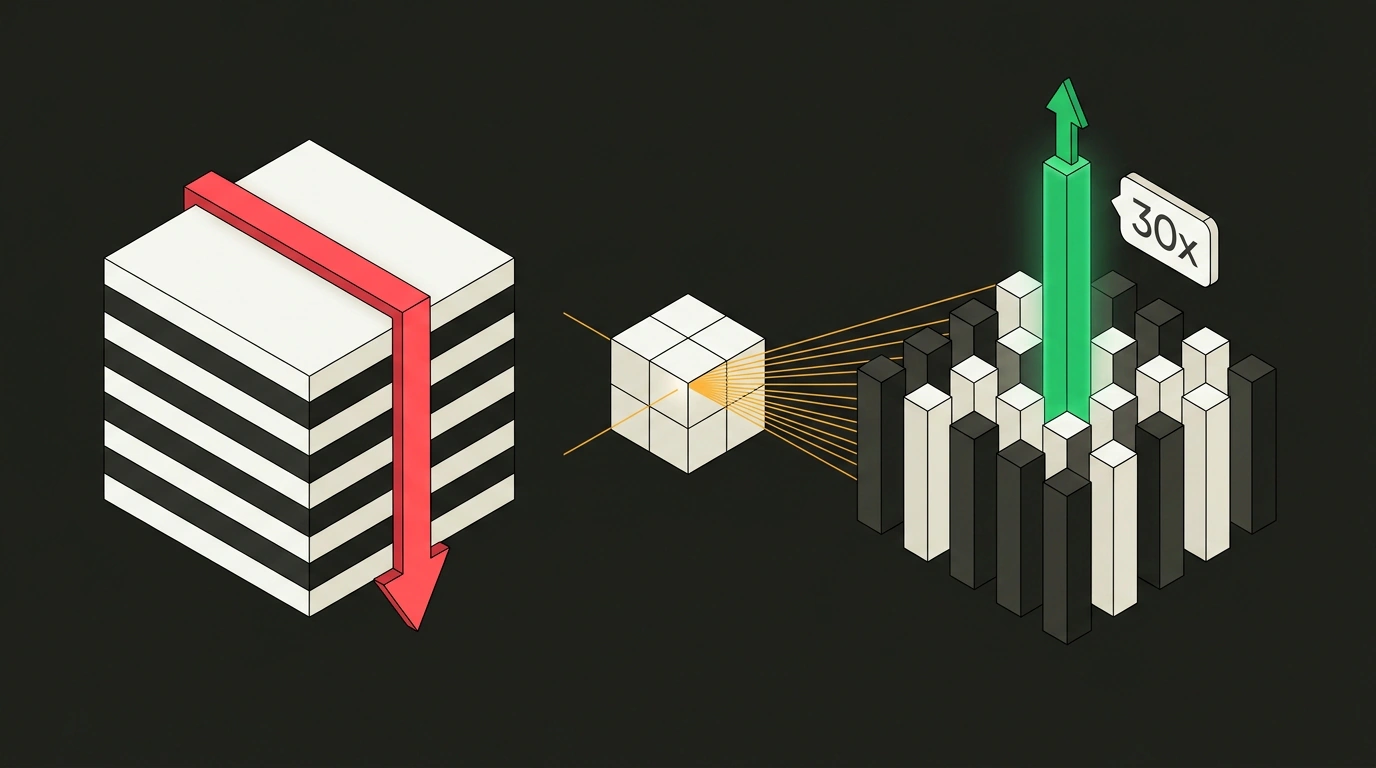

Ты наверняка не раз наблюдал эту классическую драму: вечер, пик пользовательской активности в сервисе, транзакции идут ровным потоком — и тут кто-то из аналитиков или маркетологов решает запустить «небольшой» сводный отчёт за полгода. Один неосторожный запрос с несколькими GROUP BY и тяжелыми агрегациями поднимает с диска сотни миллионов записей, вымывает буферный кэш оперативной памяти и ставит на колени весь продуктовый инстанс. Знакомо?
Я сам многократно разбирал такие инциденты и прекрасно понимаю природу этого конфликта. Классический PostgreSQL изначально проектировался как транзакционная СУБД (OLTP). Его физическое хранилище устроено построчно (heap-страницы): каждая строка содержит все свои колонки подряд, а поверх работает сложный механизм версионирования строк, о котором мы уже говорили, разбирая архитектуру heap и MVCC. Чтобы посчитать среднюю сумму чека по пяти миллионам заказов, движку приходится считывать с диска в память абсолютно все поля каждой строки — от адресов доставки до технических комментариев.
Исторически для решения этой проблемы строили сложные ETL-конвейеры: данные ночами выгружали в ClickHouse или кластеры Greenplum. Но это означало зоопарк систем, рассинхронизацию прав доступа, отдельный диалект SQL и необходимость постоянно следить за тем, чтобы репликация не отставала. Компания Postgres Professional выпустила мажорное обновление СУБД Postgres Pro AXE 2.0 (Analytical eXtension Engine), зарегистрированной в Едином реестре российского ПО под номером 104, где этот компромисс попытались устранить прямо внутри экосистемы Postgres.
Аналитические таблицы без смены привычек
Главная идея AXE 2.0 — сделать аналитические таблицы нативными гражданами СУБД. Для аналитиков и прикладных разработчиков ничего не меняется: перед тобой всё тот же привычный SQL-интерфейс, те же самые BI-коннекторы, драйверы, пулеры соединений и стандартные команды SELECT, INSERT, UPDATE и DELETE.
Однако под капотом данные таких таблиц раскладываются не в стандартные heap-блоки по 8 килобайт, а сохраняются в открытом колоночном формате Parquet с плотным блочным сжатием. Когда ты запрашиваешь сумму по одной числовой колонке, движок считывает с диска исключительно байты этого конкретного столбца. По данным разработчиков, на сложных агрегационных выборках ускорение достигает 30 раз по сравнению со стандартным построчным движком.
Каталог DuckLake: метаданные без перебора диска
Чтобы быстро ориентироваться в массивах Parquet-файлов, AXE 2.0 использует открытую спецификацию каталога метаданных DuckLake. Самое любопытное здесь то, как он реализован.
Структура таблиц, списки файлов, схемы колонок, границы партиций и контрольные суммы хранятся непосредственно в служебных heap-таблицах того же инстанса PostgreSQL. Движку не нужно последовательно обходить и парсить каждый Parquet-файл на диске, чтобы понять, какие диапазоны данных в нём лежат. Оптимизатор обращается к каталогу метаданных с транзакционной гарантией, мгновенно отсекает лишние файлы и читает только целевые блоки. Более того, внешние инструменты архитектуры Lakehouse (например, аналитический движок DuckDB) могут напрямую обращаться к этому же Parquet-слою без промежуточной выгрузки, что перекликается с подходом, который мы разбирали на примере архивирования данных в Parquet на S3.
Колоночные файлы великолепны для чтения, но дороги при частых точечных мутациях. Операция UPDATE для Parquet требует либо полной перезаписи блока, либо ведения дельта-файлов с последующим слиянием. Поэтому AXE 2.0 ориентирован на пакетную загрузку и тяжелые выборки, а не на замену операционных транзакционных таблиц с постоянными изменениями единичных записей.
Единая модель прав: без зоопарка учетных записей
Второй важный инженерный плюс — безопасность. При выносе аналитики в сторонние СУБД администраторам приходится дублировать ролевые модели (RBAC). В AXE 2.0 права доступа к операционным таблицам и аналитическим Parquet-витринам настраиваются через стандартные команды GRANT и REVOKE. Один и тот же пользователь базы может в рамках одной транзакции прочитать операционную очередь и обрасти исторической аналитикой за прошлый квартал.
Если в твоём проекте аналитика уже начала поддушивать продуктовый PostgreSQL, AXE 2.0 выглядит как прагматичный способ ускорить отчёты без необходимости разворачивать и обслуживать принципиально чуждую инфраструктуру.