В соцсетях каждую неделю вирусятся репозитории с вывесками вроде «200 секретных навыков для Claude Code» или «Сборка скиллов Андрея Карпатого». Кажется, что чем больше готовых инструкций сложить в рабочую папку ИИ-агента, тем умнее он станет. Я открыл пару таких подборок — к реальному Карпатому они не имеют отношения. Маркетологи просто нарезали общие советы из чужих твитов и упаковали их в сотни текстовых файлов.
На деле коллекционирование чужих скиллов работает наоборот: чем толще папка с подсказками, тем хуже соображает нейросеть и тем быстрее сгорает твой тариф. Автор канала David Ondrej разобрал эту болезнь — раздувание навыков (skill bloat) — и на примере своего репозитория минималистичных скиллов показал, почему шанс совпадения чужого набора с твоими задачами равен 0%. Посмотрим, как сотня файлов в .agents/skills/ выжигает память модели еще до первого вопроса и как за десять минут навести там порядок.
Как описания в каталоге навыков сжигают контекстное окно еще до старта работы
По открытой спецификации Agent Skills, которую создала Anthropic и поддерживают почти все агентские среды (Claude Code, Cursor, Codex, Hermes, Pi, OpenCode и Cloudroom), навыки хранятся в единой папке .agents/skills/ (свежие версии Claude Code тоже перешли на неё с прежней .claude/skills/, избавив от возни с символическими ссылками symlinks).
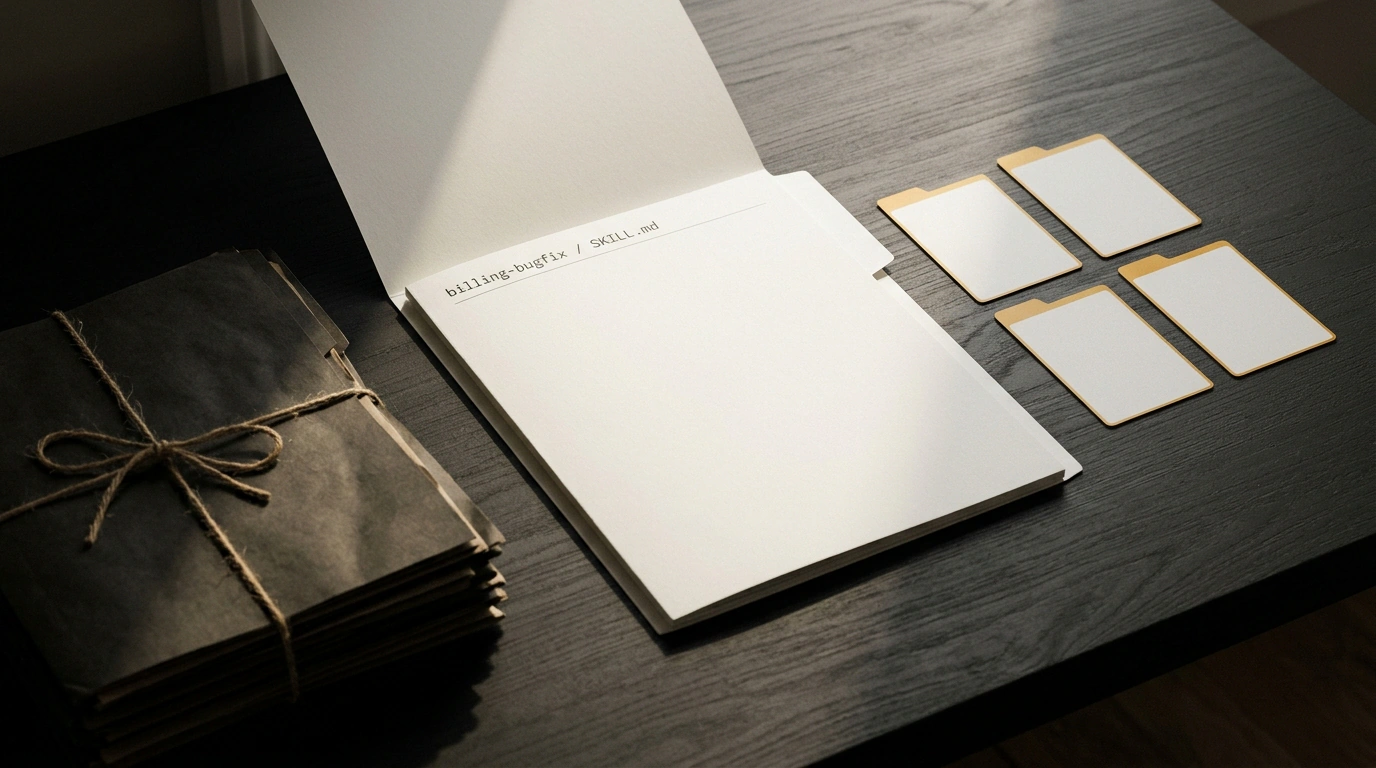
Сам навык — это папка с файлом SKILL.md, где записан стандартный операционный регламент (SOP) для повторяющейся задачи. Чтобы не забивать память нейросети, в стандарте работает пошаговое раскрытие (progressive disclosure) — как работа аналитика за столом с папками-скоросшивателями:
- Инициализация (Discovery) — на старте сессии агент читает только корешки папок: имя (
name— до 64 символов в нижнем регистре) и условие вызова (description— до 1024 символов), тратя 50–100 токенов на навык. - Активация (Activation) — когда запрос совпадает с описанием, агент открывает папку и загружает тело инструкции (
body). - Исполнение (Execution) — модель идет по шагам регламента, при необходимости вызывая скрипты из
scripts/или справку изreferences/.
Пока папок 5–10, схема работает как часы. Но когда ты клонируешь вирусный архив на 150–300 навыков, короткие заголовки по 100 токенов со старта отъедают 15 000–30 000 токенов в каждом сообщении просто за право лежать на столе. Это сжигает лимиты подписок (вроде тарифа Codex за $200) и вызывает деградацию контекста (context degradation): внимание модели рассеивается на полторы сотни чужих ярлыков вместо твоего кода.
Почему размытые триггеры приводят к ложным вызовам и галлюцинациям
Стартовый налог на заголовки — только полбеды. Обвал начинается, когда в поле description пишут размытые фразы вроде «помогает писать качественный код». Поскольку description служит единственным триггером активации, модель воспринимает это как приказ открывать папку при любом вопросе о разработке.
Посмотрим на реальную задачу: у разработчика в глобальной папке .agents/skills/ лежит 150 скачанных навыков, и он спрашивает агента: «Почему падает обработка вебхука от платежного сервиса Stripe?». До чтения лога ошибки под капотом происходит цепная реакция:
- Загрузка 150 описаний из каталога со старта съедает около 20 000 токенов.
- Увидев вопрос про код, агент цепляется за размытый триггер навыка
better-python-dev(«помогает писать качественный код на Python») и подтягивает его тело на 12 000 токенов. - Следом ложно срабатывает навык
code-cleaner, вываливая в контекст еще 8 000 токенов правил форматирования.
Итог — 40 000 токенов сгорают впустую до знакомства с багом. Схема базы данных вымывается из активной памяти, модель галлюцинирует и пытается переписать рабочие контроллеры, а разработчику приходится жать /compact.
Чтобы агент бил в цель, триггер должен быть узким. Для отладки платежей создается точечный проектный манифест .agents/skills/billing-bugfix/SKILL.md:
---
name: billing-bugfix
description: Диагностика и устранение ошибок в модулях оплаты Stripe и выставления счетов. Активировать только при сбоях вебхуков, расхождении статусов инвойсов или ошибках списания.
license: MIT
metadata:
  version: "1.2"
  scope: "project"
---

# Регламент отладки платежных сценариев

1. **Проверка вебхука**: найти событие `evt_...` в логах и сверить заголовок `Stripe-Signature` на устаревание секрета.
2. **Изоляция транзакции**: запрещены повторные списания (`retry charge`) без ключа `Idempotency-Key`.
3. **Сверка БД**: проверить статус подписки (`active`, `past_due`, `canceled`) в таблице `subscriptions`.
4. **Отчет**: вывести краткую сводку причин сбоя перед правкой кода обработчика.
В шапке YAML frontmatter поле description работает как жесткий фильтр: пока ты верстаешь интерфейс или настраиваешь маршруты, навык весит меньше сотни токенов и молчит. Но при сбое платежного вебхука агент сразу подгружает четыре шага регламента — от проверки Stripe-Signature и защиты через Idempotency-Key до сверки таблицы subscriptions.
Когда разработчик удалил 150 чужих папок, оставив этот узкий проектный файл и 4 глобальных навыка, стартовый расход контекста упал более чем в 5 раз — с 40 000 до 650 токенов. Агент мгновенно вызвал billing-bugfix, нашел просроченный секрет подписи и выдал патч за 45 секунд. О добавлении автотестов к таким файлам мы писали в разборе самосовершенствующихся навыков для ИИ-ассистентов, а правила изоляции триггеров разобраны в 6-шаговом фреймворке проектирования Codex Skills.
Пять базовых навыков на каждый день и границы их изоляции
Что тогда стоит держать в глобальной папке ~/.agents/skills/, влияющей на каждый чат? По опыту Дэвида Ондрея, там нужны всего 4–5 коротких навыков управления самим процессом работы:
gpt-review(перекрестное ревью) — после средних и крупных правок от Claude Opus 5.5 запускает субагента в другом харнесе на флагмане конкурирующей лаборатории (OpenAI GPT Astra). Взгляд второй frontier-модели отлавливает до 95% багов без громоздких CI/CD-проверок на каждый пуш.deep-api(единый шлюз данных) — заменяет десяток отдельных интеграций и ключей (Firecrawl, Apify, почта) одной точкой входа для веб-поиска, глубокого ресерча и парсинга GitHub или X.state(сводка по потоку) — рукописный навык из пары строк: «Простым языком напомни, что мы делаем в этом треде и на сколько процентов готова задача». При работе в 5–10 параллельных потоках команда/stateза секунды возвращает контекст в двух предложениях.stop-overthinking(фильтр паранойи) — на максимальном уровне рассуждений (max reasoning effort) модели склонны находить в чистом коде вымышленные проблемы с шансом один на миллиард и писать по 200 строк лишних тестов. Навык включает режим прагматика: из 9 замечаний он оставляет 1–2 реально критических блокера, а остальные 7–8 фантазий отсекает.show-designs(рендеринг UI в чате) — за 2–3 минуты выводит прямо в окно чата 4 визуальных варианта компонента, экономя 15–20 минут на поднятии dev-сервера (ручной тест в браузере остается лишь для 10% сложных интерактивных фич).
Все предметные навыки должны жить строго внутри репозитория проекта (<repo>/.agents/skills/). Когда ведущий инженер или финансист упаковывает свой процесс в проектный SKILL.md, новый сотрудник при клонировании кода получает обученного агента и входит в ритм за неделю вместо пары месяцев.
Не копируй файлы SKILL.md от незнакомых авторов в локальную папку .agents/skills/: внутри легко спрятать prompt-инъекцию, которая заставит открытую модель слить твой .env с ключами на чужой сервер. А разовые тяжелые проверки от надежных вендоров вроде Security Audit Skill от Cloudflare запускай однократно через облачного агента в изолированной песочнице (Cloud Sandbox в бесплатном open-source редакторе Cloudroom) — она отработает даже при закрытой крышке ноутбука и не засорит локальный каталог.
Сделай ревизию своей папки прямо сегодня без ручной переборки файлов. Открой агентский редактор, включи флагманскую модель (Opus 5.5 или актуальную GPT) на высоком уровне рассуждений (high или max) и попроси просканировать историю всех твоих сессий во всех харнесах, чтобы вывести список самых редко используемых навыков. Сам запрос ничего не удалит, но покажет реальную картину: смело стирай 80–90% балласта — если редкий шаблон однажды понадобится, нейросеть соберет его под твою задачу за полминуты.