Снаружи кажется, что безопасность данных в финтех-сервисе целиком держится на бэкенде: контроллеры проверяют права, а ORM дописывает к запросам фильтрацию по дате. Но на изнанке работы с базой открывается тихая лазейка: помимо основного приложения к таблицам напрямую обращаются витрины отчётности, BI-дашборды и сотрудники с консолью psql.
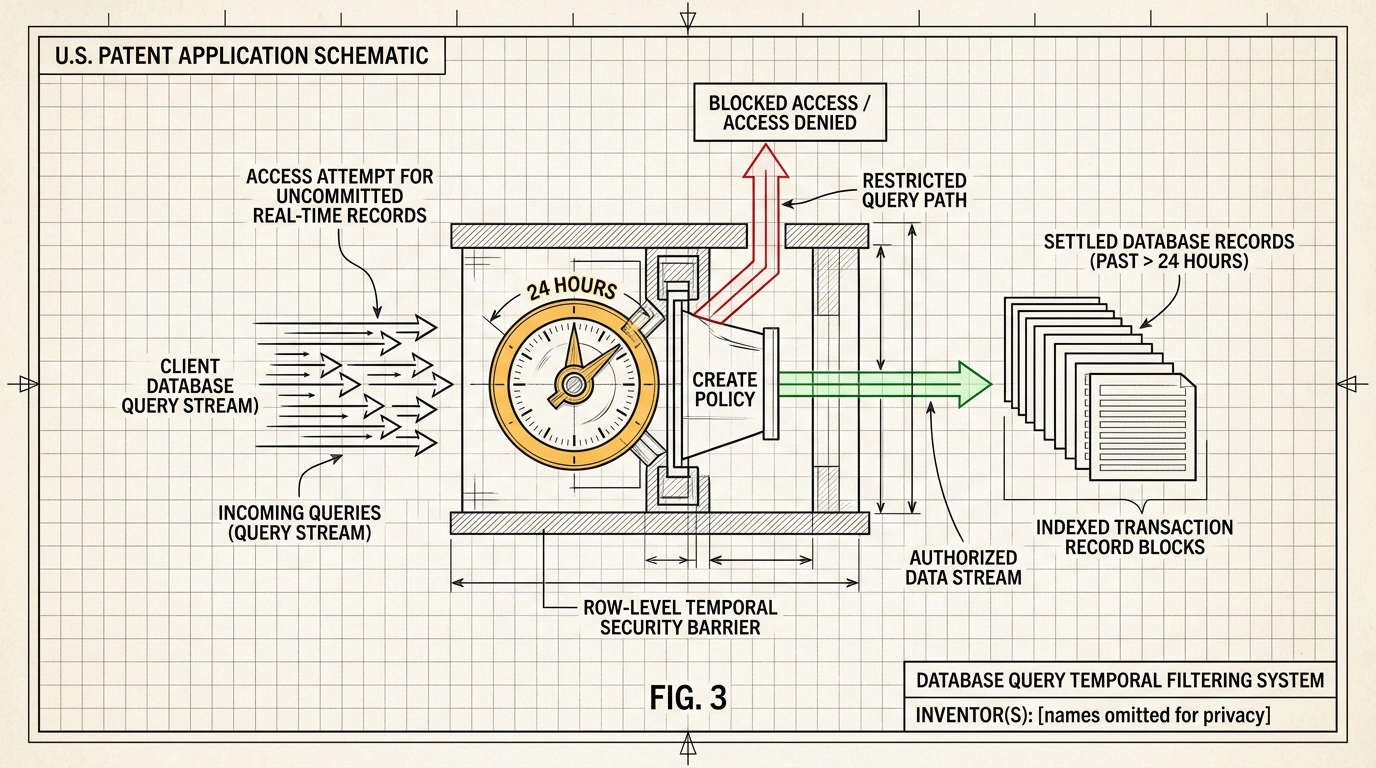
В разборе SQL Portal показана задача финтех-компании: аналитикам нужен доступ к таблице транзакций transactions, но строго с задержкой в 24 часа для защиты от фрода и инсайдерской торговли. Как запретить чтение свежих строк средствами самой СУБД, чтобы ни один прямой SQL-запрос не обошёл карантин? Задачу решает паттерн Temporal RLS — политики построчной безопасности PostgreSQL с условием по времени.
Почему фильтры в коде и витринах пропускают прямые запросы
Привычный путь — добавить условие WHERE transaction_time <= now() - interval '24 hours' в код сервиса или настроить фильтр в BI-системе. Беда в том, что такое ограничение живёт только внутри конкретного клиента. Стоит аналитику подключиться к базе через SQL-клиент для разовой выгрузки или настроить дашборд напрямую к таблице transactions, как прикладные фильтры остаются в стороне, а в выборку попадают операции, совершённые секунду назад.
Спрятать таблицу за представлением (VIEW) тоже не всегда спасает: при отладке отчётов кто-нибудь легко выдаёт прямой SELECT на исходную таблицу или создаёт админское представление без режима security invoker. Чтобы защита не зависела от внимательности людей, правило должно переехать внутрь самой таблицы — туда, где ядро базы проверяет каждую строку перед отдачей.
Встроенный фильтр времени и принудительный режим для владельца
Построчный контроль доступа (Row-Level Security, RLS) работает как автоматический фильтр на выходе из таблицы: ты один раз задаёшь правило для роли, и планировщик сам добавляет условие к любому запросу. Я сверил синтаксис с документацией PostgreSQL — посмотри, из каких трёх команд складывается суточный карантин для роли аналитиков analysts на таблице transactions с колонкой времени transaction_time:
ALTER TABLE transactions ENABLE ROW LEVEL SECURITY;
ALTER TABLE transactions FORCE ROW LEVEL SECURITY;

CREATE POLICY delay_24h ON transactions
    FOR SELECT
    TO analysts
    USING (transaction_time <= now() - interval '24 hours');
Первая команда включает построчную фильтрацию, а третья создаёт политику delay_24h: выражение в USING проверяет, что время записи отстаёт от старта транзакции now() минимум на 24 часа. Теперь аналитик отправляет обычный SELECT * FROM transactions; из psql или BI-панели и без единого WHERE получает только записи старше суток.
Вторая строка — FORCE ROW LEVEL SECURITY — закрывает важную брешь. По умолчанию владелец таблицы (table owner) читает все строки в обход любых политик. Если скрипты или витрины ходят в базу под учётной записью владельца схемы, без FORCE барьер для них не сработает. Принудительный режим оставляет обход только суперпользователям (SUPERUSER) и ролям с правом BYPASSRLS. Сами DDL-команды живут в миграциях Git и проверяются в автотестах, как мы разбирали в обзоре инструментов тестирования RLS в реальной базе.
Индексы по времени и тонкости комбинирования правил
Не вызовет ли такая проверка полный перебор таблицы (Seq Scan) на миллионах строк? Выручает форма условия transaction_time <= now() - interval '24 hours'. Колонка transaction_time стоит слева без обёрток из функций, а now() возвращает константу времени транзакции, поэтому оптимизатор использует стандартный B-Tree индекс по transaction_time и отсекает свежие данные за миллисекунды.
При развитии схемы важно помнить о двух деталях. Во-первых, по умолчанию PostgreSQL склеивает несколько политик через OR. Если к задержке по времени нужно добавить фильтр по филиалу, вторую политику объявляют как AS RESTRICTIVE, чтобы условия связывались через строгое AND и не открывали свежие строки своего региона. Во-вторых, скрытые записи продолжают участвовать в проверке внешних ключей, поэтому каскадное удаление связанной строки вернёт ошибку, если на неё ссылается сегодняшняя транзакция.
Перенос временных правил в схему БД убирает дублирование проверок в сервисах и коннекторах. И в конечном счёте вся эта строгая инженерия нужна ради простой человеческой вещи — спокойствия: когда база сама держит периметр, тебе не приходится гадать, не забыл ли кто-то одну строчку WHERE в очередном отчёте.