Принято считать, что NVIDIA — это прежде всего продавец «железа» с закрытой экосистемой: ставишь стойки с картами, накатываешь обычный Kubernetes и запускаешь обучение. Но в дата-центре всё упирается в программную оркестрацию кластера, где типовые облачные инструменты слепнут на первой же аппаратной ошибке.
На KubeCon + CloudNativeCon North America 10 ноября компания выложила на GitHub под лицензией Apache 2.0 два ядра платформы DSX AI Factory: оркестратор NVKE (NVIDIA Kubernetes Environment) и рантайм NVKR (NVIDIA Kubernetes Recipes). Я изучил репозитории и разбор Джулиана Голди, чтобы выяснить, почему базовый Kubernetes буксует на фермах видеокарт и как открытый стек решает эту проблему.
Почему стандартный Kubernetes теряется в плотных GPU-кластерах
Обычный Kubernetes создавался как диспетчер курьеров для независимых веб-серверов: если у одного спустило колесо, диспетчер просто передаёт заказ другому.
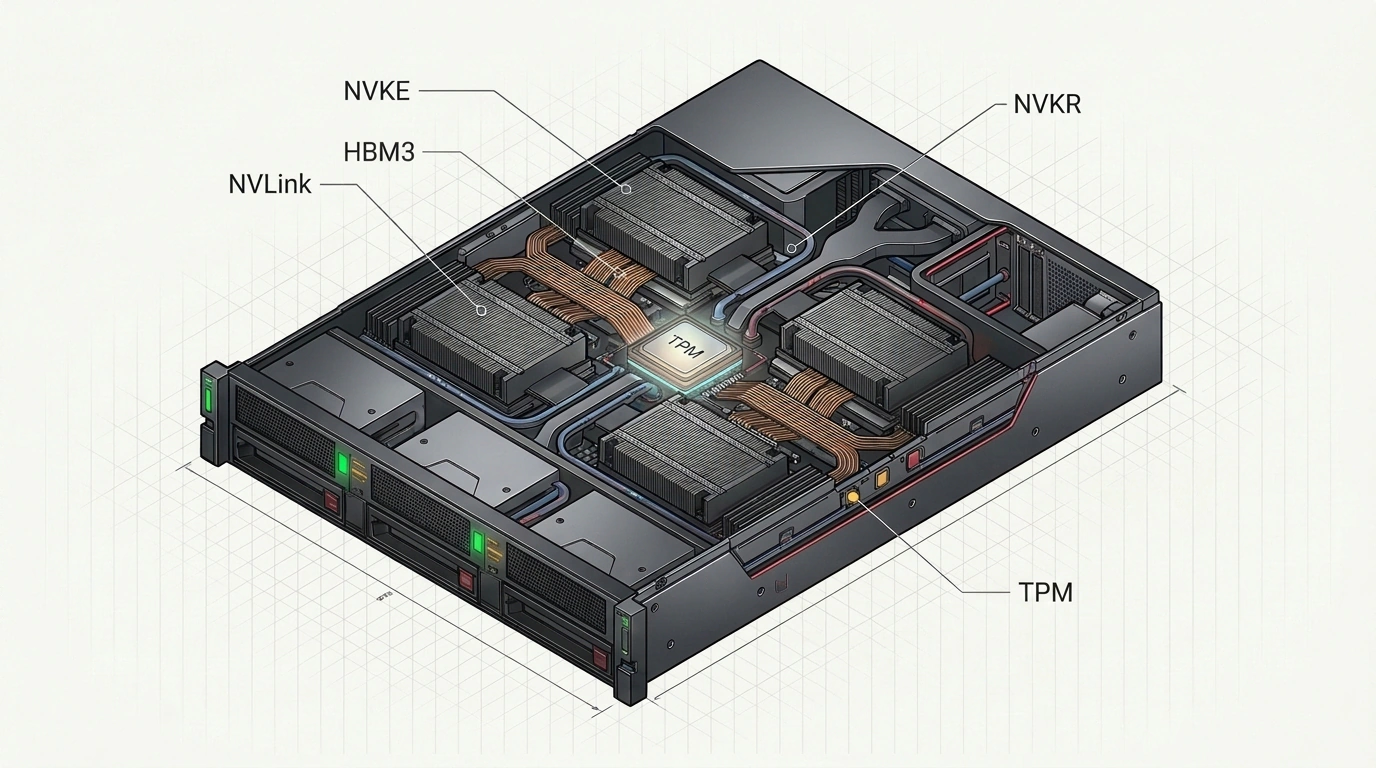
Распределённое обучение модели устроено как синхронный гребной экипаж, где десятки тысяч ядер CUDA связаны шинами NVLink и каждую миллисекунду сверяют шаги. Базовый планировщик слеп к перегреву чипов, деградации шин NVLink и сбоям памяти HBM3: ошибка одной карты обрывает многодневный расчёт на всех 64 узлах.
Архитектура NVKE и NVKR: изоляция, криптография TPM и живая телеметрия
Открытый стек делит задачу на два слоя. Оркестратор NVKE по API разворачивает кластеры на базе CNCF Kubernetes (kubeadm и Cluster API), выделяя каждому арендатору изолированный control plane, свою базу etcd и пулы узлов.
При входе в кластер сервер проходит аппаратный фейсконтроль: криптографический чип TPM (модуль с цифровым слепком железа) через протоколы SPIFFE и SPIRE подтверждает подлинность прошивки. За состоянием карт следят OpenTelemetry и агент NVIDIA NVSentinel. Посмотрим на манифест cluster-definition.yaml:
apiVersion: nvke.nvidia.com/v1alpha1
kind: WorkloadCluster
metadata:
  name: ai-factory-training-01
  namespace: tenant-deeplearning
spec:
  kubernetesVersion: "1.31.2"
  controlPlane:
    replicas: 3
    etcdEncryption:
      enabled: true
  security:
    attestation:
      provider: "spiffe-spire"
      requireTPM: true
  nodePools:
    - name: h100-compute-pool
      replicas: 8
      instanceType: "gpu.hgx.h100.8x"
      gpuConfig:
        nvlinkMonitoring: true
        nvsentinelAutoEvict: true
Параметр requireTPM: true отсекает узлы без аппаратного паспорта, а флаги nvlinkMonitoring: true и nvsentinelAutoEvict: true страхуют 64-узловой кластер. Когда NVSentinel фиксирует ошибки памяти HBM3 на третьем ускорителе узла, NVKE сохраняет контрольную точку (checkpoint), изолирует сбойный сервер и перезапускает расчёт на резервном узле без обрыва сессии.
Второй компонент — рантайм NVKR — развивает подход декларативных профилей NVIDIA AICR. По рецептам он собирает воспроизводимые образы ОС, контейнеры и Helm-чарты под amd64 и arm64, фиксируя версии драйверов и снабжая релиз подписью и паспортом состава пакетов SBOM (Software Bill of Materials).
Локальный тест-драйв без видеокарт и трезвый расчёт ограничений
Для проверки стека стойка с H100 не нужна: эмулятор контроллера NICO (NVIDIA Infrastructure Controller) позволяет развернуть макет флота на обычном ноутбуке. Поднимем стенд, создадим кластер утилитой nvkectl и проверим подпись сборки:
git clone https://github.com/dsx-ai-factory/nvkr.git
cd nvkr && ./quickstart.sh
nvkectl populate-site --config site-config.yaml
nvkectl create-cluster --file cluster-definition.yaml
nvkr release verify --artifact nvke-workload-v1.0.tar.gz
Скрипт ./quickstart.sh поднимает контур с моковой версией NICO, команды nvkectl создают кластер и выдают kubeconfig, а nvkr release verify сверяет криптографический SBOM архива. Заодно на KubeCon компания передала в CNCF песочницу прав агентов OpenShell и планировщик KAI Scheduler, а также показала утилиту Snapshot, сократившую старт моделей на Crusoe Cloud с 8 минут до 31 секунды.
Но давай честно взвесим плату за удобство. Оба пакета вышли в статусе Public Preview: API и настройки ещё меняются, и сама NVIDIA не рекомендует их для продакшена. К тому же NVKE не заменяет физический контроллер NICO и не хостит образы за оператора. Не спеши сносить ради новинки рабочие серверы — разумнее спокойно обкатать эмуляцию на ноутбуке, пока стек дозревает в облаках партнёров вроде SK Telecom, Firmus и Mirantis.