Когда набираешь в терминале команду wrangler d1 create "demo-01", уже через 1,614 секунды консоль сообщает, что база данных готова принимать запросы в европейском регионе WEUR. Со стороны кажется, будто на сервере просто появился пустой файл, но за эти полторы секунды запрос успевает сверить квоты, поднять изолированный вычислительный актор поближе к тебе и записать маршрут так, чтобы ни один будущий SELECT или INSERT никогда не обращался в центральный реестр.
Инженеры Дэвид Лабан и Ламброс Петру раскрыли устройство плоскости управления Cloudflare D1. Меня в их разборе зацепил главный вопрос: как координировать миллионы отдельных баз SQLite на периферийных серверах по всему миру и не тормозить каждый запрос проверками в едином центре?
Почему центральный координатор превращается в тромб при миллионах баз
Классические веб-сервисы опираются на один-два крупных кластера реляционной СУБД с общим пулом соединений, где клиенты делят единые таблицы. Но платформы вайбкодинга и ИИ-агенты вывернули эту модель наизнанку: теперь сервисы создают отдельную базу под каждого пользователя, дашборд или превью-окружение. Как отмечает Джон Абрамс из команды ChatGPT Sites в OpenAI, их платформа позволяет пользователям на лету собирать интерактивные сайты, игры и дашборды с таблицами лидеров и комментариями, где за каждым проектом стоит собственная микробаза D1.
К 8 октября 2026 года число живых баз в D1 выросло в 15 раз за год и в 65 раз за два года, а количество активных баз в сутки увеличилось за год в 18 раз — до сотен тысяч одновременно работающих инстансов. На таком масштабе централизованный координатор неизбежно ложится по трем причинам:
- Сетевая задержка: если перед локальным SQL-запросом в Токио система летит за маршрутом в центральный кластер Postgres в США, к субмиллисекундному чтению из SQLite добавляются сотни миллисекунд сети.
- Блокировки соединений: попытка обернуть создание базы в единую транзакцию Postgres удерживает соединение открытым, пока удаленный узел инициализируется на другом конце планеты.
- Эффект «громоподобного стада» (thundering herd): при сбросе кэша миллион активных баз одновременно атакует центральную СУБД запросами маршрутизации, вызывая каскадный отказ.
Чтобы разорвать этот круг, Лабан и Петру разделили систему на три независимых контура:
- Горячий контур данных (Data Plane) выполняет SQL-запросы (
SELECT,INSERT,UPDATE) строго на периферии (edge) и в штатном режиме никогда не обращается к центральному PostgreSQL. - Плоскость управления (Control Plane) отвечает за редкие административные вызовы (создание, удаление, списки баз, бэкапы и Time Travel) и может обращаться к центральным дата-центрам (Core).
- Фоновый асинхронный контур (Background Asynchronous Plane) считает объем диска и количество строк через очереди по модели конечной согласованности (eventual consistency).
Вынос метаданных с горячего пути: связка Durable Objects, Workers KV и Eyeball Worker
Проследим путь базы demo-01 от создания до рабочего запроса. Физически каждая база D1 — это один экземпляр SQLite Durable Object (DO): однопоточный актор в изолированном движке V8 с локальным файлом SQLite на диске периферийного сервера. Однопоточная обработка исключает гонки данных при записи без распределенных блокировок. (О том, как сам движок обеспечивает надежность внутри файла, мы рассказывали в разборе архитектуры SQLite и журнала WAL.)
При вызове wrangler d1 create "demo-01" ближайший шлюз Edge API Worker проверяет лимит баз аккаунта через прокси Hyperdrive и пересылает запрос в дата-центр рядом с кластером Postgres, сводя служебные раундтрипы к паре миллисекунд. Чтобы сама база поселилась рядом с пользователем, воркер делает внутренний вызов обратно в дата-центр вблизи клиента, генерирует UUID базы, получает уникальный ID актора через newUniqueId() и вызывает init(options) на новом Durable Object. Генерация newUniqueId() вместо обращения по имени избавляет прокси от лишнего сетевого похода за метаданными пространства имен. После инициализации актора Edge API Worker пишет строку в мастер PostgreSQL («точка фиксации создания»), а в фоновом блоке waitUntil() дает сигнал актору записать маршрут «UUID базы → ID актора» в хранилище Workers KV.
Когда твое приложение шлет SQL-запрос к demo-01, он идет по одному из двух путей в обход Postgres:
- Через
D1 Worker Binding: сервисная привязка к внутреннему проксиEyeball Workerуже хранит зашитые права доступа и координаты базы. Запрос летит из пользовательского воркера вEyeball Workerи сразу в нужный Durable Object без поиска маршрута в кэшах. - Через HTTP API: шлюз
Edge API Workerпроверяет права и читает маршрут из локальногоWorkers KV. В отличие от кэша в памяти,Workers KVхранит данные на диске периферийного узла, защищая Postgres от лавины запросов при сбросе кэша. Лишь при редком промахе воркер идет через двухступенчатый кэшHyperdriveк репликам Postgres и передает запрос черезEyeball Workerв Durable Object.
Поскольку Workers KV работает по модели конечной согласованности, параллельная запись из разных мест привела бы к путанице версий. В D1 правом записывать и удалять свои маршруты в Workers KV обладает только сам однопоточный актор Durable Object.
Самовосстановление через 30-секундные хартбиты, целостность WAL и фоновый контроль квот
Если при создании базы Durable Object A на периферии уже поднялся, а запись в центральный Postgres оборвалась, цикл повтора создает новый Durable Object B с другим ID и фиксирует в Postgres именно его.
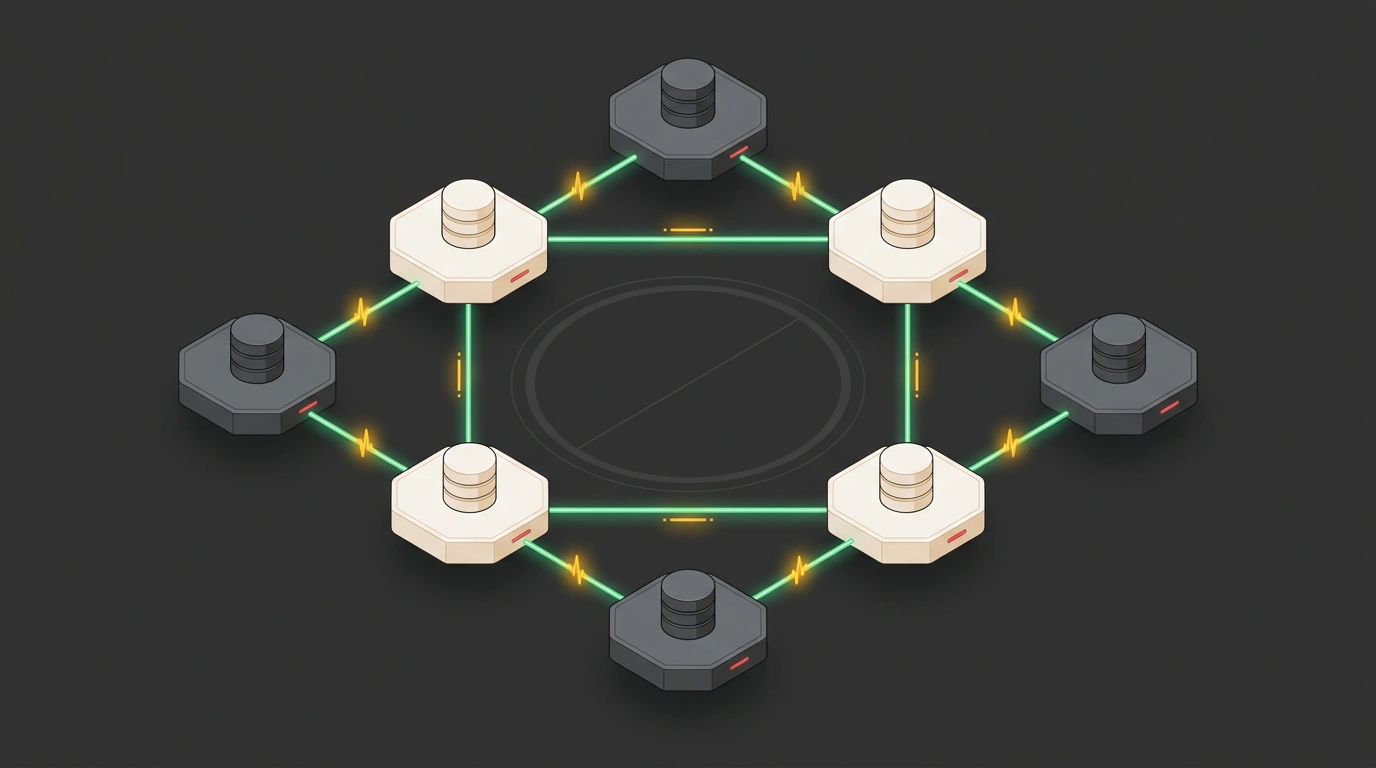
Чтобы «осиротевший» объект A не висел в системе, каждый активный Durable Object каждые 30 секунд (со случайным сдвигом jitter) шлет хартбит через кэш Hyperdrive к читающим репликам Postgres. В первые же 30 секунд объект A узнает, что его нет в реестре, помечает себя удаленным и очищает ресурсы. По этому же пульсу акторы узнают об удалении базы и чинят записи в Workers KV, если при старте сбойнул waitUntil(). На диске же надежность транзакций, чтение с реплик и восстановление (Time Travel) опираются на журнал предзаписи SQLite (WAL) и слепки без блокировки соседей.
Контроль квот диска (5 ГБ на тарифе Free и 1 ТБ на Workers Paid) тоже убран в фон. Считать SELECT sum(storage) по миллиону баз на лету слишком дорого, а обновлять одну строку аккаунта при каждой записи — значит создать очередь блокировок. Поэтому D1 использует пакетное схлопывание дельт:
- Акторы шлют изменения объема в Kafka-подобную очередь, консьюмеры пишут размеры в
database_stats, а триггер добавляет дельту в буферную таблицуaccount_database_stats_changes. - Раз в секунду фоновый джоб забирает дельты атомарным запросом
WITH updates AS MATERIALIZED (DELETE FROM account_database_stats_changes RETURNING *), суммирует их поaccount_idи однимINSERT ... ON CONFLICT DO UPDATEобновляетaccount_database_stats. - В 30-секундном хартбите актор читает эту сумму через
HyperdriveзапросомSELECT storage, $2 as dynamic_ttl FROM account_database_stats WHERE account_id = $1. Отсутствиеdatabase_idпозволяет миллиону баз аккаунта делить один ключ кэша, а полеdynamic_ttl(Math.floor(Date.now() / (X * 1000))) обновляет ключ каждыеXсекунд вместо стандартных 60.
Для суточных лимитов по строкам на тарифе Free акторы шлют счетчики чтений и записей в ClickHouse. Сервис Limiter находит перебравшие квоту аккаунты с начала дня (toStartOfDay(now())) и ставит флаг блокировки в Quicksilver — глобальном KV-хранилище с субсекундной репликацией на периферию, где акторы мгновенно видят запрет без участия Postgres.
Границы применимости архитектуры D1 и куда движется паттерн микробаз
У схемы «один актор SQLite на клиента» есть четкие инженерные границы:
- Где решение работает как часы: платформы вайбкодинга, песочницы ИИ-агентов, мультиарендные SaaS с изоляцией клиентов и CI/CD превью-ветки, где базу нужно поднять за полторы секунды и не платить за простой.
- Где подход не годится: монолитные аналитические хранилища (OLAP) с выборками по миллиардам строк и системы со сквозными ACID-транзакциями между десятками клиентов — сделать прямой
JOINповерх тысячи файлов SQLite нельзя. (Для разгрузки классических монолитных баз лучше подходят ин-мемори витрины, которые мы разбирали на примере связки PostgreSQL и Tarantool.) - Цена конечной согласованности: из-за очередей и кэша хартбитов блокировка при превышении квоты диска срабатывает с задержкой до нескольких минут, а после долгого простоя первый запрос требует времени на «холодный старт» изолята V8.
Архитектура D1 показывает тренд облачной инфраструктуры: переход от гигантских общих кластеров к флоту легких изолированных микробаз. Авторы отмечают, что бесконтактная для Postgres схема контроля лимитов через ClickHouse и Quicksilver оказалась настолько удачной, что в будущем на нее переведут и остальные механизмы квотирования. А сам паттерн выноса координатора с горячего пути и секундной агрегации дельт через буферные CTE-таблицы отлично ложится в любой высоконагруженный бэкенд.