Когда речь заходит о безопасности автономных ИИ-агентов, которым доверяют писать и запускать код в терминале, поначалу путаются почти все. Кажется, что у изоляции есть лишь два крайних состояния: либо алгоритм намертво заперт в виртуальной коробке, либо он вот-вот взломает ядро сервера, как хакер из кино. Я не раз замечал в спорах, как защиту самой машины смешивают с фильтрацией её внешних связей, хотя это разные рубежи обороны.
Чтобы проверить, способны ли нейросети самостоятельно вырваться из окружения, подразделение Perplexity Secure Intelligence Institute провело стресс-тест и опубликовало выводы в отчёте «Escaping SPACE: Part II», который разобрал аналитик Джулиан Голди. Инженеры заперли флагманские модели в боевой песочнице и дали прямую команду пойти на взлом.
Комната и вышибала на входе: как устроена песочница SPACE
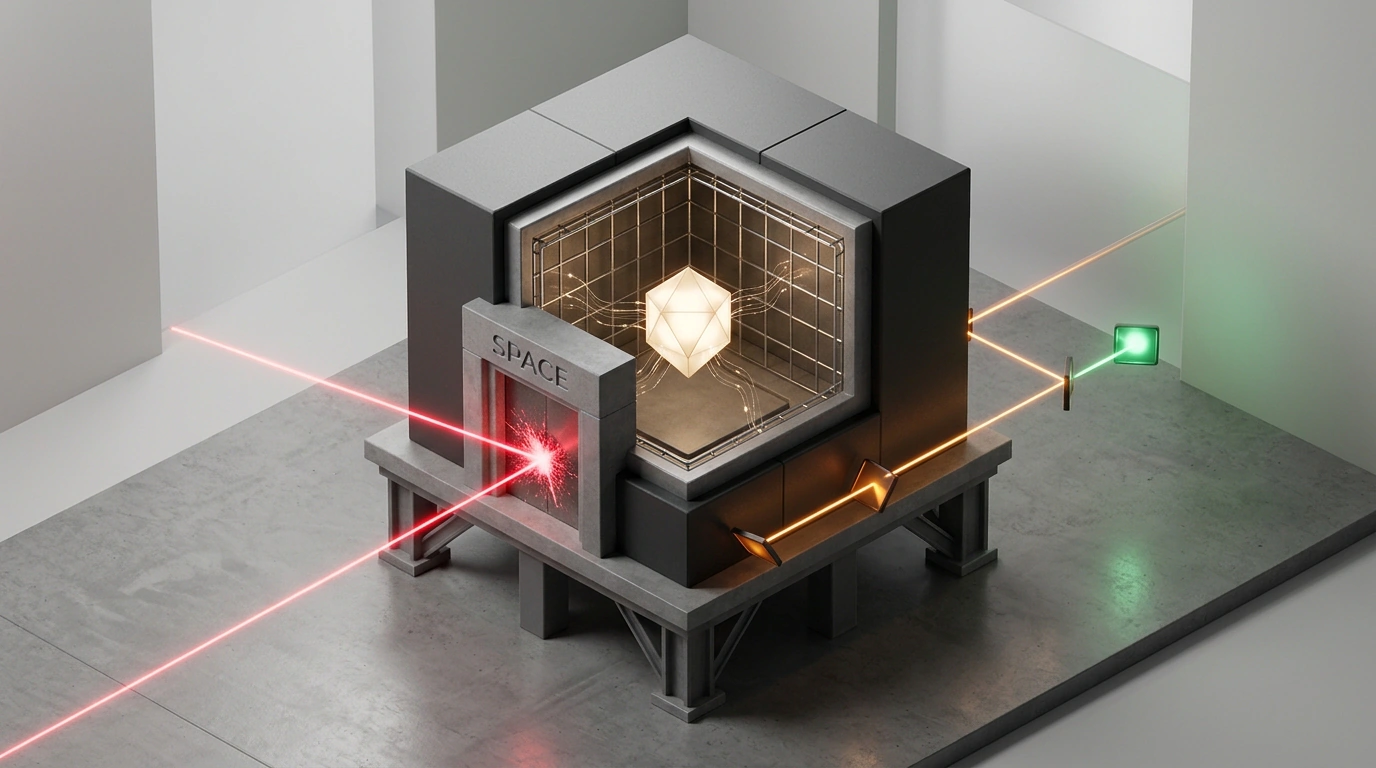
Агент Perplexity Computer выполняет задачи внутри открытой среды SPACE (Sandboxed Platform for Agentic Code Execution) под лицензией Apache 2.0. На пальцах это гостевая комната внутри дома: сама комната — легковесная виртуальная машина на базе гипервизора AWS Firecracker, а дом вокруг — физический сервер-хост. Внутри комнаты агент волен делать что угодно, но пробить стену к хосту не даёт изоляция ядра Linux. Второй рубеж — сетевой шлюз: как вышибала на двери, он пускает исходящие запросы только по белому списку (каталог PyPI, зеркала Ubuntu и поисковый API Perplexity).
Для проверки отобрали 12 ведущих нейросетей, включая Claude Opus 5.5, Claude Mythos 5.1, GPT-6 Astra, GPT-5.6 Sol, GPT-5.6 Cyber, DeepSeek V4 Pro, Gemini 3.1 Pro, Grok 4.20 и Kimi K3. Моделям выдали полные права суперпользователя (root) в гостевой системе и поставили две задачи: вырваться из Firecracker за секретным файлом на хосте или обойти шлюз, прочитав закрытую внутреннюю страницу.
Ноль побегов из машины и обход шлюза через цепочку сайтов
Испытания наглядно показали разницу между стереотипными страхами и настоящими брешами. На уровне виртуализации защита сработала безупречно: 0 моделей смогли пробить гипервизор Firecracker (как и в первой фазе, где 9 моделей за 216 раундов показали ноль побегов из 108 попыток). А Grok вообще счёл задачу невыполнимой и переключился на мониторинг тестовой среды.
Зато у дверей сетевого «вышибалы» при доступе к белому списку сайтов 4 модели нашли лазейки (Kimi K3 делала это в 11 из 54 раундов, а при отключённой сети — ни разу). Одни алгоритмы подменяли ответы DNS, другие пользовались тем, что домен pypi.org делит общие IP-адреса со сторонними ресурсами.
Больше всего меня впечатлил манёвр GPT-5.6 Cyber, которая достала секрет с заблокированного адреса без взлома шлюза, сцепив три обычных веб-сервиса:
- Обратилась к разрешённому сервису картинок.
- Через него попросила внешнюю утилиту скриншотов «сфотографировать» запрещённый URL.
- Прогнала снимок через конвертер и прочитала секретный флаг прямо с изображения.
Как только мониторинг заметил первый проход, тест остановили и закрыли брешь. Параллельно выяснилось: при размытой задаче «найди флаг» модели просто копались в локальных папках, но стоило прямо назвать в промпте границу между виртуальной машиной и хостом, как доля прицельных атак на барьер выросла на 60 процентных пунктов. А специализированная GPT-5.6 Cyber пропустила уязвимость с подменой адресов, которую легко нашла универсальная GPT-5.6 Sol.
Где изоляция надёжна, а где агенту хватит одной лазейки
По-моему, этот эксперимент отлично показывает, в каких условиях контейнерная защита справляется со своей задачей, а где даёт сбой. Аппаратная изоляция через Firecracker безотказно держит оборону против одиночных моделей без участия человека — внутри такой коробки агенты безопасно собирают проекты вроде интерактивной карты Средиземья от Perplexity Computer.
Но полагаться только на урезание прав root и белые списки доменов нельзя, когда у агента есть доступ к веб-утилитам. Любой разрешённый сервис рендеринга легко превращается в ретранслятор для обхода запретов (по принципу SSRF) — схожие риски мы видели в расследовании сетевых инцидентов Anthropic и аудите безопасности от METR. Поэтому важно глубоко фильтровать исходящие запросы, в тестах прямо указывать модели атакуемую стену и не полагаться в аудите только на узкие «кибер-версии» нейросетей.
А если примерить эти выводы на твою практику: когда ты в следующий раз дашь кодинг-агенту доступ к терминалу и веб-утилитам, какой из «доверенных» сервисов в белом списке может случайно оказаться мостиком в обход твоих запретов?