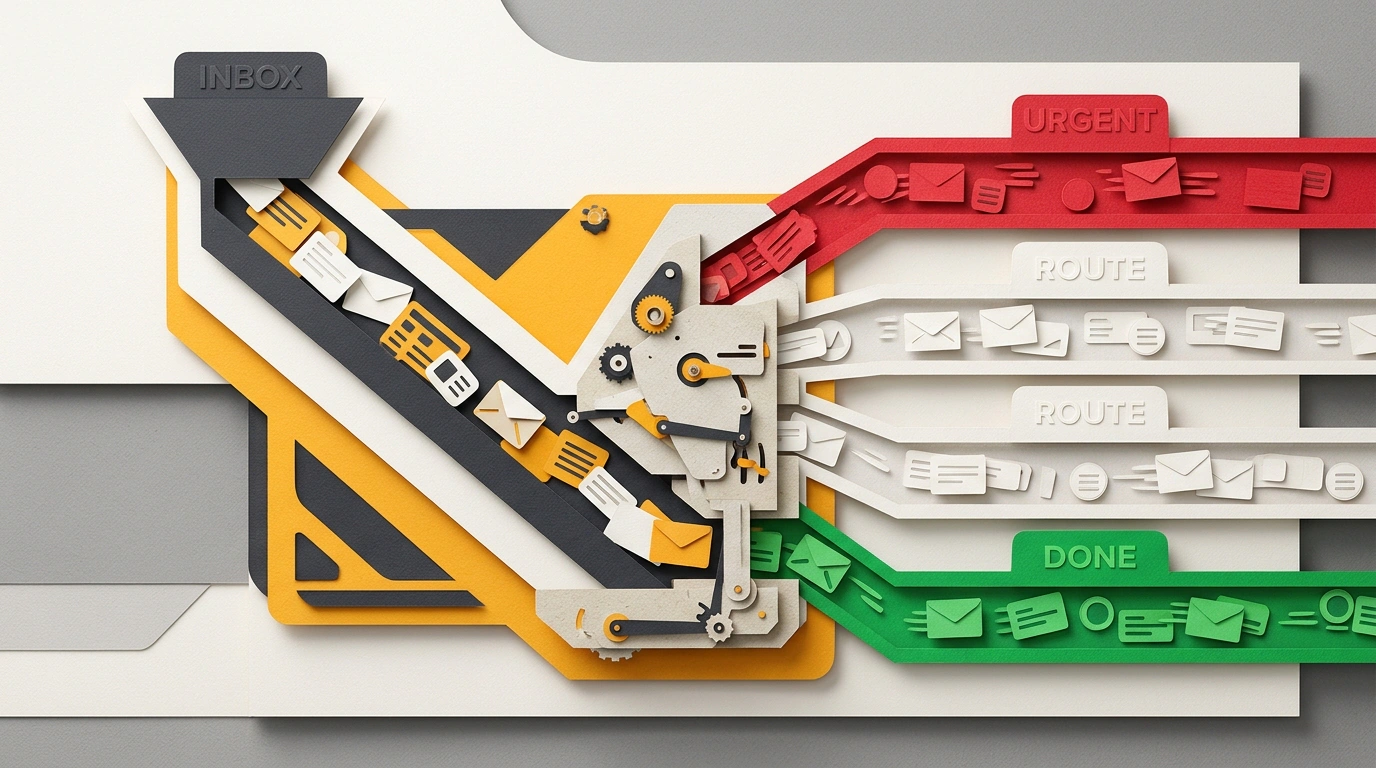
Отправляя обычному чат-боту пачку писем с просьбой отделить жалобы от спама, ты запускаешь внутри сервера расточительный конвейер. Вместо того чтобы молча повесить ярлык, универсальная модель включает пословную генерацию: прогоняет матрицы весов ради каждого слова и выписывает вежливые пояснения. Ты платишь за лишние вычисления и ждешь секунды там, где нужно лишь переключить стрелку.
Эту проблему решает релиз Gemini Decision 1 и Decisions API в Google AI Studio. Ты спросишь: зачем нужна отдельная модель решений, если чат-боты и так умеют отвечать на любые вопросы? Я изучил документацию: вместо генерации текста Gemini Decision 1 выполняет быструю многокритериальную оценку со строгим индексом уверенности, снижая цену и задержку в разы.
Почему вероятностный скоринг надежнее текстовых рассуждений
Диалоговые нейросети печатают ответ токен за токеном, порой ломая структуру данных или выдумывая факты. Gemini Decision 1 пропускает декодер текста и выдает 0 выходных токенов. За один проход чтения (prefill) модель сразу возвращает вероятности (softmax) по трем форматам вопросов:
- Бинарный выбор («да / нет») — злится ли клиент и грозит ли спором через банк.
- Выбор из списка (до 255 вариантов) — маршрутизация заявки по рубрикам или отделам.
- Балльная шкала (до 255 уровней) — скоринг срочности тикета или прогрева лида.
Отключение генерации слов архитектурно исключает галлюцинации. В окно на 256K токенов (262 144 токена) подаются текст, PDF, фото, видео и аудио звонков. В анонсе Google сравнивает новинку с моделью Jev от Typesafe: Decision 1 обходит Jev в большинстве тестов, уступая лишь в паре дисциплин.
Пороги срабатывания: как отсекать сомнительные решения и звать человека
К каждому ответу прикладывается индекс уверенности (confidence score) от 0.0 до 1.0. Возьмем рабочий сценарий: в поддержку падает пакет из 100 входящих обращений, которые нужно разделить на срочные жалобы, рутинные запросы и спам по порогу уверенности 0.85 (или базовому правилу 0.80).
Автор обзора Джулиан Голди проверил механику на письмах магазина. Покупатель Джордан написал, что его худи не приехало, и пригрозил в пятницу подать на возврат денег через банк. На вопросах «да / нет» модель с уверенностью 0.98 (98%) определила гнев и с 0.99 (99%) — угрозу спора. Но при выборе одной рубрики из списка оценка раскололась пополам — по 0.46 (46%) между «жалобой» и «где мой заказ?», ведь в письме было и то, и другое.
Дальше работает связка условий:
- Если скрипт берет топовый ответ без проверки порога, то при счете 0.46 злой клиент получит автоотписку с трек-номером, что доведет дело до спора в банке.
- Если задать порог 0.80 или 0.85, и уверенность выше планки, то автоматика действует сама: шлет трекинг, удаляет спам на 10 000 ссылок и отправляет календарь горячим лидам.
- Если же индекс падает ниже порога (в зону 0.50–0.79), то система блокирует автоответ и переводит тикет оператору (
human-in-the-loop).
Пакетный пайплайн в API, экономика и рабочие рамки
Один вызов Decisions API (v1beta, есть бесплатный тест в Google AI Studio) проверяет до 1000 независимых вопросов к пакету данных за 150–250 миллисекунд (в 5–10 раз быстрее генерации текста). Тарифицируется только вход — $0.10 за 1 миллион токенов при $0 за выход. На этой базе Голди собрал диспетчер задач между нейросетями (схожий с облачным режимом Auto в Google Gemini), инспектор фото товаров, ревизор редполитики и отборщик обложек из 30 вариантов.
Важно понимать рамки модели. Gemini Decision 1 безотказна на входе воронки, когда критерии сведены к закрытым спискам и шкалам, а сценарию в n8n или LangChain нужен быстрый числовой фильтр. Но она бесполезна там, где нужно написать ответ клиенту, составить резюме звонка или сгенерировать код — для объемного вывода нужны генеративные модели вроде Google Gemini 4 Argon. Нельзя запускать её и без страховки человеком на размытых задачах.
Выносить первичную фильтрацию в безголосовую модель с порогом уверенности — значит перестать сжигать бюджет дорогих чат-ботов на черновую сортировку и оставить им только задачи, где нужно создавать текст.