Когда лимит в консольном агенте вроде Claude Code или OpenAI Codex тает за пару часов, это легко списать на сложный код и «аппетиты» нейросети. Но когда авторы из Microsoft Research и UC Berkeley разобрали логи сессий в работе TokenEconomizer, выяснилось обратное: огромная доля контекста сгорает еще до того, как модель напишет первую строчку.
Каждую сессию агент начинает с чистого листа — изучает папки, наугад ищет команду тестов и таскает в промпте десятки ненужных функций. Чтобы перекрыть этот расход без правки моделей, в Microsoft открыли под лицензией Apache 2.0 токен-сейвер TokenEconomizer. Разберемся, почему агенты сжигают лимиты на типовых задачах и как кэширование состояния репозитория сберегает до трети бюджета.
Куда уходят токены: три утечки на неизменных файлах
Удобство консольного агента обходится дорого из-за отсутствия памяти между запусками. Как показал автор канала Julian Goldie SEO, бюджет сессии уходит в три дыры:
- Перечитывание проекта. В новом окне агент не помнит, где лежат конфиги (
.env.local) и чем запускаются тесты (pnpm test:unitилиpython -m pytest). Он вызывает скрипт наугад, ловит ошибку и сканирует неизменные файлы заново. - Балласт инструментов. В каждом запросе пересылаются JSON-схемы 20+ инструментов. Это как возить в багажнике ящик ключей в поездку за хлебом: описания съедают 2 000–4 000 токенов за шаг, хотя 18 функций не вызываются.
- Петли ошибок. Споткнувшись об одну ошибку компилятора, скрипт трижды и более перезапускает сломанную команду, выжигая дневной лимит за полчаса.
На серии из 15 задач по починке багов в TypeScript-проекте такие обходы раздувают расход до 120 000 токенов. А в тестах Microsoft и Беркли на 277 задачах (SWE-bench) закрытие трех утечек снизило траты на 18,4–30,9% (рекорд у Claude Code с Opus) при росте точности Pass@1 на 1,5–3%.
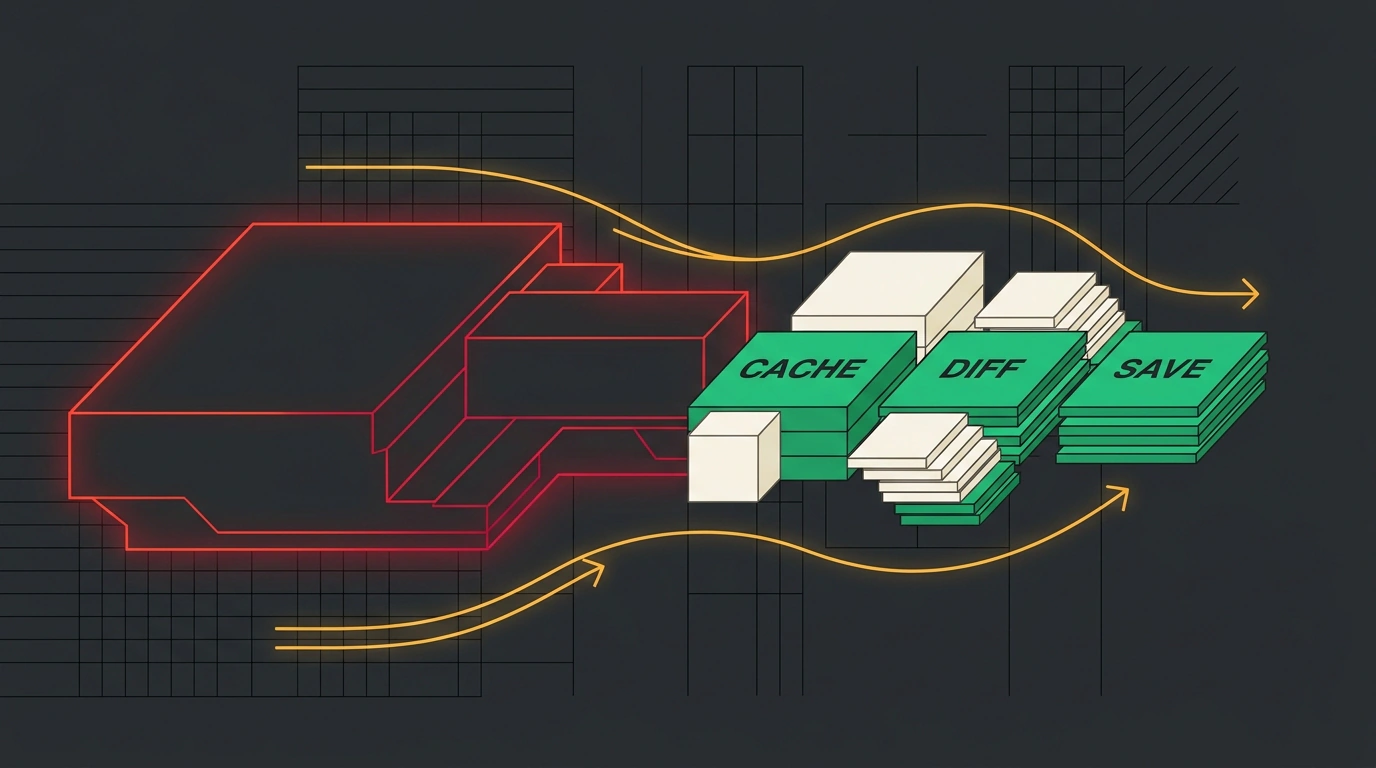
Дифференциальный кэш: микро-скиллы, фильтрация и защита от циклов
TokenEconomizer работает как внешний контроллер со стартом быстрее 50 мс. Ранее я разбирал, как гигиена контекста в Claude Code и прокси-фильтрация терминала берегут квоты, а плагин Microsoft автоматизирует это по опыту прошлых сессий:
- Микро-скиллы (
micro-skills). Парсер сверяет успешные команды и ветку в Git. Факт о проекте, подтвержденный в 3 сессиях подряд, пишется в кэш и на следующем старте подается одной строкой. Если после коммита команда дала сбой, запись удаляется. - Отсечение схем (
Tool Pruning). Функция, не вызванная за 10 сообщений в 2 сессиях (или 5 сессий подряд), временно исключается из промпта. - Прерыватель петель (
Loop Guard). При трех подряд одинаковых ошибках (или риске петли выше 70%) агент получает подсказку сменить подход.
Настройка в Claude Code и Hermes: ловушка выключенной памяти
Для работы нужны Python 3.10+, Git и агент (Claude Code, Codex, Hermes или GrokBuild). Чтобы подключить плагин к нашему TypeScript-проекту в Claude Code, клонируем репозиторий и регистрируем пакет:
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add ./TokenEconomizer
claude plugin install TokenEconomizer
После этих команд фильтрация схем и Loop Guard работают сразу, но главная память проекта (micro-skills) по умолчанию выключена — без нее агент снова будет изучать папки с нуля. Включаем ее глобально через te-config set microskills=on --global или создаем в проекте файл .tokeneconomizer/config.json:
{
  "enable_microskills": true,
  "enable_tool_pruning": true,
  "enable_loop_guard": true,
  "max_consecutive_errors": 3,
  "storage_path": ".tokeneconomizer/cache"
}
Флаг enable_microskills сохраняет факты в .tokeneconomizer/cache, а max_consecutive_errors: 3 прерывает повторы после третьей ошибки. На серии из 15 задач в TypeScript-проекте это с четвертой сессии отсекает 18 лишних схем и чтение неизменных конфигов, снижая расход со 120 000 до 84 000 токенов. Сводка и правила доступны через /token-economizer-status и /token-economizer-microskills, а возврат схем — через /token-economizer-toolprune-show и /token-economizer-toolprune-restore.
Не превращай экономию в самоцель на разовых черновиках. В тесте Джулиана Голди на 16 задачах плагин сберег 25% токенов на коде магазина и 12% на отчетах (в среднем 15%), но в папках на пару запусков микро-скиллы не наберут три подтверждения (в Hermes пока доступны память и Loop Guard). Ставь TokenEconomizer на постоянные репозитории и сохраняй .tokeneconomizer/cache — тогда лимит перестанет сгорать вхолостую.