Замечал, как старательно формулируешь нейросети предельно короткие запросы ради бережливости, а недельный лимит всё равно упирается в потолок уже к среде? В терминальном помощнике Claude Code от Anthropic урезание собственных фраз почти не двигает стрелку расхода.
Агент живёт прямо в командной строке: сам открывает файлы, запускает тесты и считает весь текст в токенах — фрагментах примерно по четыре буквы. Я сопоставил практический разбор Джулиана Голди с документацией Anthropic: 70–80% бюджета съедают не твои вопросы, а накапливающийся вывод команд и повторное чтение одних и тех же файлов.
Куда уходят токены в циклических задачах терминала
Короткие реплики не спасают баланс, потому что между ответами у модели нет собственной памяти. Представь толкового, но забывчивого напарника, который выходит за дверь после каждой фразы: чтобы попросить его поправить запятую, приходится заново класть на стол всю папку сегодняшней переписки и длинные распечатки проверок. Контекстное окно устроено ровно так же — при каждом твоём сообщении и каждом вызове инструмента агент пересылает на сервер всю историю сессии с первой минуты.
Причём ещё до твоей первой команды окно нагружено на 8 000–30 000 токенов: там сидят системные инструкции, правила CLAUDE.md и схемы подключённых внешних интеграций (MCP-серверов). Дальше начинается лавина отладки. Допустим, разработчик чинит веб-сервис, и компилятор падает с отчётом на 500 строк. Без фильтрации агент заглатывает весь сырой вывод и на каждой правке заново перечитывает 3 неизменных файла зависимостей. Один круг сжигает около 45 000 токенов, а на следующем шаге старый лог едет в запросе повторно, размывая заодно и внимание модели.
Фильтрация шума и гигиена сессий: выгода и скрытая цена
Чтобы не оплачивать одни и те же простыни дважды, шум отсекают на входе. В нашем веб-сервисе мы закрываем статичные папки от чтения через .claudeignore, а запуск тестов ограничиваем выдачей реального сбоя:
# Скрываем неизменяемые зависимости и сборку от повторного чтения
printf "node_modules/\ndist/\n" >> .claudeignore

# Передаём в контекст только строки с ошибками и хвост из 15 строк
npm test 2>&1 | grep -i error | tail -n 15
Картина меняется сразу: вместо полутысячи строк консольного мусора и чужих модулей модель видит компактную выжимку с точной причиной поломки. Затраты на цикл падают до 6 500 токенов — больше 85% экономии на месте, ответы ускоряются, а недельный лимит перестаёт таять на одном баге.
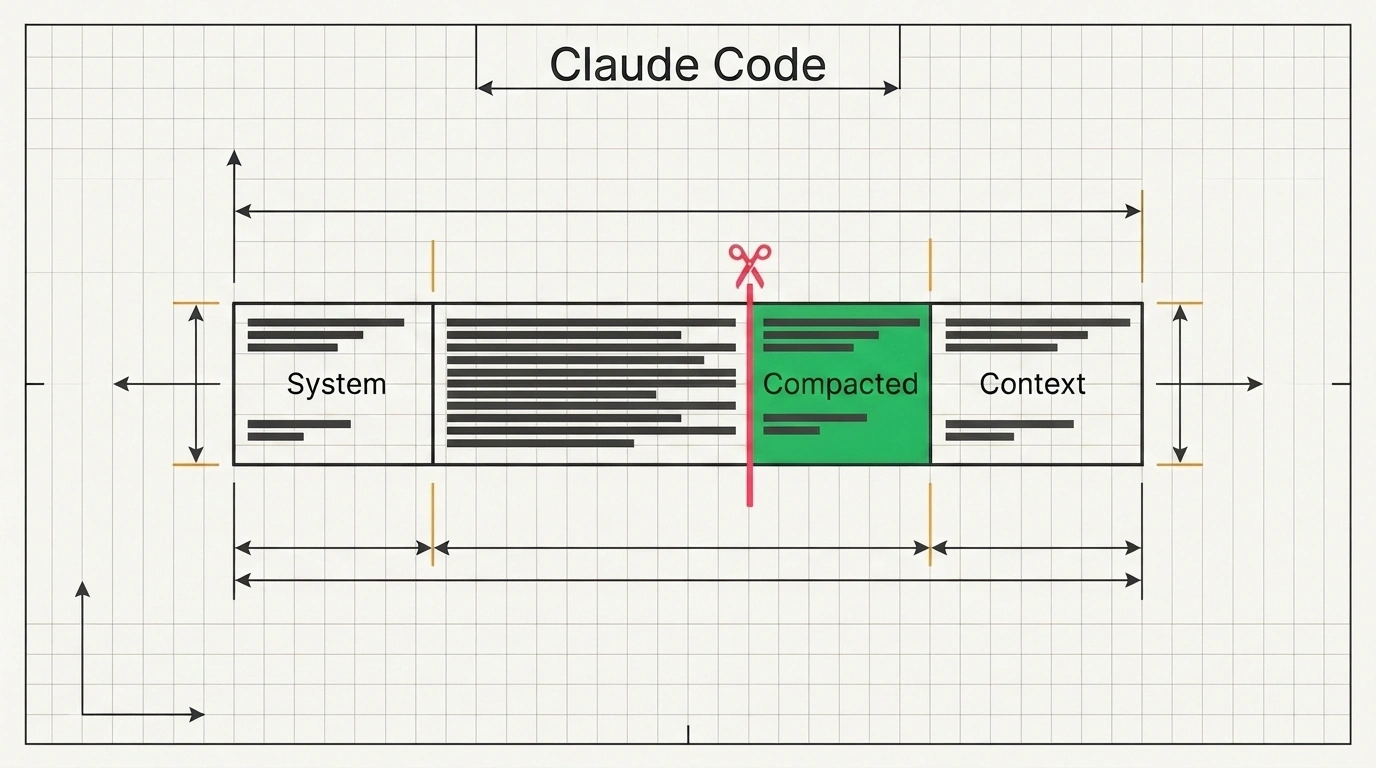
Внутри долгой сессии чистоту поддерживают штатные команды. Вызов /context показывает диаграмму заполнения окна: легко заметить лишние интеграции и раздутый CLAUDE.md (как структура этого файла сохраняет кэш, мы разбирали в гиде по Claude Code в продакшене). Команда /compact сворачивает прошлые шаги в чекпоинт, оставляя git status, правила проекта, план и до 5 последних файлов (файлы свыше 5 000 токенов заменяются путями), а параметр autoCompactWindow в ~/.claude/settings.json (например, 200000) автоматизирует этот порог.
Но у сжатия есть скрытая цена. Пересказ через /compact способен сгладить тонкие краевые условия из начала ветки, поэтому на новой задаче надёжнее закоммитить код в git и очистить окно через /clear ради защиты от деградации внимания (context rot), уводя попутные вопросы в боковой чат /btw. Коварны и сторонние компрессоры текста: в тестах JetBrains агрессивный фильтр команд на низком усилии поднял общий расход на 7,5% — в полутьме агент начинал петлять и тратить лишние ходы. В остальном достаточно прикреплять большие таблицы файлами, выбирать быстрый Sonnet через /model и снижать глубину раздумий /effort на простых правках (108 выходных токенов на low против 963 на максимуме), снижая цену сложной итерации с 40 000–60 000 до 8 000–12 000 токенов.
Экономия бюджета в терминале начинается не с телеграфно коротких промптов, а с привычки не заставлять нейросеть на каждом шаге перечитывать сырые логи и хвосты уже закрытых задач.