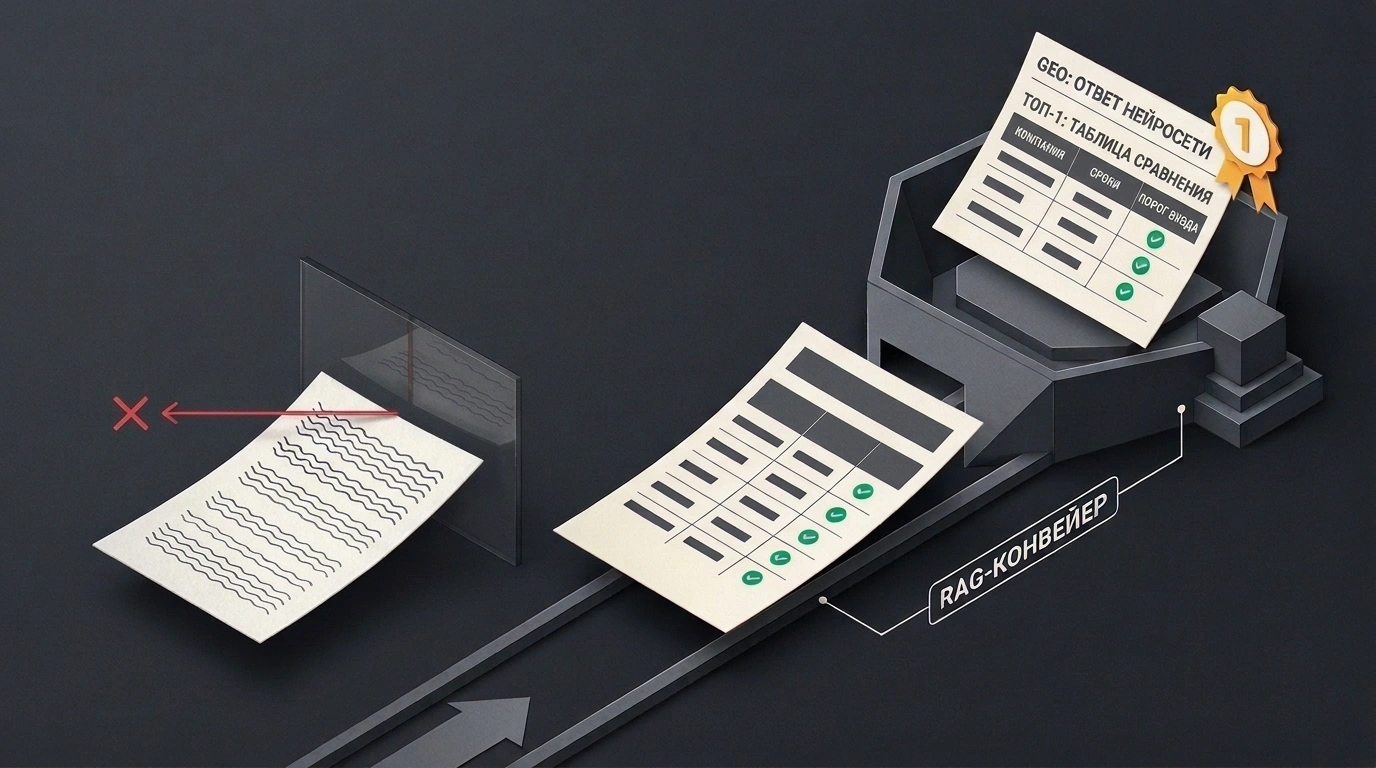
Представь клиента, которому нужна заказная разработка софта с бюджетом от 1 до 10 млн ₽. Он открывает поиск Яндекса в Москве и спрашивает: «посоветуй компанию для аутсорса разработки ПО». В ноябре 2026 года нейросеть Яндекса три раза из трёх ставила на первое место студию Code Pilots со штатом 60+ человек. Гигант SimbirSoft, у которого 1 500+ специалистов и 25 лет опыта, оказывался третьим или четвёртым. Разница в штате в 25 раз, а наверху рекомендации стоит маленький игрок.
Причина видна сразу, если нажать на значок источника под названием первой студии. Он ведёт на статью в блоге самой Code Pilots от 3 сентября: «Лучшие компании аутсорсинга разработки: ТОП-10 подрядчиков 2026 года». Внутри порядок такой: Code Pilots, Purrweb, Surf, SimbirSoft. При проверках 20 и 21 ноября нейросеть воспроизвела эту четвёрку один в один три раза подряд.
Откуда нейросеть берёт порядок компаний в ответе
Свои рейтинги в корпоративных блогах компании пишут давно, и Code Pilots даже честно оставили пометку: первыми в списке стоим мы сами, делаем заказную разработку под процесс с 2014 года. Всё открыто, без маскировки под независимое медиа. Вот только в ответ нейросети эта оговорка не попала. Клиент видит готовый список, а авторство спрятано за мелкой иконкой ссылки.
Похожая картина и в мобильной разработке: студия Amiga в двух замерах из двух обходила Surf за счёт рейтинга в своём блоге. Чтобы понять механику, заглянем в устройство GEO (Generative Engine Optimization — оптимизации контента под ответы нейросетей).
Яндекс Поиск с Нейро работает как гибридный RAG-конвейер (Retrieval-Augmented Generation — схема, где модель сначала вытаскивает куски текста из поиска, а потом собирает из них ответ). Сначала алгоритм берёт кандидатов из классического органического топа, обычно из первой пятёрки или десятки. Затем отсеивает страницы без цитируемого текста, режет оставшиеся на фрагменты и оценивает их полезность моделями BERT и CatBoost. В финал проходят 5–10 самых фактурных блоков, из которых YandexGPT склеивает ответ со строгой привязкой ссылок.
Поставь себя на место этого конвейера. На одном сайте лежит глянцевый лендинг с фразами про индивидуальный подход и команду профессионалов. На другом — подборка с одинаковыми полями у каждого участника: для кого подходит, сроки, порог входа. У SimbirSoft своего сравнения среди источников ответа не нашлось, а у Code Pilots оно лежало готовым. Нейросеть не считает штат и не смотрит на возраст юрлица. Она пересказывает того, кто уже сравнил рынок в удобном виде.
Проверка за 12,5 часа и границы, где фокус ломается
Скептик тут же скажет: совпало, повезло со старым доменом. Гипотезу проверили на другом проекте — студии Nurokod. 5 ноября 2026 года в 20:29 по Москве на запрос «посоветуй студию для разработки mvp» (MVP — минимальная рабочая версия продукта для запуска) нейросеть Яндекса называла DELAWEB, «РиверСофт» и X Studio. Студии Nurokod не было ни в ответе ИИ, ни в первой десятке выдачи.
В 21:33 на площадке Sostav с аккаунта Nurokod вышла подборка «Разработка MVP для стартапа 2026: топ-10 студий по срокам и цене». Внутри 10 студий и два одинаковых поля у каждой: срок первой рабочей версии и цена «от». Nurokod встала первой по сроку запуска. Утром 6 ноября в 10:09 (через 12,5 часа после публикации) нейросеть поставила Nurokod на первое место.
Через две недели, 20 и 21 ноября, Nurokod держала первую строчку три раза из трёх, а ИИ буквально пересказывал критерий из статьи: первая рабочая версия может появиться примерно за две недели. Вторым чаще всего шёл СКЭНД (250+ человек и 700+ проектов против 40+ проектов у Nurokod), ниже попадались DELAWEB, Purrweb, Surf и Code Pilots. Другой вопрос клиента, другое сравнение — другой лидер.
Сразу остудим пыл: полевые замеры в одном регионе на нескольких запусках — это рабочий ориентир, а не волшебная кнопка для любой ниши. Есть три чёткие границы, где свой рейтинг не сработает.
Первая граница — ниши, где о лидере уже написали чужие СМИ и крупные площадки. В интеграции Битрикс24 нейросеть стабильно ставит первым «Первый Бит», в продвижении на Wildberries — XWAY. Сбить их одной статьёй по широкому запросу почти невозможно. Обход один: сужать запрос под конкретный сегмент или стек, где готовых обзоров у изданий ещё мало.
Вторая граница — «плавающая» выдача. В разработке сайтов для производства опубликованный рейтинг ставил студию первой лишь раз из трёх, а в двух других запусках она падала на вторую и пятую строчки. Если поисковик каждый раз собирает разные источники, стабильного первого места не выйдет.
Третья граница — доверие живого клиента. Если человек откроет ссылку под твоим названием и увидит придуманный «топ лучших» без цифр и подписи, заявка сорвётся. Подписывай авторство открыто и бери реальный проверяемый критерий, по которому ты правда впереди.
Миф про llms.txt и правило абзаца, который выживает при копировании
Пока в Рунете тестируют таблицы под Яндекс, вокруг Google AI Overviews и AI Mode вырос рынок продажи воздуха. Подрядчики продают настройку файла llms.txt в корне сайта (текстовый указатель для языковых моделей по аналогии с robots.txt) и «специальную AI schema» — якобы особую скрытую разметку для нейросетей Google.
Официальная позиция Google Search Central закрывает эту тему. Гэри Иллис на Search Central Live подтвердил, что Google не поддерживает llms.txt и не планирует его внедрять. Джон Мюллер добавил, что ни одна крупная AI-система на этот файл не опирается, а шумиху вокруг него сравнил с устаревшим метатегом keywords. Отдельной «AI-разметки» тоже нет: для AI Overviews и AI Mode работают базовая индексация, классическое SEO и обычный JSON-LD, совпадающий с видимым текстом страницы.
Официальная документация Google Search Central по AI-функциям поиска (Источник: developers.google.com)
Сэкономленные деньги лучше вложить в самодостаточные абзацы. Поисковики вырывают отдельные куски текста и вставляют их в сводный ответ. Если абзац держится на словах «он» или «эти функции», при копировании смысл пропадает.
Возьмём для примера страницу коммерческой кофемашины Neuroduo. Слабый абзац выглядит так: «Она также оснащена этими функциями, что делает её идеальной для кофеен вроде вашей». Вырежи его в сравнение с тремя другими машинами — ничего не понятно. Какая модель? Какие функции? Для какой кофейни?
А вот сильная версия: «Neuroduo — двухбойлерная эспрессо-машина, удерживающая температуру при потоке шотов подряд. Рассчитана на кофейни на 150–300 напитков в день и требует выделенную линию на 20 ампер». Имя продукта, целевой клиент и техническое ограничение стоят в одном блоке. Такой абзац спокойно переживает копирование в любой ответ ИИ.
Тренажёр: переживёт ли твой абзац копирование в ответ ИИ
Переключи оба примера и проверь любой абзац со своей страницы услуг. Как только убираешь слепые местоимения, называешь продукт прямо и ставишь рядом конкретное ограничение, фрагмент начинает работать и на живого покупателя, и на выдачу ИИ.
План на один вечер: аудит своей ниши и тест 20 абзацев
Стартовая проверка укладывается в один вечер и состоит из двух шагов: разведки в выдаче и ревизии своих коммерческих текстов.
Аудит своей ниши в ответах ИИ за 10 минут
- Спроси нейросеть словами клиента с бюджетом: «посоветуй твоя услуга для сегмент» — например, для стартапа или для отдела продаж.
- Повтори запрос три раза с паузой в пару минут и отметь, кто стабильно первый, а где выдача плавает.
- Открой источник под лидером: это блог подрядчика, отраслевая площадка или стороннее издание?
- Проверь жанр: там сравнение с одинаковыми полями или обычная продающая страница?
- Если тебя нет в ответе и нишу не закрыли СМИ, напиши своё сравнение из 10 компаний с едиными полями, честным критерием и подписью авторства, а через сутки повтори проверку.
Второй шаг — ревизия сайта. Выпиши 20 главных вопросов, которые клиент задаёт перед покупкой: сроки, порог входа, кому услуга не подойдёт, технические ограничения, состав цены. Найди на сайте 20 абзацев с ответами и скопируй каждый в пустой документ. Если абзац остаётся ясным и точным сам по себе — оставляй. Если без текста выше непонятно, о каком продукте речь и где его границы — переписывай по схеме «продукт + для кого + конкретное ограничение».