
Если ты хоть раз готовился к техническим собеседованиям в бигтех, то наверняка знаешь этот ритуал наизусть: сотни решенных задач на LeetCode, заучивание наизусть балансировки красно-черных деревьев, алгоритм Дейкстры на ориентированных графах и бесконечные вариации поиска подстроки через скользящее окно. Кажется, будто идеальный инженер — это быстродействующий калькулятор асимптотической сложности Big-O, способный за двадцать минут написать в блокноте обход графа в глубину без единой синтаксической ошибки.
Но давай будем честны: когда ты в последний раз писал собственное бинарное дерево поиска в реальном рабочем проекте?
В промышленной разработке мы берем готовые структуры данных из стандартной библиотеки языка или проверенных движков. Языки вроде Go, Rust, Java, C# и даже среды на базе V8 десятилетиями полировали свои хэш-таблицы и массивы. Реальные аварии, приводящие к падению серверов и убыткам бизнеса, практически никогда не происходят из-за того, что программист взял алгоритм с $O(N \log N)$ вместо $O(N)$.
Они происходят потому, что память процесса раздулась и вызвала двухсекундную паузу сборщика мусора, сетевой сокет разорвал соединение посреди транзакции, соединенные сервисы устроили каскадный шторм повторов, а наивный код попытался загрузить пятигигабайтный файл в один буфер.
В этом фундаментальном разборе, опираясь на концепции открытых курсов системного программирования HowProgrammingWorks и архитектурные исследования Тимура Шемсединова, мы выйдем далеко за пределы олимпиадных иллюзий. Мы разберем по винтикам шесть прикладных инженерных дисциплин, которые превращают разрозненный код в надежные, высокопроизводительные распределенные платформы.
1. Ограниченность олимпиадных алгоритмов: почему в распределенных системах задержка побеждает Big-O
Вся экосистема олимпиадного программирования построена вокруг модели изолированного «черного ящика». Посмотри на типичную постановку задачи:
- На вход функции подается готовый массив целых чисел;
- Память считается абсолютно плоской, непрерывной и бесконечной;
- Время оценивается исключительно количеством процессорных инструкций ($O(1)$, $O(N)$, $O(N^2)$);
- Никаких сбоев операционной системы, обрывов кабеля или зависших дисков существовать не может;
- Функция возвращает единственный результат и мгновенно завершает выполнение.
В распределенной системе реального мира эта абстракция разбивается о физические законы железа и сетей.
Первый парадокс, с которым сталкивается разработчик, — доминирование задержки ввода-вывода (Latency) над алгоритмической сложностью. Представь, что у тебя есть идеально оптимизированная хэш-таблица с асимптотикой поиска $O(1)$. Но чтобы получить ключ, твой сервис должен сделать три последовательных сетевых запроса к удаленному кластеру базы данных или кэшу Redis. Если сетевой пинг между дата-центрами составляет скромные 15 миллисекунд, суммарное время операции составит минимум 45 миллисекунд.
В то же время «неэффективный» с олимпиадной точки зрения линейный проход $O(N)$ по непрерывному массиву из 20 000 элементов, лежащему прямо в оперативной памяти и попадающему в процессорный кэш L1/L2, процессор Intel или AMD выполнит менее чем за 30 микросекунд. Разница составляет полторы тысячи раз. Инженер, который часами оптимизирует алгоритмические микросекунды в теле метода, но не замечает лишних сетевых раундтрипов (network hops), просто тратит ресурсы компании впустую.
Второй фундаментальный фактор — частичные отказы (Partial Failures). В математической функции ошибка либо возникает, либо нет. В сети третьего уровня сервер отправляет пакет, но не получает ответа. Записал ли удаленный узел платеж? Упал ли он до фиксации транзакции или ответный TCP ACK потерялся на перегруженном коммутаторе? Ни одна задача на поиск подстроки не учит проектировать распределенный консенсус, двухфазные фиксации, саги и компенсационные механизмы.
Наконец, в реальном мире данные никогда не приходят аккуратным готовым массивом. Они текут непрерывным потоком через сокеты от сотен тысяч клиентов. Если попытаться прочитать такой поток целиком в память, процесс неизбежно упадет с ошибкой Out Of Memory (OOM). Системная разработка требует потоковой обработки с обязательным механизмом обратного давления (backpressure), когда медленный потребитель явно сигнализирует быстрому источнику о необходимости притормозить передачу байтов.
2. Проектирование сетевых протоколов: фрейминг сокетов и бинарная сериализация
Большинство современных веб-разработчиков привыкли обмениваться данными через классический текстовый JSON поверх протокола HTTP/1.1. Это удобно при отладке: открыл вкладку Network в DevTools, прочитал понятный человеческий текст и сразу понял, где ошибка.
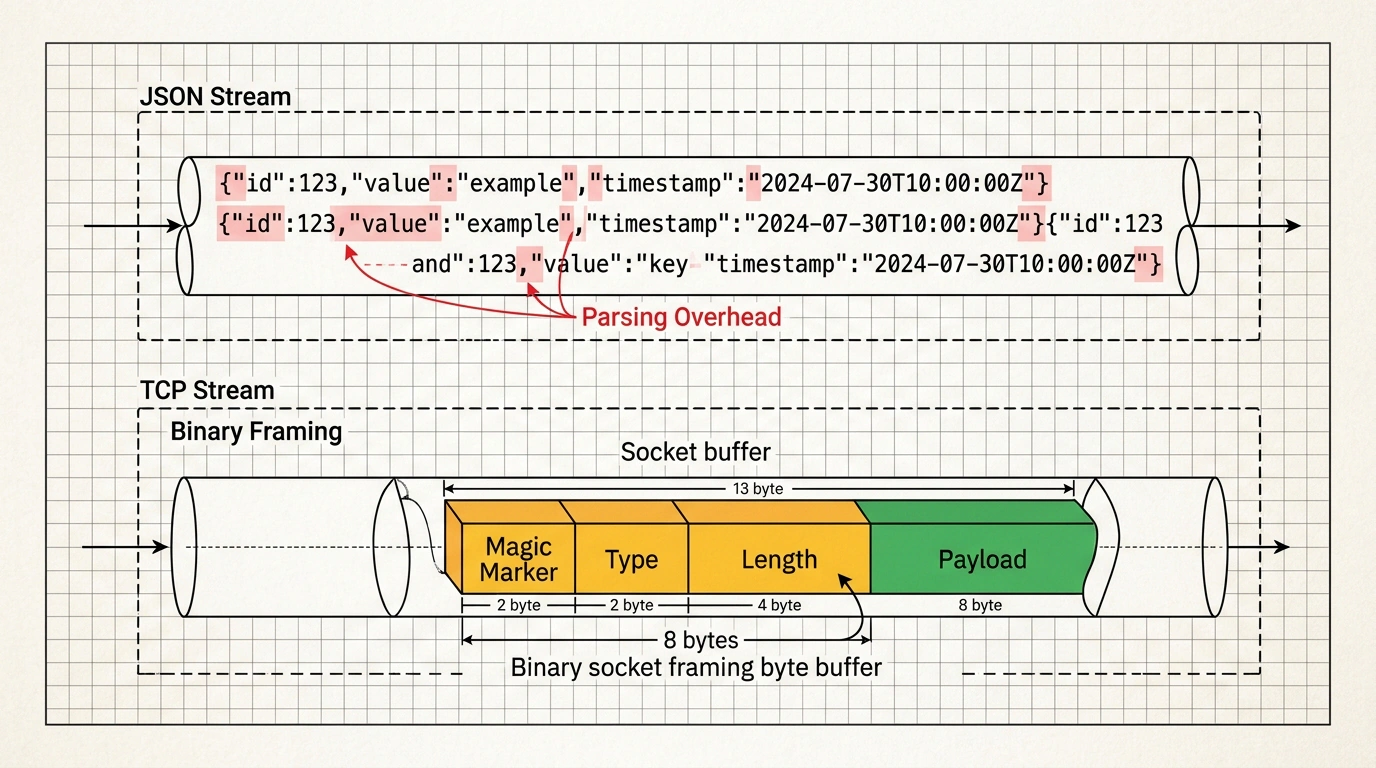
Однако за эту читаемость приходится платить огромную цену системными ресурсами, когда сервис масштабируется до сотен тысяч запросов в секунду:
- Текстовый парсинг невероятно прожорлив: парсер обязан посимвольно просканировать всю строку, валидировать кавычки, экранировать спецсимволы и конвертировать ASCII-цифры в числа с плавающей запятой IEEE 754.
- Избыточный оверхед: в каждом сообщении бесконечно повторяются строковые ключи полей (
{"transaction_id": 98234, "client_status": "active"}). В типовом API полезная нагрузка составляет от силы 20–30% передаваемого объема, а остальные 70–80% — чистый паразитный трафик ключей и кавычек. - Отсутствие строгих типов на уровне бинарной структуры приводит к неявным ошибкам валидации в рантайме.
Системный инженер смотрит на сеть через призму транспортного уровня. Протокол TCP — это непрерывный поток сырых байтов (stream). Он понятия не имеет о том, где начинается и где заканчивается твое логическое «сообщение». Если клиент отправил в TCP-сокет два JSON-документа подряд, операционная система может склеить их в один буфер сетевой карты или, наоборот, разорвать первое сообщение на три части из-за размера MTU (Maximum Transmission Unit).
Чтобы приложение могло однозначно восстановить сообщения из потока байтов, необходим уровень протокольного фрейминга (framing). Исторически существовало два подхода:
- Использование разделителей (Delimiters): например, символ перевода строки
\n(формат NDJSON). Недостаток очевиден: парсер вынужден проверять каждый входящий байт на совпадение с символом разделителя, что создает паразитные циклы CPU. - Префикс длины (Length-Prefixed Framing): перед телом сообщения передается компактный бинарный заголовок фиксированного размера. Например, первые 4 байта содержат беззнаковое 32-битное целое число (uint32 в формате big-endian), указывающее точный размер последующего пакета.
С бинарным заголовком парсеру достаточно прочитать ровно 4 байта, извлечь размер $L$, аллоцировать или запросить из пула буфер нужной длины и ждать прихода ровно $L$ байтов. Это полностью устраняет неопределенность и ускоряет разбор пакетов на порядки.
Давай посмотрим, как выглядит легковесный бинарный фрейминг на TypeScript с использованием низкоуровневых представлений DataView и Uint8Array:
// Заголовок фрейма (8 байт):
// 2 байта: Magic Number (маркер протокола)
// 2 байта: Message Type (тип команды/события)
// 4 байта: Payload Length (длина полезной нагрузки в байтах)
export class PacketFraming {
  static readonly MAGIC_MARKER = 0x5057; // Символы 'PW'

  static encode(messageType: number, payload: Uint8Array): Uint8Array {
    const packet = new Uint8Array(8 + payload.length);
    const view = new DataView(packet.buffer, packet.byteOffset, packet.byteLength);

    view.setUint16(0, this.MAGIC_MARKER, false); // Big-Endian
    view.setUint16(2, messageType, false);
    view.setUint32(4, payload.length, false);
    packet.set(payload, 8);

    return packet;
  }

  static decodeHeader(buffer: Uint8Array): { type: number; length: number } | null {
    if (buffer.length < 8) {
      return null; // Пакет еще не долетел по сети полностью
    }

    const view = new DataView(buffer.buffer, buffer.byteOffset, buffer.byteLength);
    const magic = view.getUint16(0, false);

    if (magic !== this.MAGIC_MARKER) {
      throw new Error(`Нарушение протокола: неверный magic marker 0x${magic.toString(16)}`);
    }

    return {
      type: view.getUint16(2, false),
      length: view.getUint32(4, false)
    };
  }
}
Переход на бинарные протоколы (будь то компактный Protobuf, FlatBuffers или самодельный бинарный стек) не просто экономит трафик сетевых адаптеров — он снимает с серверов колоссальную нагрузку по строковому парсингу, высвобождая ядра процессора для выполнения полезной бизнес-логики.
3. Управление памятью, пулы буферов и анатомия пауз сборщика мусора
В высокоуровневых средах разработки (Node.js/V8, Go, JVM, .NET) сборщик мусора создает обманчивую иллюзию безопасности. Разработчик привыкает создавать объекты на каждый чих: деструктуризация { ...options }, вызовы array.map(), склейка строк и создание анонимных замыканий на каждый входящий запрос.
В академических задачах это абсолютно незаметно. Но когда твой веб-сервис принимает 40 000 HTTP-запросов в секунду, расточительное выделение памяти в куче (heap) приводит к тяжелым системным последствиям:
- Фрагментация кучи: оперативная память заполняется миллионами мелких короткоживущих объектов.
- Нагрузка на фазы Scavenge / Mark-Sweep: сборщик мусора вынужден непрерывно обходить дерево живых ссылок, отвлекая процессорные ядра от обработки пользовательских соединений.
- Паузы Stop-the-World: когда куча переполняется, сборщик мусора останавливает исполнение всего приложения для выполнения глобального уплотнения памяти (Full GC). В этот момент сетевые сокеты перестают отвечать, тайм-ауты на балансировщике Nginx лопаются, а график 99-го перцентиля задержки (p99 latency) взлетает с 5 миллисекунд до 1500 миллисекунд.
Как системные инженеры решают эту проблему? Через фундаментальный паттерн пулинга буферов (Buffer Pooling).
Идея проста до гениальности: вместо того чтобы на каждый входящий сетевой пакет просить операционную систему выделить новый кусок памяти через malloc или рантайм new Buffer(), сервис при старте выделяет фиксированный пул готовых блоков памяти (например, 2048 буферов размером по 64 килобайта каждый).
Когда данные поступают из сетевого адаптера, воркер запрашивает свободный буфер из пула, считывает в него сетевой пакет, проводит обработку и немедленно возвращает буфер обратно в очередь свободных ресурсов. В стабильном режиме работы количество системных аллокаций памяти сводится практически к абсолютному нулю! Сборщику мусора просто нечего утилизировать, и паузы GC полностью исчезают из профиля нагрузки.
Второй критический прием — работа со срезами памяти (Views) без копирования. Вместо создания подстрок или копирования кусков байтов через методы вроде slice() опытный разработчик оперирует смещениями (offset) и длиной (length) поверх одного существующего непрерывного буфера ArrayBuffer или SharedArrayBuffer.
Наконец, в критических узлах используется архитектурный подход Data-Oriented Design (DoD): отказ от массивов полиморфных объектов вида [{ id: 1, x: 10, y: 20 }, { id: 2, x: 15, y: 25 }] в пользу параллельных плоских типизированных массивов (Structure of Arrays — SoA):
const ids = new Int32Array(10000);
const xCoordinates = new Float32Array(10000);
const yCoordinates = new Float32Array(10000);
Такая структура гарантирует идеальную пространственную локальность данных в кэш-линиях процессора (L1/L2 cache lines): процессор загружает соседние координаты одной инструкцией, полностью исключая промахи мимо кэша памяти (cache misses).
4. Модели конкурентности и конечные автоматы: укрощение асинхронного хаоса
В олимпиадных задачах код исполняется линейно от первой строчки до последней. В реальном сервере сотни клиентов одновременно отправляют запросы, обновляют одни и те же таблицы, закрывают соединения и требуют ресурсы.
Большинство начинающих инженеров пытаются синхронизировать асинхронные процессы наивными флагами в памяти:
let isProcessing = false;
let isConnected = false;
Этот путь неминуемо ведет к состоянию гонки (race condition), взаимным блокировкам (deadlocks) и «зомби-соединениям». Представь: сокет начал процедуру закрытия из-за ошибки сети, но в этот же микросекундный интервал таймер пинга попытался отправить байты в полузакрытый сокет. В логах появляется трудновоспроизводимая ошибка, которая воспроизводится один раз на миллион запросов и намертво вешает рабочий поток.
Системная инженерия отвечает на этот хаос математической строгостью детерминированных конечных автоматов (Finite State Machines — FSM).
Любой сложный асинхронный процесс (сессия пользователя, жизненный цикл TCP-соединения, проведение платежа) проектируется как конечный автомат:
- Процесс имеет строго ограниченный перечень допустимых состояний (
Disconnected,Connecting,Connected,Active,Closing); - Любое изменение состояния возможно только в ответ на строго определенные события;
- Если событие приходит в неподходящий момент (например, пришел пакет с данными, когда соединение уже находится в состоянии
Closing), автомат мгновенно отсекает аномалию, логирует инцидент и предсказуемо завершает операцию без порчи системных ресурсов.
Давай посмотрим на реализацию строгого автомата сетевой сессии, исключающего гонки состояний:
export type SessionState = 'DISCONNECTED' | 'CONNECTING' | 'CONNECTED' | 'ACTIVE' | 'CLOSING';

export type SessionEvent =
  | { type: 'EV_CONNECT' }
  | { type: 'EV_ESTABLISHED' }
  | { type: 'EV_AUTH_SUCCESS' }
  | { type: 'EV_DISCONNECT' }
  | { type: 'EV_ERROR'; error: Error };

export class NetworkSessionFSM {
  private currentState: SessionState = 'DISCONNECTED';

  getState(): SessionState {
    return this.currentState;
  }

  handle(event: SessionEvent): void {
    const from = this.currentState;

    switch (from) {
      case 'DISCONNECTED':
        if (event.type === 'EV_CONNECT') {
          this.currentState = 'CONNECTING';
          return;
        }
        break;

      case 'CONNECTING':
        if (event.type === 'EV_ESTABLISHED') {
          this.currentState = 'CONNECTED';
          return;
        }
        if (event.type === 'EV_DISCONNECT' || event.type === 'EV_ERROR') {
          this.currentState = 'DISCONNECTED';
          return;
        }
        break;

      case 'CONNECTED':
        if (event.type === 'EV_AUTH_SUCCESS') {
          this.currentState = 'ACTIVE';
          return;
        }
        if (event.type === 'EV_DISCONNECT' || event.type === 'EV_ERROR') {
          this.currentState = 'CLOSING';
          return;
        }
        break;

      case 'ACTIVE':
        if (event.type === 'EV_DISCONNECT' || event.type === 'EV_ERROR') {
          this.currentState = 'CLOSING';
          return;
        }
        break;

      case 'CLOSING':
        // В состоянии закрытия любые входящие данные игнорируются,
        // а завершение ресурсов переводит автомат в исходную точку
        this.currentState = 'DISCONNECTED';
        return;
    }

    throw new Error(`Недопустимый переход FSM: событие ${event.type} невозможно в состоянии ${from}`);
  }
}
Конечно-автоматное мышление полностью устраняет хаос в многопоточных и асинхронных приложениях. Ты всегда точно знаешь, в каком состоянии находится каждый объект системы, какие переходы разрешены, а какие категорически заблокированы архитектурой.
5. Обработка ошибок, контракты взаимодействия и гарантии идемпотентности
В мире спортивного программирования исключений практически нет: входные данные всегда валидны, а память чиста. В распределенных системах сбои — это не исключительная ситуация, а штатный ежедневный режим работы.
Кабель на коммутаторе может отойти, жесткий диск в RAID-массиве может начать сыпать бэд-секторами, а соседний микросервис может захлебнуться под нагрузкой и перестать отвечать на внешние вызовы.
Надежная серверная архитектура опирается на три защитных барьера:
- Разделение временных и фатальных сбоев (Transient vs Fatal):
- Временные ошибки (Transient): кратковременный сетевой лаг, сброс TCP-соединения балансировщиком, превышение лимита запросов (HTTP 429). Такие сбои требуют повторных попыток выполнения (Retry). Но повторять запросы в лоб нельзя — это мгновенно добьет упавший сервис. Необходима стратегия Exponential Backoff с добавлением случайного шума (Full Jitter), чтобы тысячи клиентов не долбили сервер в одну и ту же миллисекунду.
- Фатальные ошибки (Fatal): нарушение схемы JSON, невалидный токен авторизации, отсутствие запрашиваемой записи в базе. Повторять такие вызовы бессмысленно — они никогда не завершатся успешно. Попытка повтора фатальных ошибок порождает шторм паразитных запросов (retry storm).
- Гарантия идемпотентности операций:
Представь сценарий: мобильное приложение отправляет команду на списание 500 рублей за подписку. Бэкенд списал деньги со счета, сформировал чек, но в момент отправки HTTP-ответа 200 OK вышка связи потеряла сигнал телефона. Клиент не получил подтверждения и показывает ошибку сети. Пользователь нажимает кнопку «Оплатить» еще раз.
Если API спроектировано без поддержки ключа идемпотентности (Idempotency-Key), с баланса спишется еще 500 рублей. В идемпотентной архитектуре сервер запоминает уникальный UUID клиентской операции. При повторном запросе с тем же ключом он не выполняет транзакцию заново, а мгновенно возвращает уже сформированный ранее ответ из кэша. - Предохранители цепи (Circuit Breaker): Если сторонний сервис рекомендаций начинает отвечать с ошибками в 80% случаев, продолжать слать ему синхронные запросы самоубийственно: каждый запрос будет висеть по 5 секунд до тайм-аута, занимая драгоценные сокеты и рабочие потоки твоего основного сервиса. Паттерн Circuit Breaker размыкает цепь: он перестает слать запросы к сбойному сервису и моментально отдает клиенту безопасный фоллбек (например, пустой список рекомендаций или статический кэш), давая внешней системе время на восстановление.
Сегодня, когда многие команды экспериментируют с генерацией кода нейросетями, понимание этих фундаментальных принципов становится критически важным. Как мы отмечали, разбирая вайб-кодинг и архитектурные ловушки, искусственный интеллект может мгновенно сгенерировать синтаксически корректную функцию, но он не способен предвидеть каскадный сбой в распределенной инфраструктуре, если в архитектуру не заложены предохранители и контракты идемпотентности.
6. Модульная декомпозиция и изоляция подсистем без монолитной связности
Финальный и главный уровень зрелости программного инженера — управление архитектурной сложностью.
Студенческий проект или наивный протокол стартапа обычно представляет собой «большой комок грязи» (Big Ball of Mud): контроллеры напрямую лезут в таблицы чужих модулей, функции шлют запросы через глобальные синглтоны, а изменение типа одного поля в профиле пользователя ломает модуль генерации налоговых отчетов.
Тимур Шемсединов в своих инженерных курсах формулирует базовые законы модульной декомпозиции:
- Принцип направленного потока зависимостей (Ports and Adapters / Hexagonal Architecture):
- Бизнес-логика ядра (Domain) должна быть абсолютно чистой. В ней не должно быть импортов внешних библиотек баз данных (будь то TypeORM, Mongoose или pg), сетевых транспортов и специфических форматов передачи.
- Внешний мир (транспорт HTTP, сокеты, брокеры RabbitMQ/Kafka, драйверы PostgreSQL) подключается к ядру исключительно через абстрактные типизированные интерфейсы (порты). Ты можешь полностью заменить сетевой транспорт с WebSockets на gRPC, не изменив ни единой строчки бизнес-правил.
- Изоляция сбоев и переборок (Bulkheading):
Этот термин пришел из кораблестроения: трюм океанского лайнера делится герметичными переборками на независимые отсеки. Пробоина в одном отсеке не приводит к затоплению всего корабля.
В серверной архитектуре критические ресурсы обязаны быть физически изолированы. Пул соединений к базе данных для оформления заказов должен быть отделен от пула соединений для тяжелой внутренней аналитики. Если менеджер запустит гигантский SQL-запрос на выгрузку отчетов за пять лет, аналитический пул соединений исчерпается, но оформление заказов на сайте продолжит работать без малейших задержек. - Отказ от скрытого глобального состояния:
Любое скрытое разделяемое состояние (
global.cache, статические мутабельные переменные класса) — источник непредсказуемых сайд-эффектов и невозможности параллельного тестирования. Все зависимости и контексты выполнения должны передаваться явно через фабричные функции или внедрение зависимостей (Dependency Injection).
Сухой остаток: чему учиться инженеру в 2026 году
Алгоритмическая база полезна: она развивает дисциплину мышления и учит понимать структуру вычислительной сложности. Но LeetCode — это всего лишь разминка для пальцев перед настоящим марафоном.
Настоящая системная инженерия начинается там, где заканчивается идеальная математическая функция:
- В умении мыслить сетевыми пакетами, бинарными заголовками и задержками оборудования;
- В понимании того, как операционная система выделяет память и сколько миллисекунд стоит сборка мусора в высоконагруженном процессе;
- В проектировании строгих конечных автоматов, не боящихся конкурентных гонок и обрывов сокетов;
- В создании устойчивых архитектурных переборок, способных выдержать падение половины зависимостей без деградации пользовательского опыта.
Именно этот фундаментальный инженерный кругозор отличает рядового кодера от архитектора, способного строить надежные и долговечные цифровые системы.