Edición 21 de octubreDigest del día · 11 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 11 materiales
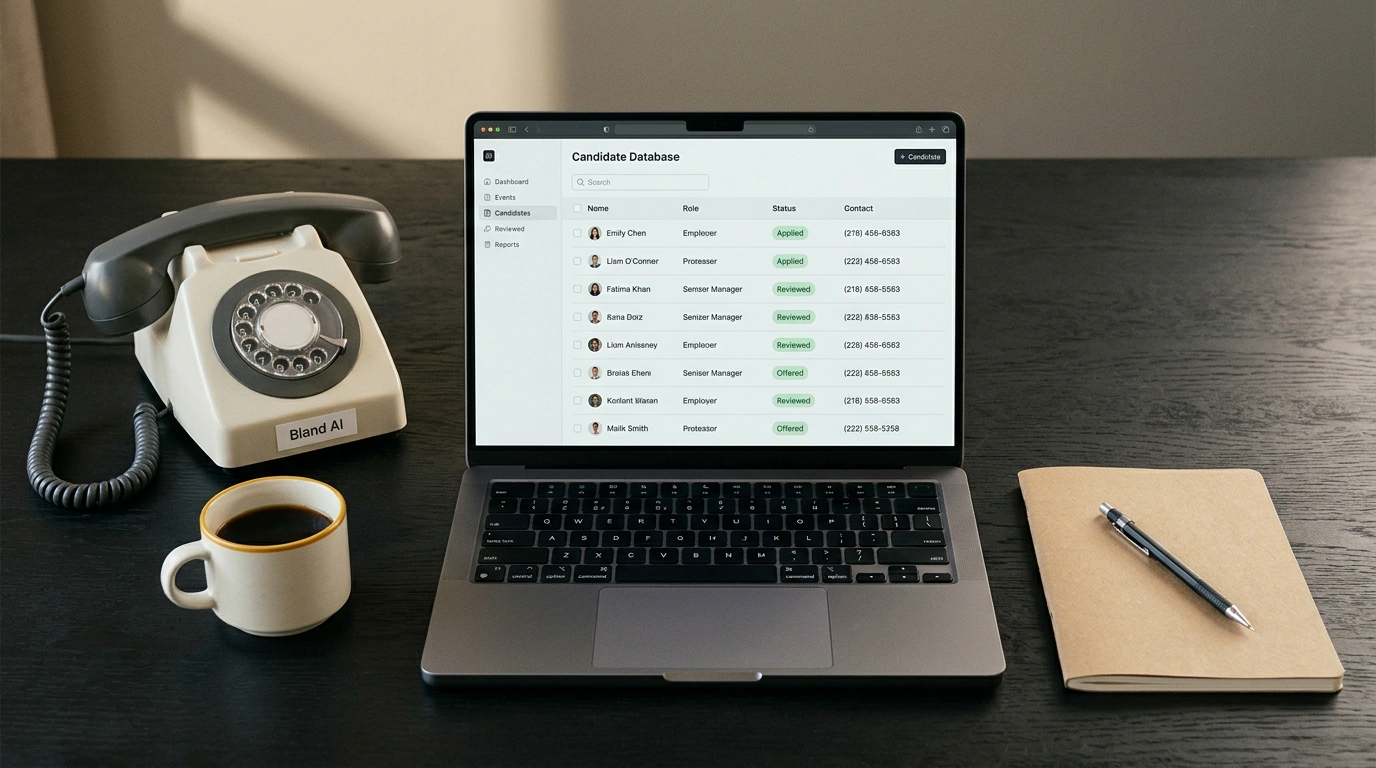
Bodegón escenificado sobre una mesa de madera con un portátil que muestra una tabla de leads en Airtable y un teléfono vintage con la inscripción Bland AI.
ArtículoAgentes de IAAutomatizaciónNegociosGeneración de leads

Arbitraje agéntico: cómo usar Meta Muse para buscar leads y automatizar servicios

Las agencias de selección tradicionales cobran miles de dólares de comisión simplemente porque sus gestores pasan horas revisando a mano grupos locales en redes sociales. Parece que para competir con ellas hacen falta decenas de operadores y un call center. Pero, ¿y si toda esa rutina se condensara en un solo script autónomo?

La combinación de los algoritmos de monitoreo de Meta Muse y los robots telefónicos de Bland AI abre el modelo del arbitraje agéntico: el bot extrae solicitudes de chats desestructurados, normaliza los contactos en una tabla y llama por su cuenta a los candidatos por $15 al mes por línea dedicada. Al final, una sola persona reúne una base privada de profesionales verificados con un margen superior al 80 %.
👍 0
Greg IsenbergBland AI Platform
21 de octubre
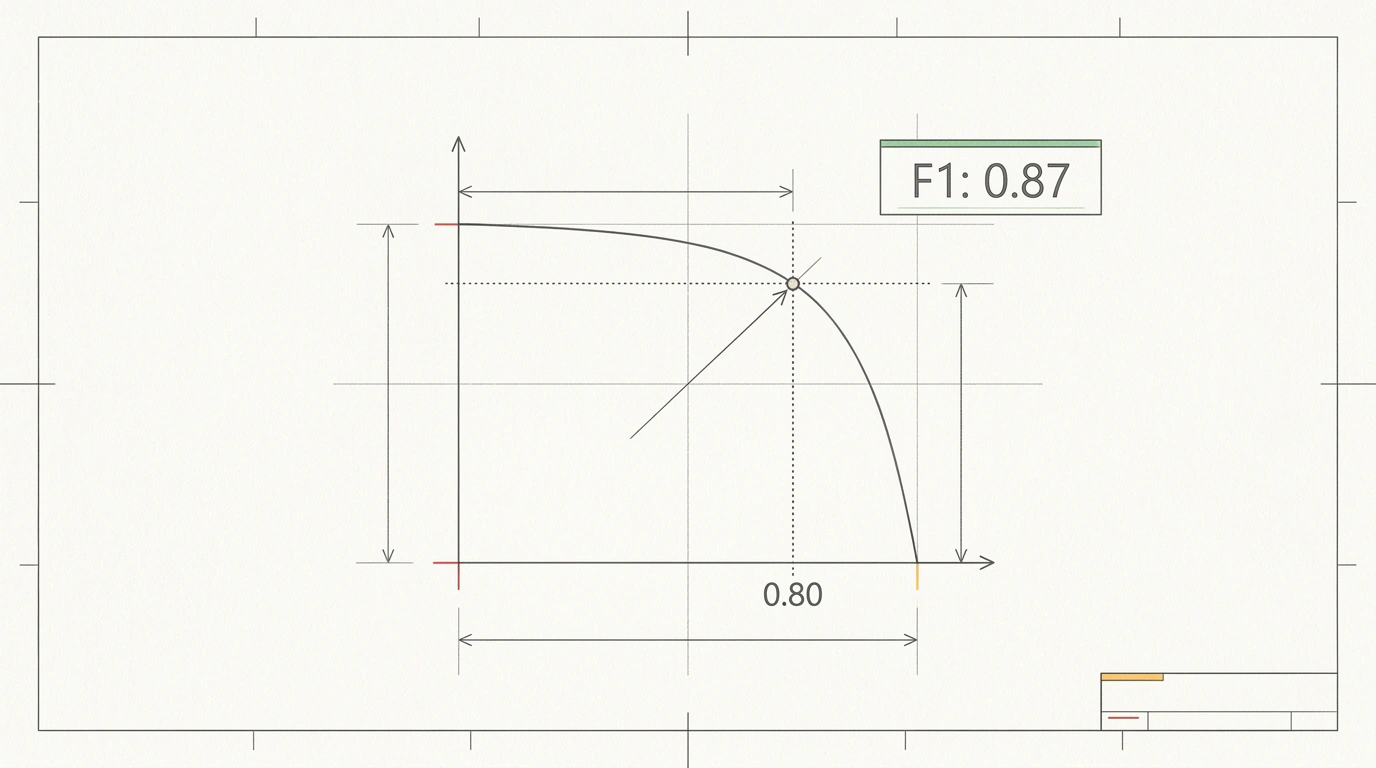
Plano infográfico de calibración de un modelo de decisión sobre papel con un gráfico de la curva Precision-Recall y un umbral de corte en 0.80.
ArtículoLLMDesarrolloDatosAnalítica

Modelos de decisión en lugar de LLM jueces: cómo ajustar umbrales sin arruinarte en evaluación

¿Por qué la mayoría de los equipos fracasan estrepitosamente al evaluar sistemas agénticos? Toman LLM pesados como GPT-4o en el papel de jueces, se arruinan con las facturas de tokens y dejan el umbral de clasificación por defecto en 0.50. Como resultado, el sistema o se ahoga en falsas alarmas o deja pasar fallos críticos.

El estudio de Hamel Husain demuestra que los modelos de decisión especializados como Perplexity Decider o Liquid d1 rinden 10 veces más rápido y barato. Pero el verdadero secreto no está en el nombre del modelo, sino en calibrar las probabilidades y ajustar con precisión el umbral de corte para equilibrar Precision y Recall.

👍 0
Hamel HusainScikit-learn Documentation
21 de octubre
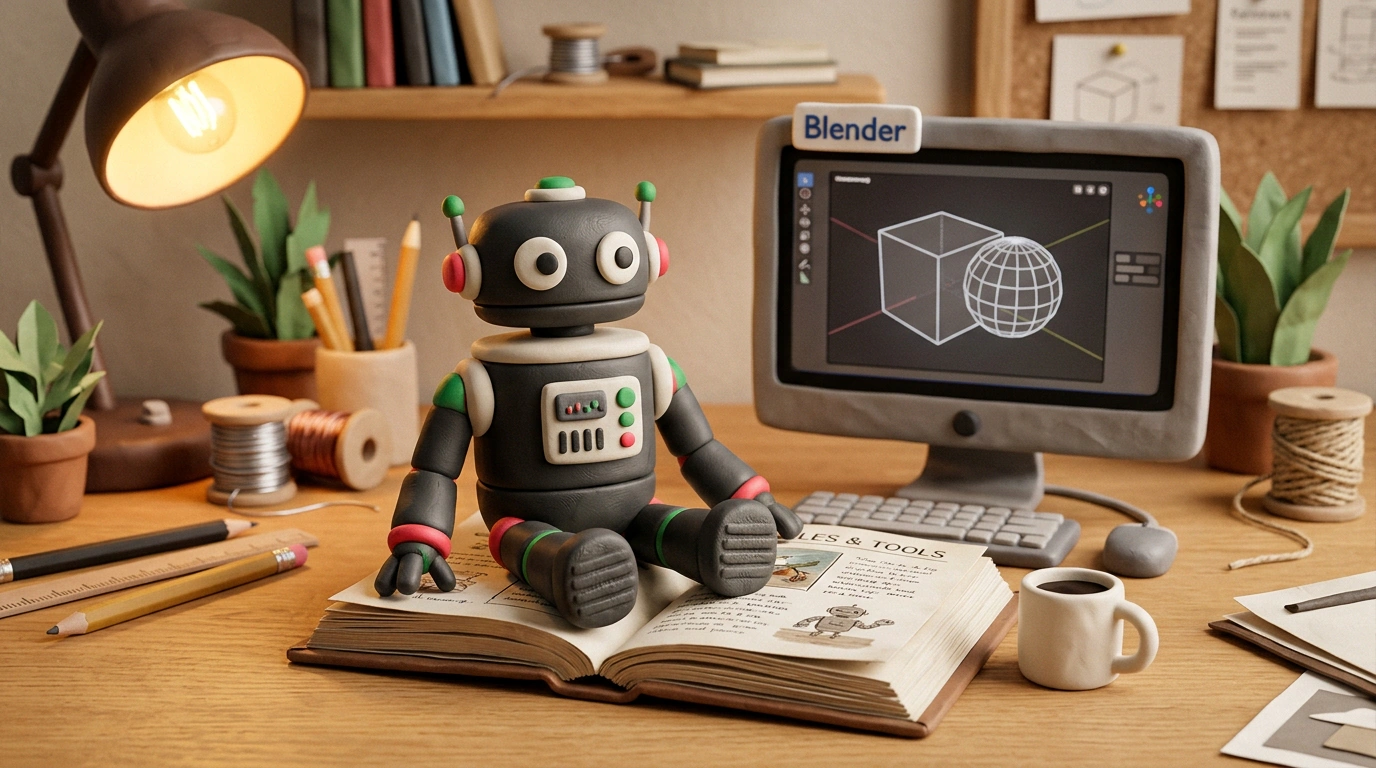
Diorama escultórico de arcilla terracota con un escritorio acogedor y un simpático robot asistente redondo frente a un monitor con una ventana de Blender.
ArtículoIAAgentes de IAAutomatizaciónProductividad

ChatGPT Dots: un agente coordinador personal con máquina virtual aislada

El chatbot clásico te ata a la pantalla: te quedas mirando mientras el modelo termina de generar la respuesta, y si cierras la pestaña todo el proceso se queda colgado. La arquitectura de ChatGPT Dots propone una forma radicalmente distinta de trabajar con la inteligencia artificial.

En lugar de saltar sin fin entre decenas de chats, el usuario conversa con un único agente coordinador que tiene asignada una máquina virtual aislada en la nube. Mientras tomas un café o comentas un proyecto con colegas, Dot abre Blender en segundo plano, construye un modelo 3D, escribe scripts en un sandbox aislado y te envía el vídeo terminado por correo. Así el asistente pasa de ser un simple interlocutor a convertirse en un empleado digital completo.

👍 0
Jason WestRiley BrownChatGPT Dots Features
21 de octubre
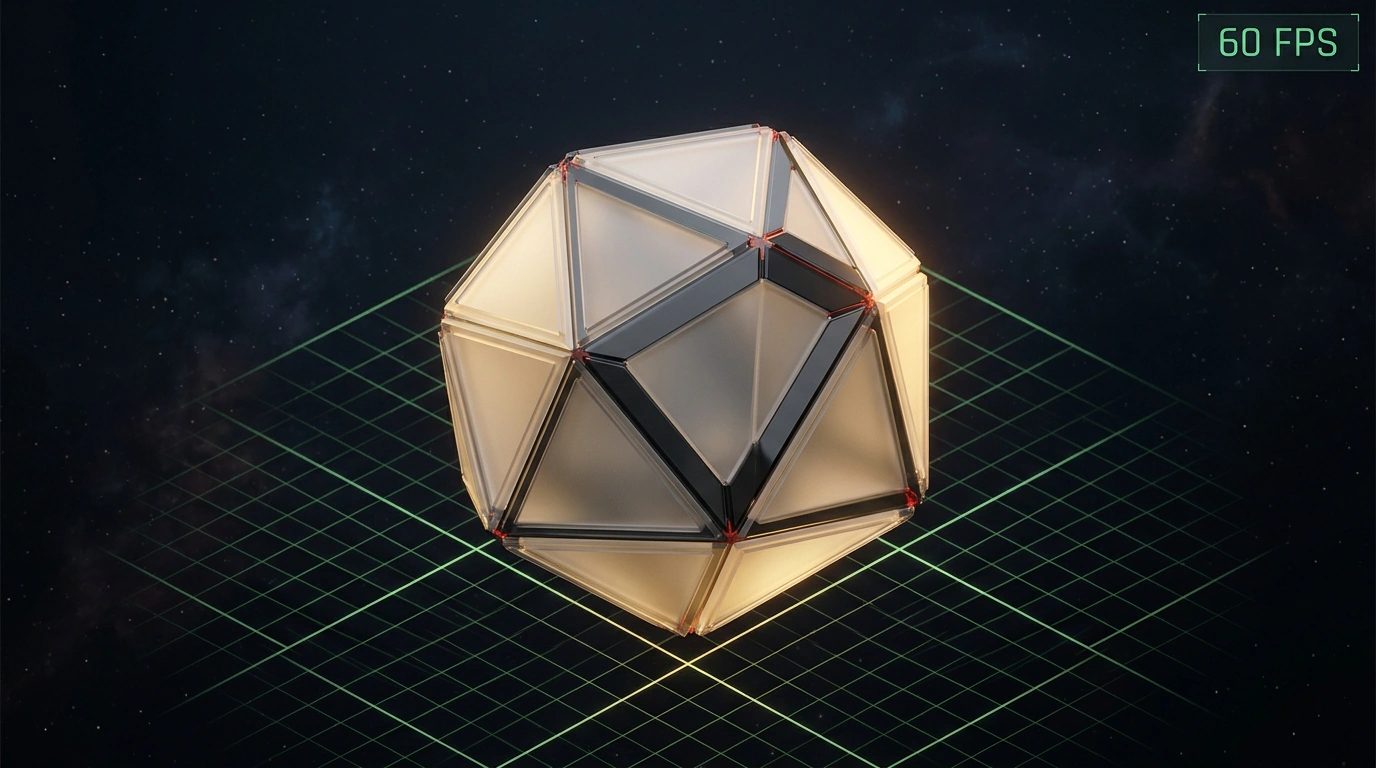
Render 3D de un cristal geométrico procedimental flotante de Three.js sobre una cuadrícula de coordenadas luminosa con una marca de 60 FPS.
ArtículoDesarrolloIAInteligencia artificialThree.js

Mundos 3D en el navegador con un solo prompt: cómo Claude Opus 5.5 genera escenas interactivas en Three.js

«¿De verdad una red neuronal puede montar desde cero un mundo tridimensional interactivo directo en el navegador sin Unreal Engine ni un equipo de modeladores 3D?» Suena a exageración publicitaria, pero la combinación del renovado Claude Opus 5.5 y la librería Three.js demuestra lo contrario en la práctica.

El modelo genera un archivo HTML monolítico y autosuficiente con escena WebGL, iluminación procedimental y partículas, listo para funcionar en cualquier dispositivo. Además, Claude no se limita a escribir código: lo prueba por sí mismo en un navegador virtual, mide los FPS, detecta errores de «pantalla negra» y corrige caídas de rendimiento antes de entregar el resultado al usuario.

👍 0
Julian Goldie SEOThree.js Documentation
21 de octubre
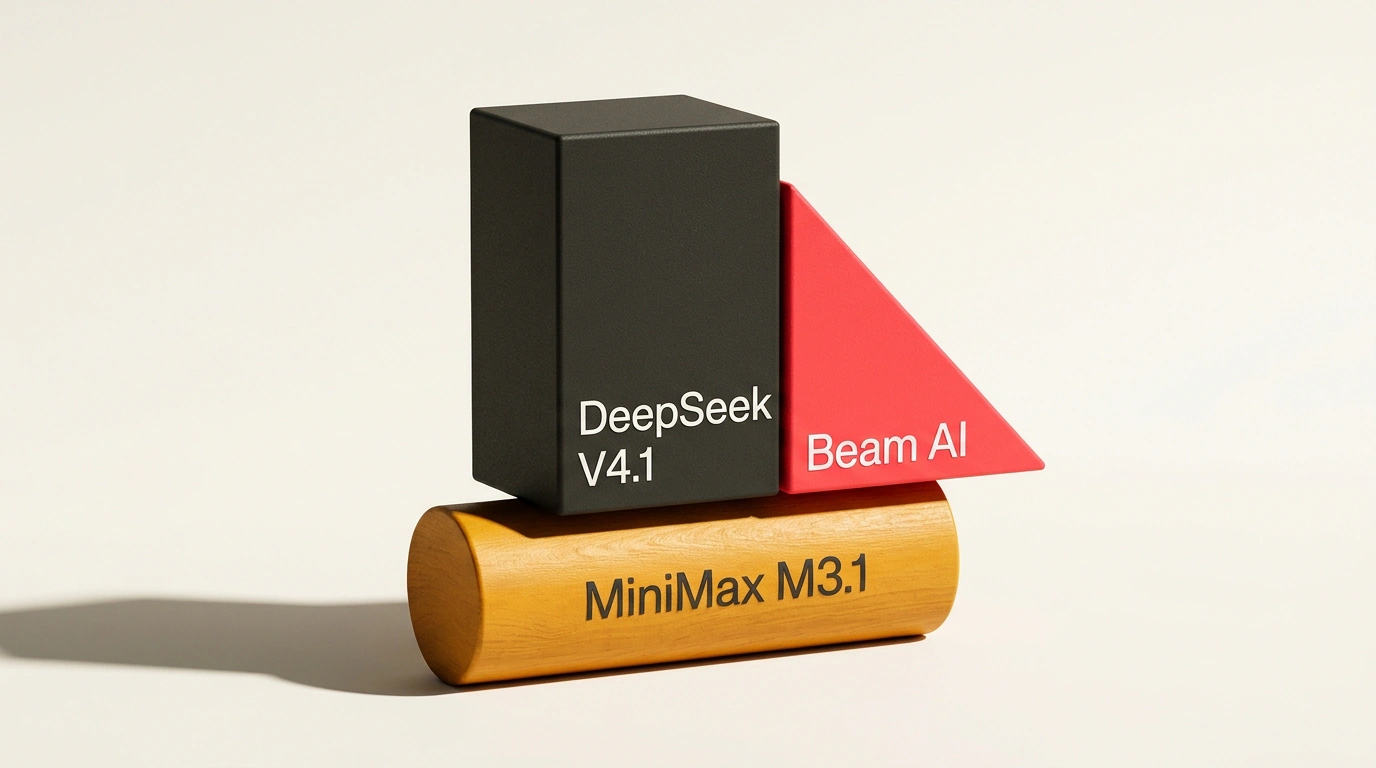
Composición modular de estilo Bauhaus formada por tres prismas geométricos de colores con los nombres de los modelos DeepSeek, Beam AI y MiniMax.
Resumen temático3 seccionesOpen SourceLLMAgentes de IADesarrollo

Trío de modelos rápidos para agentes: DeepSeek V4.1 Flash, Beam AI y MiniMax M3.1 Flash

Intentar construir pipelines autónomos solo con modelos tope de gama como Claude Opus o GPT-5 es la vía más rápida para fundir el presupuesto en un par de días. La industria ha optado por dividir papeles: la planificación pesada queda para los gigantes, y las acciones rutinarias de muchos pasos pasan a un trío ligero y veloz:

  • DeepSeek V4.1 Flash: contexto de 1 millón de tokens y pasarela gratuita Token Harbour para procesar registros voluminosos en streaming;
  • Beam AI: modelo MoE abierto de Reflection AI (501B de parámetros), entrenado para navegar en la web sobre 100 millones de iteraciones agénticas;
  • MiniMax M3.1 Flash: aceleración triple en tareas rutinarias y regulador de 5 posiciones para la profundidad de razonamiento según el tipo de tarea.

Esta combinación reduce el gasto en API entre 5 y 10 veces sin perder ni un ápice de calidad en la automatización.

👍 0
Julian Goldie SEOToken Harbour API
21 de octubre
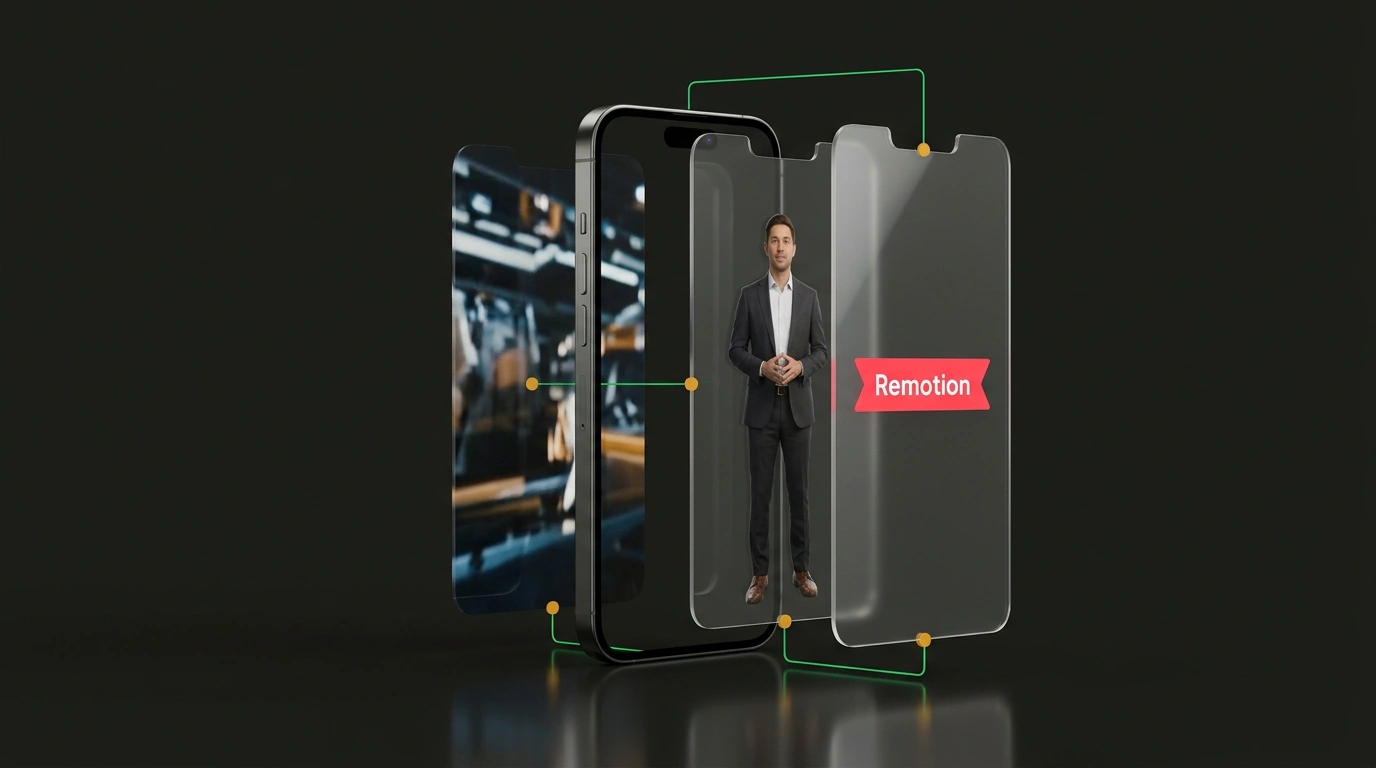
Diagrama de explosión de montaje de un vídeo con capas flotantes de código React en Remotion, un avatar digital y un rótulo dinámico.
ArtículoAutomatizaciónContenidoProducción de videoInteligencia artificial

Automatización de avatares de vídeo: un flujo con HeyGen, Remotion y planificador agéntico

Los vídeos con avatares de IA estándar provocan bostezos: una «cabeza parlante» estática sin ritmo ni planos de recurso pierde el 80 % de la atención ya en el tercer segundo. Pero si montas cada clip a mano en Premiere o CapCut, toda la idea de automatizar se desmorona ante tus ojos.

La solución llegó con un sistema híbrido en tres capas que une la generación del personaje en HeyGen con el montaje programático por código en Remotion. En lugar de cortar pistas manualmente en la línea de tiempo, el agente controla las capas del vídeo mediante componentes de React: superpone B-roll dinámico, anima rótulos y renderiza por CLI un lote completo de vídeos verticales sin intervención humana.

👍 0
Julian Goldie SEORemotion Documentation
21 de octubre
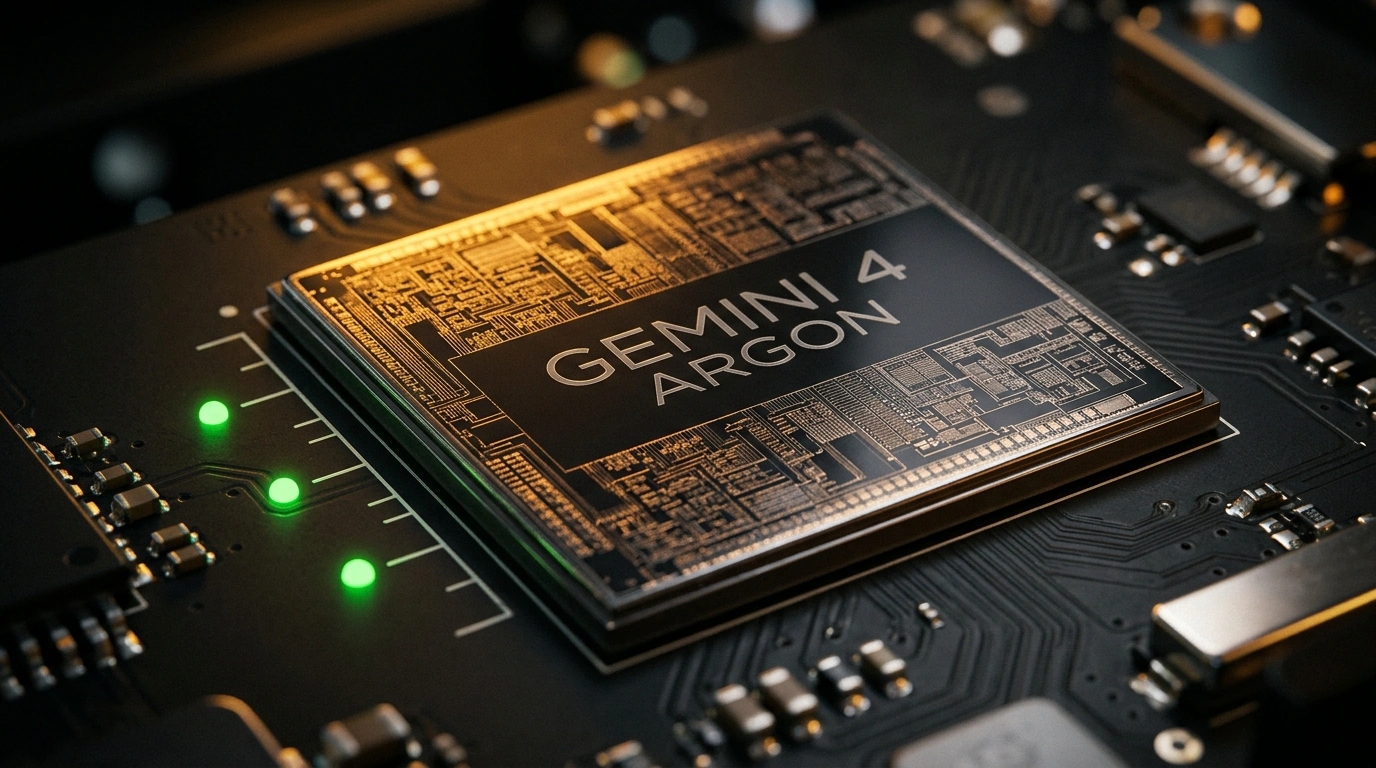
Fotografía macro de un neurochip de silicio con pistas doradas, tres núcleos lógicos y el grabado Gemini 4 Argon.
ArtículoIAInteligencia artificialLLMBenchmarks

Gemini 4 Argon: un millón de tokens de salida, tres modos de pensamiento e integración con Manus

Google lanzó su esperado modelo insignia Gemini 4 Argon, y no se trata de otro retoque cosmético para subir puntos en benchmarks. El gran salto tecnológico del lanzamiento es la función long decode, que permite al modelo no solo leer, sino generar hasta 1 millón de tokens de salida continua dentro de un mismo espacio de sesión.

El modelo ignora por completo parámetros aleatorios como la temperatura y se controla mediante un regulador de tres niveles para la profundidad de razonamiento. En las pruebas de Vals Index ocupó el primer puesto con 68.9 puntos, y en el entorno Google Anti-Gravity redujo los retrocesos de código casi en un tercio. No sorprende que la plataforma agéntica Manus integrara Argon en sus flujos desde el primer día de lanzamiento.

👍 0
Julian Goldie SEOGoogle AI Studio
21 de octubre
Toma cinematográfica en primera persona frente a una pantalla con una tarjeta de automatización de Manus y el botón de aprobación manual Approve.
ArtículoAutomatizaciónAgentes de IAProductividadIntegraciones

Piloto automático por eventos: cómo funcionan los disparadores, horarios y webhooks en Manus 2.0

La mayoría de los asistentes de IA actuales sufren el síndrome de la espera pasiva: se quedan quietos en la ventana del chat y no mueven un dedo hasta que tú mismo pegas la tarea y pulsas Enter. La actualización del motor Automations en Manus 2.0 transforma al agente de un interlocutor pasivo en un sistema operativo reactivo.

La plataforma lanza tareas según horarios, webhooks entrantes y eventos en aplicaciones de trabajo, desde un nuevo pull request en GitHub hasta un correo reciente en Gmail o un pedido en Shopify. Además, el flujo incluye un punto obligatorio de aprobación manual (Human-in-the-Loop) que protege al negocio frente a acciones no autorizadas del agente en el mundo exterior.

👍 0
Julian Goldie SEOManus Platform
21 de octubre
Cómic europeo minimalista de estilo Ligne Claire con un desarrollador conectando su portátil a un servidor mediante un túnel seguro de Tailscale.
ArtículoAgentes de IAAutomatizaciónOpen SourceObsidian

Cinco mejoras de Hermes Agent OS: memoria compartida en Obsidian, agente de voz y Tailscale

¿De qué sirven los asistentes de IA locales inteligentes si al cerrar el portátil se borra su memoria y no puedes acceder a ellos desde el móvil? El sistema operativo abierto Hermes Agent OS, del equipo Nous Research, lanzó un paquete de 5 grandes mejoras de infraestructura:

  • Memoria compartida con Obsidian Sync MCP: todos los agentes leen y actualizan un único almacén local de conocimiento en Markdown sin vendor lock-in;
  • Agente de voz Apollo: conversación continua en segundo plano con el agente sin suscripciones adicionales;
  • Túnel seguro Tailscale: control remoto protegido de tu servidor doméstico de agentes desde el teléfono en 10 minutos de configuración;
  • Workers Pop-Up desechables: lanzamiento instantáneo de agentes ligeros para tareas puntuales con autodestrucción;
  • Agentes de búsqueda GEO: optimización de contenidos para las respuestas de buscadores con IA.

Esta arquitectura reúne scripts dispersos en un auténtico centro de control personal.

👍 0
Julian Goldie SEOHermes Agent Documentation
21 de octubre
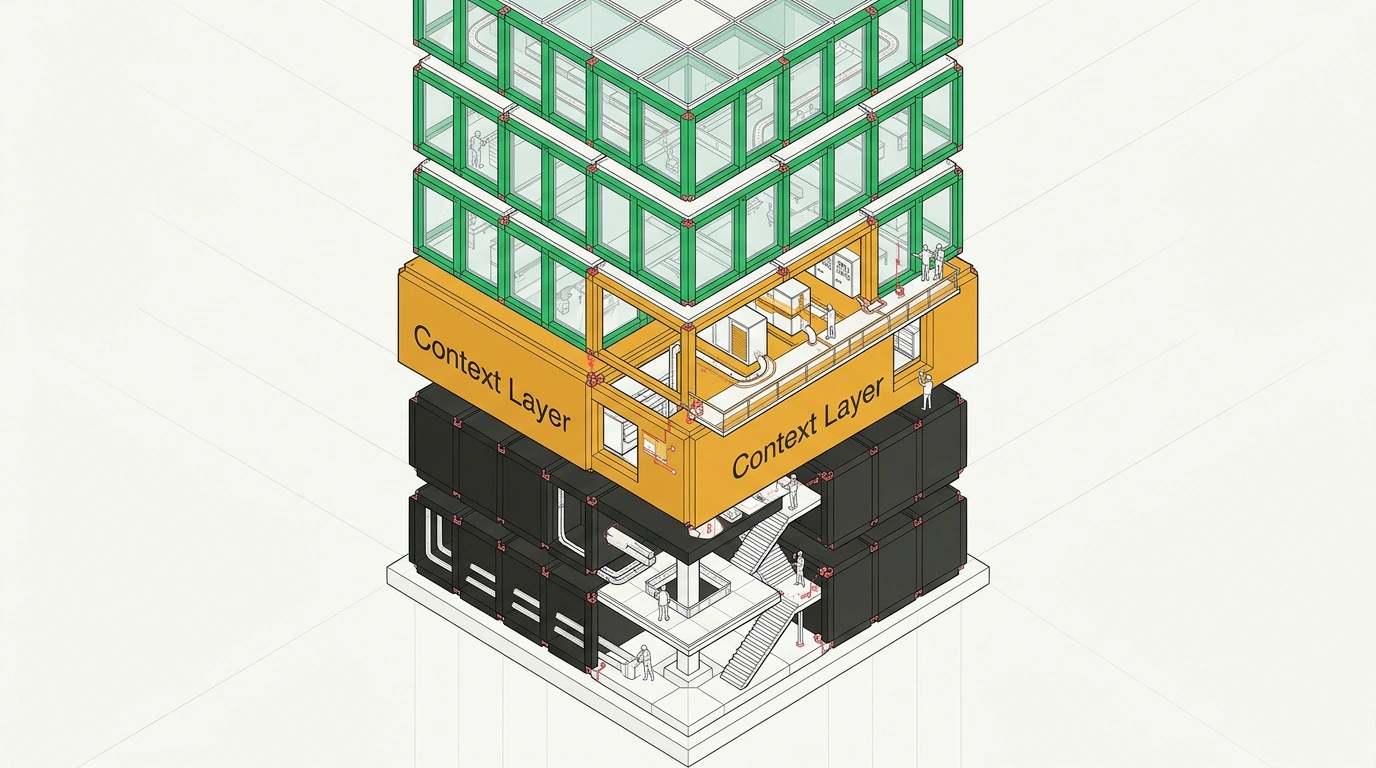
Corte arquitectónico de una torre modular de plataforma de IA corporativa compuesta por siete pisos estandarizados de colores.
ArtículoNegociosEstrategiaAgentes de IAAutomatización

Frena el desarrollo a medida: las 7 capas de plataformas que reemplazarán los inventos agénticos caseros

Las empresas queman de forma masiva cientos de miles de dólares en desarrollo a medida de sistemas de IA «llave en mano», atando cadenas frágiles de scripts con cinta aislante. Pero con cada actualización de los modelos base de OpenAI o Anthropic, esos añadidos personalizados se rompen y se convierten en un lastre gigantesco.

El fundador de la agencia AI Makeover, Liam Ottley, compara el mercado actual con la era de los primeros automóviles antes de la cadena de montaje de Henry Ford. Es hora de que las empresas dejen de reinventar la rueda y pasen a la «sala de espera» de las plataformas maduras: centrarse en estructurar sus propios datos y reglamentos (Context Layer) y dejar la orquestación de bajo nivel en manos de servicios estandarizados.

👍 0
Liam OttleyLiam Ottley Frameworks
21 de octubre
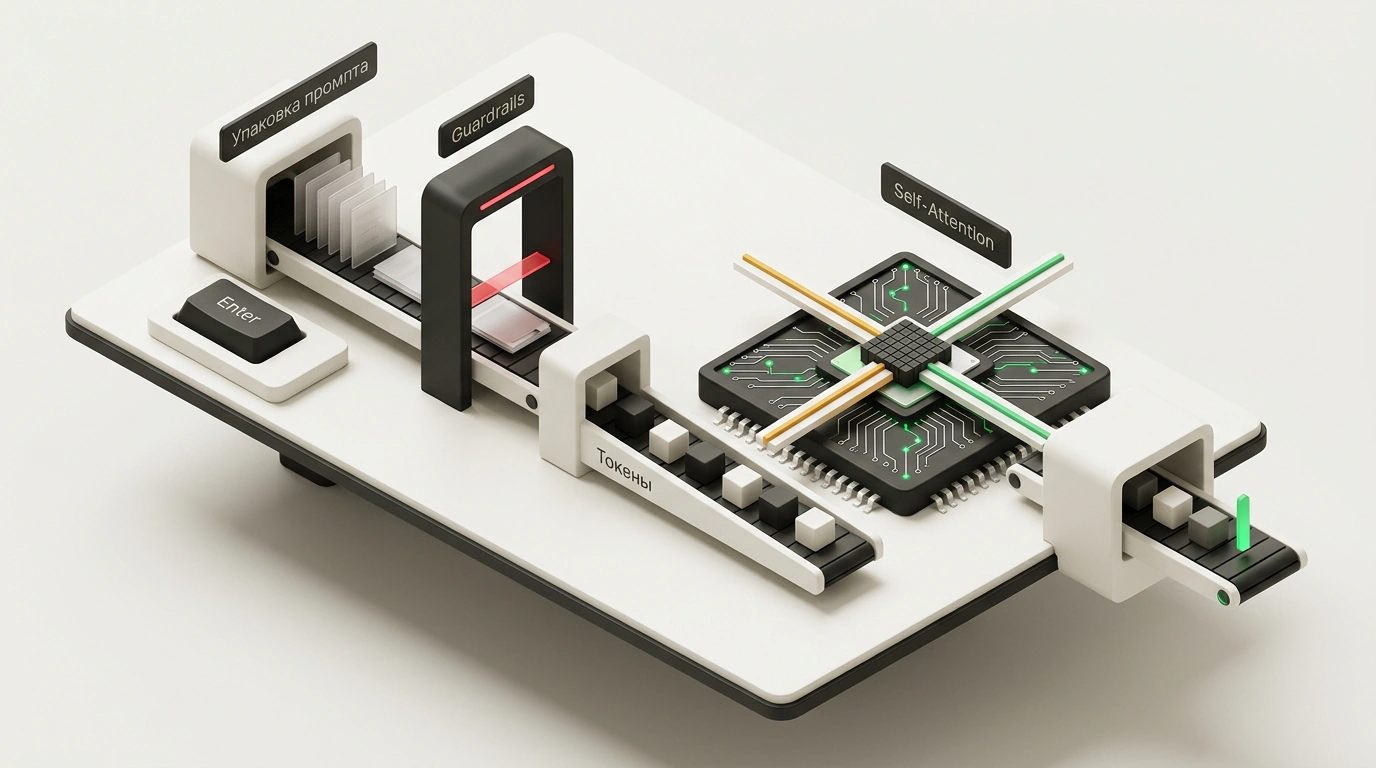
Corte isométrico arquitectónico del pipeline de procesamiento de una petición a ChatGPT: el recorrido desde la entrada de la orden, pasando por los filtros de seguridad y la tokenización, hasta las matrices de atención de silicio Self-Attention.
A fondoLLMAlgoritmosInteligencia artificialArquitectura

Anatomía de una petición a ChatGPT: del empaquetado del prompt a la cuantización y llamada a herramientas

Pulsas Enter en la barra de entrada de ChatGPT, pasan un par de segundos y en pantalla empieza a escribirse una respuesta ordenada. ¿Qué ocurre físicamente durante ese brevísimo instante en los chips de silicio del centro de datos? En contra de los mitos habituales, el modelo no «piensa» como una persona ni guarda en su interior un saber secreto sobre todo lo que existe.

Detrás de cada respuesta hay una maquinaria de ingeniería colosal: empaquetado invisible del contexto con instrucciones del sistema de miles de palabras, revisión instantánea con filtros ligeros de guardrail, corte del texto en tokens, batching en clústeres de procesadores gráficos y multiplicación de matrices Query, Key y Value en el mecanismo Self-Attention. Entender esta física le quita el aura mística a las «alucinaciones» y explica por qué las redes neuronales fallan en aritmética escolar básica.

👍 0
Nick SaraevAttention Is All You Need Paper
21 de octubre