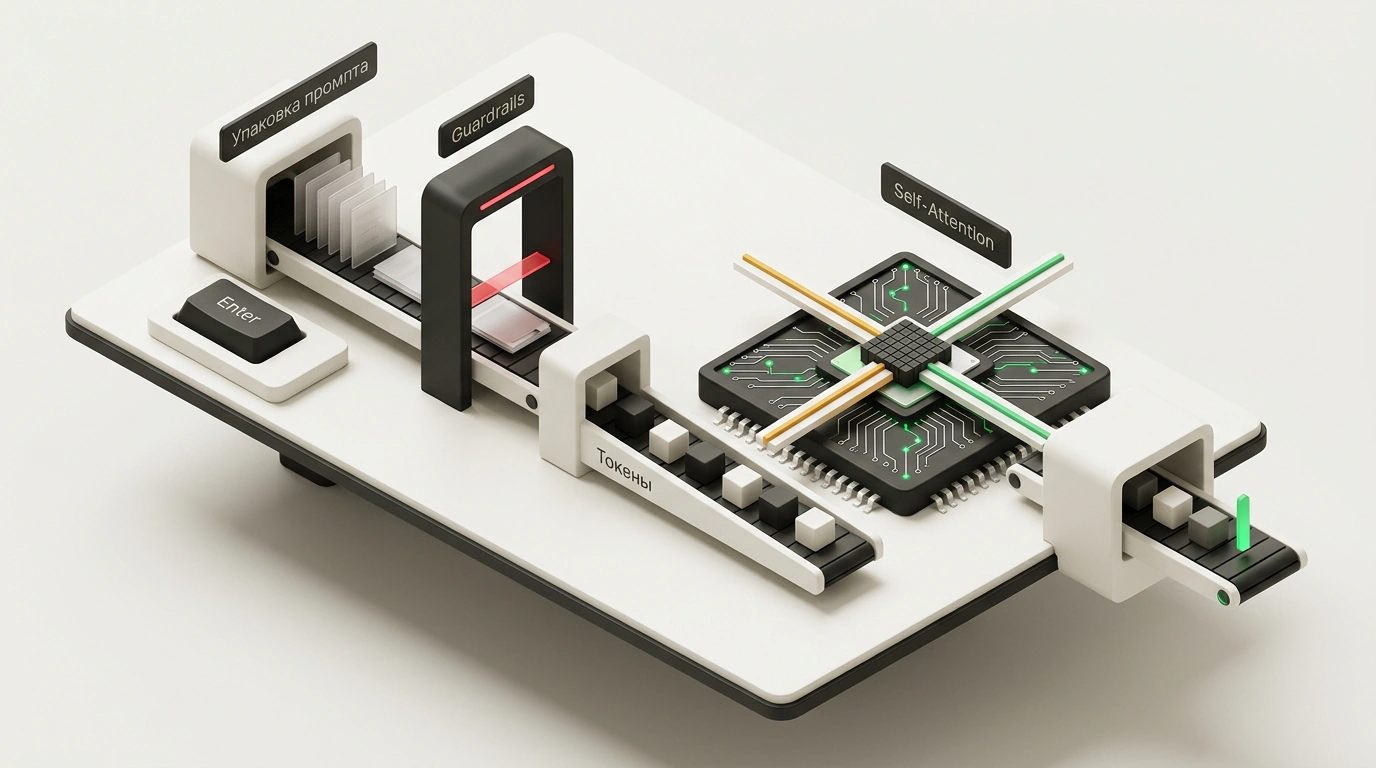
Imagina una escena cotidiana: abres el navegador, escribes en la barra de ChatGPT una pregunta sencilla —por ejemplo, «Explica por qué el cielo es azul»—, pulsas Enter y un par de segundos después ves cómo el cursor va dibujando líneas ordenadas de texto.
En el imaginario popular todo ese proceso parece envuelto en ciencia ficción. La gente cree que en algún armario oscuro de servidores hay un cerebro digital superinteligente que se ha leído todo internet, «reflexiona» sobre tu pregunta y suelta un veredicto sabio de experto.
Quitémosle el barniz y encendamos los rayos X de ingeniería. En ese segundo y medio mientras parpadea el cursor, tu petición recorre un viaje complejísimo por una decena de sistemas de software y hardware independientes. El investigador Nick Saraev descompuso ese camino paso a paso, y hoy te propongo desarmar el mecanismo pieza por pieza: desde los metadatos invisibles en tu navegador hasta la multiplicación de matrices en los chips de silicio del centro de datos.
Capa 1: La maleta invisible — empaquetado del contexto en el cliente
La primera ilusión que conviene soltar: el modelo nunca recibe tu pregunta en estado puro. Cuando envías una frase de cinco palabras, la aplicación cliente arma un paquete oculto bastante pesado, conocido como Prompt Packing.
En esa «maleta» digital se guarda una cantidad enorme de información de servicio:
- Prompt del sistema (System Instructions): directivas base de los desarrolladores que fijan el carácter del modelo, el tono, el formato y las prohibiciones. En sistemas avanzados como Claude de Anthropic, este texto invisible supera las 3000 palabras.
- Marcas temporales y geográficas: la fecha exacta de la consulta, el día de la semana, la zona horaria del usuario y una ubicación aproximada para que el modelo sepa en qué año y momento del día está respondiendo.
- Memoria a largo plazo: un bloque de datos guardados sobre ti (tu profesión, tu stack tecnológico, tu estilo preferido de respuesta). Ya vimos en detalle cómo gestionar esta capa de memoria en la práctica en la guía sobre ChatGPT Work.
- Historial de la conversación previa: todo el hilo actual del diálogo con cada pregunta y respuesta anterior, etiquetado con roles de sistema (
system,user,assistant).
Al final, tus cinco palabras inocentes se transforman en un documento técnico de varias páginas antes incluso de salir de la tarjeta de red de tu portátil.
Capa 2: Los guardianes de la entrada — preclasificadores de seguridad
Antes de dejar pasar una petición pesada hasta el corazón de cómputo del sistema, la infraestructura en la nube debe asegurarse de que no intentas vulnerarla. La consulta pasa por la barrera de Guardrails, clasificadores ligeros de seguridad.
¿Para qué montar un filtro aparte? Por pura economía. Pasar cada texto entrante por el modelo insignia, que cuesta decenas de centavos, sería un despilfarro. En su lugar, en la puerta vigilan modelos diminutos especializados en una sola tarea: detectar al instante intenciones maliciosas (jailbreaks, intentos de extraer instrucciones internas del sistema o peticiones para sintetizar sustancias tóxicas y malware).
En Anthropic, introducir estos preclasificadores redujo el éxito de los ataques al sistema del 90 % a un discreto 4–5 %, consumiendo menos del 1 % del presupuesto total de cómputo de la sesión. Si el modelo guardrail huele algo raro, la petición se bloquea al instante con una respuesta estándar o se desvía hacia una rama ultraconservadora con moderación reforzada.
Capa 3: La picadora de significados — la tokenización y sus trampas
Si la revisión de seguridad da luz verde, llega la etapa de tokenización. Es uno de los puntos menos intuitivos para quienes empiezan: las redes neuronales no saben leer letras, sílabas ni palabras. Para un procesador de silicio, las letras no significan nada. El ordenador solo entiende números.
Un algoritmo específico (como Byte-Pair Encoding, con un vocabulario de alrededor de 200 000 tokens en los modelos actuales de OpenAI) corta el texto continuo en fragmentos llamados tokens, cada uno con un identificador entero único.
En inglés, un token cubre de media unos 4 caracteres (cerca del 70 % de una palabra típica). Pero con otros alfabetos, fórmulas matemáticas y términos poco frecuentes empiezan las anomalías curiosas. Y justo aquí está la explicación de dos «enfermedades infantiles» clásicas de la inteligencia artificial:
- ¿Por qué la IA no sabe contar letras en una palabra? Recuerda el famoso meme de la palabra strawberry («fresa»), donde los modelos fallaban una y otra vez al contar tres letras «r». Ocurre porque el tokenizador parte esa palabra en tres bloques numéricos predefinidos:
st(token 499),raw(token 4492) yberry(token 9467). El modelo ve una secuencia de tres números, pero no tiene ni idea de qué letras individuales hay dentro. - ¿Por qué los modelos de lenguaje cojean en aritmética? Los números se trocean de manera irregular según la frecuencia con la que aparecieron en el conjunto de entrenamiento. El número
1984puede ser un único token, mientras que el vecino19845se parte en198y45. Para el modelo no son cantidades en una recta numérica, sino símbolos abstractos, así que multiplicar a mano se convierte en un juego de adivinanzas.
Capa 4: Batching en clúster y el silicio del centro de datos
Convertida en un arreglo compacto de números, tu petición viaja por cables transcontinentales de fibra óptica hasta el centro de datos. Allí no la esperan ordenadores personales, sino racks monstruosos cargados con aceleradores gráficos NVIDIA H100 o B200 conectados por buses ultrarrápidos NVLink.
Y aquí los ingenieros chocan con la física cruda: a una GPU no le sale rentable procesar tu consulta en solitario. Si mueves matrices de pesos para un único usuario, el 95 % de los núcleos de cálculo del chip se quedan parados esperando a leer datos de la memoria.
Para exprimir el silicio al 100 %, el planificador del servidor (con frameworks como vLLM o TensorRT-LLM) agrupa peticiones de cientos de usuarios distintos en un único paquete paralelo: un lote (Batch). Tu pregunta sobre un gato, el script en Python de otra persona y la traducción de una receta se pegan en un solo tensor gigante y atraviesan a la vez las unidades de cálculo de la GPU.
Para que miles de millones de parámetros quepan físicamente en la memoria de vídeo rápida, los pesos se someten a cuantización: los valores numéricos pasan de un formato pesado de coma flotante de 16 bits (FP16) a formatos compactos de 8 bits (FP8) o incluso 4 bits (INT4), calibrados con precisión quirúrgica para no degradar la lógica.
Capa 5: El mecanismo Self-Attention — cómo se calcula el sentido
Llegamos al mayor triunfo tecnológico del siglo XXI: la arquitectura Transformer, propuesta por investigadores de Google en el célebre artículo de 2017 «Attention Is All You Need» (Vaswani et al.).
Corte isométrico infográfico del bloque de atención Self-Attention con multiplicación vectorial de matrices Query, Key y Value.
Cada capa del transformer ejecuta una operación fundamental: el mecanismo de autoatención (Self-Attention). Para cada token se crean tres vectores:
- Query (Consulta): «¿Qué estoy buscando en este contexto?»
- Key (Clave): «¿Qué significado aporto a las demás palabras?»
- Value (Valor): «¿Qué información semántica voy a transmitir hacia adelante?»
Veámoslo con un ejemplo cotidiano clásico. Piensa en la palabra inglesa bank. ¿Significa la orilla de un río (river bank) o una entidad financiera que concede préstamos (bank loan)?
Cuando bank aparece en una oración, su vector Query se multiplica por los vectores Key de todas las demás palabras del texto. Si cerca aparece river o water, su producto escalar matemático se dispara y surge un coeficiente de atención alto entre ambas. La palabra bank absorbe las propiedades vectoriales de río. Si en cambio cerca está deposit o money, el vector de atención tira del sentido hacia las finanzas. Así, sin una pizca de conciencia humana y mediante pura multiplicación de matrices, el algoritmo capta con precisión el contexto de cada palabra.
Capa 6: Nacimiento autorregresivo de la respuesta y la salvadora KV-cache
Tras atravesar decenas de capas de atención, el modelo llega a la capa final. Y aquí reside un principio esencial de los LLM modernos: el modelo nunca sabe cómo va a terminar su frase. Funciona de modo estrictamente autorregresivo, es decir, predice exactamente un único token siguiente cada vez.
A la salida obtiene un arreglo gigante de probabilidades para los 200 000 tokens del diccionario (logits pasados por la función Softmax). El algoritmo de muestreo elige una palabra (o fragmento de palabra) estadísticamente adecuada y la muestra en pantalla.
¿Y qué pasa después? Para generar el segundo token, el modelo tiene que volver a procesar toda la petición original más el primer token recién generado. Para el tercer token repite el proceso desde cero.
Si los ingenieros hicieran esto a fuerza bruta, el tiempo de generación crecería de forma exponencial y los servidores se derretirían al instante. La salvación llegó con el mecanismo KV-caching (Key-Value Cache). Todos los vectores de claves y valores ya calculados para las palabras previas se guardan con cuidado en la memoria ultrarrápida HBM3e del chip gráfico. En cada paso nuevo, el modelo calcula la atención solo para el token recién añadido y consulta la caché ya lista del contexto anterior.
Capa 7: Bifurcación de decisiones — punto de parada o llamada a herramienta
Cada vez que genera un token nuevo, el modelo evalúa una bifurcación de instrucciones internas:
- Token de fin de texto (
<end_of_text>): el algoritmo entiende que la idea está completa, rompe el ciclo autorregresivo y cierra la conexión con el cliente. - Tokens de razonamiento oculto (Chain-of-Thought): en modelos de razonamiento (como OpenAI o1 o Gemini 4 Argon), el token puede pertenecer a un bloque interno de pensamiento. El modelo sigue dialogando consigo mismo en un monólogo oculto, comprobando hipótesis, y no muestra ese texto al usuario hasta cerrar la respuesta final.
- Token de llamada a herramienta (Tool Call): si para responder necesita cotizaciones bursátiles recientes o ejecutar una calculadora, genera un token de control especial. En ese instante la generación de texto se pausa. El modelo emite un JSON estructurado con el nombre de la función y sus argumentos. El entorno externo recoge ese JSON, lanza una petición HTTP real a una API o ejecuta código Python en un sandbox, toma el resultado y lo inyecta de vuelta en el contexto como un mensaje nuevo con el rol
tool. Acto seguido, la generación se reanuda.
A menudo se oye la queja indignada: «¡La IA me mintió descaradamente!». Entender este flujo explica el origen del fenómeno. El modelo es físicamente incapaz de «mentir», porque no maneja el concepto de verdad o mentira. Dentro del transformer solo ocurre una selección continua de la continuación estadísticamente más probable de una distribución de texto. Si en el entrenamiento o en el contexto entregado faltan datos exactos, el modelo no se calla avergonzado: toma el vector matemáticamente más cercano y fabrica una alucinación convincente pero inventada.
La próxima vez que pulses Enter en la barra de entrada, recuerda esta gran sinfonía de silicio. En un par de segundos tu pregunta se llenó de contexto del sistema, pasó por filtros de seguridad, se partió en tokens numéricos, viajó empaquetada junto a miles de ideas ajenas, atravesó terabytes de matrices de atención y se rearmó pieza a pieza en frases humanas comprensibles. No es magia: es un triunfo de la ingeniería aplicada.