Si has probado a montar sistemas multiagente complejos, seguro que te has llevado un susto desagradable en la factura a final de mes. Sobre el papel la idea suena preciosa: creas un agente orquestador sobre un modelo insignia potente como Claude Opus 5.5 o DeepSeek-R1, le das la herramienta de delegación (delegate_task) y él solito trocea el proyecto en decenas de subtareas lanzando subagentes hijos.
Pero en la vida real ese esquema quema el saldo de la API en un suspiro. ¿Por qué? Porque en la mayoría de los frameworks básicos todos los subagentes generados heredan a la fuerza el modelo del padre. Imagínate: un modelo pesado de razonamiento gastando cuarenta segundos y miles de tokens caros de «pensamiento» solo para filtrar una lista de direcciones IP en un archivo de texto o comprobar el código de estado de un servidor web. Es como contratar a un catedrático de matemáticas para fregar el suelo del laboratorio.
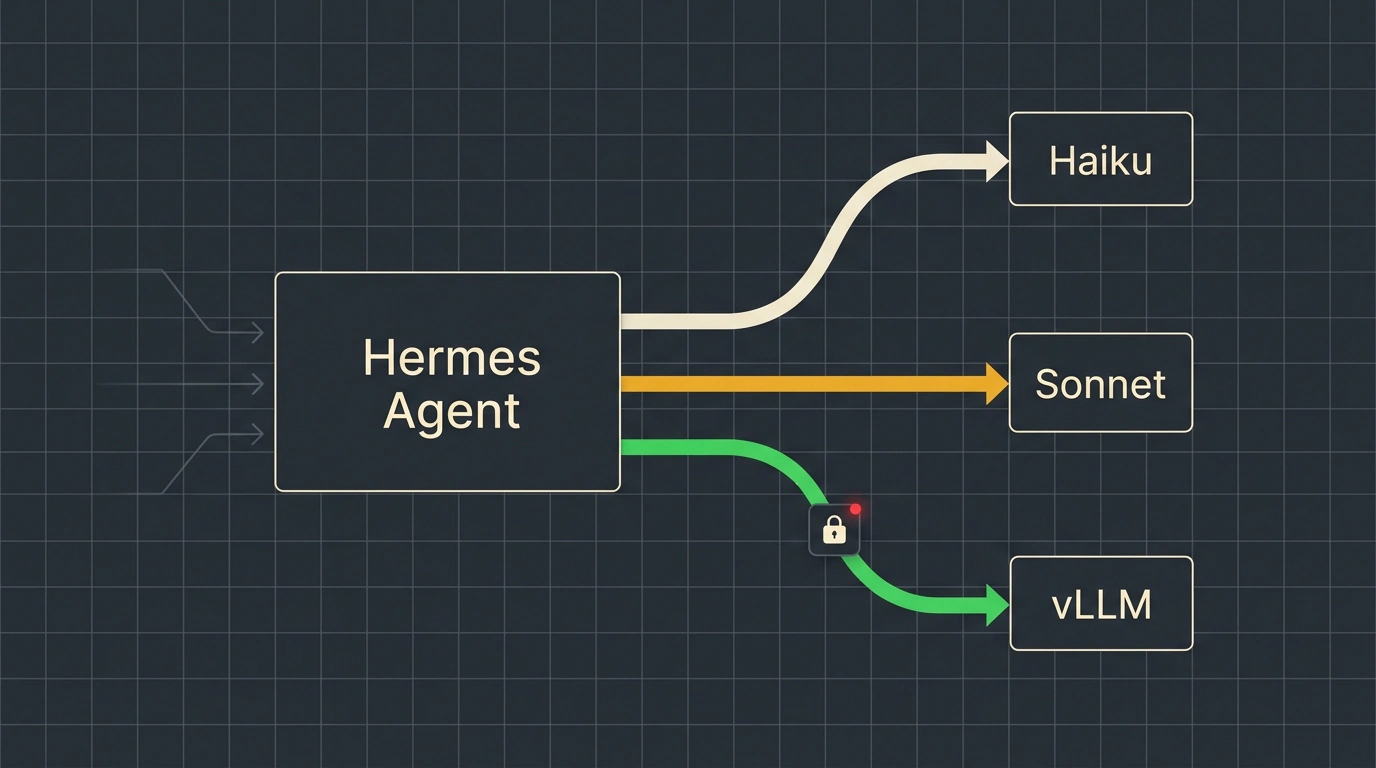
El laboratorio de investigación Nous Research ha resuelto ese problema lanzando el plugin oficial Advanced Delegation v1.0 para su popular agente abierto Hermes Agent (a partir de la versión 0.22.5). El plugin introduce un mecanismo completo de enrutamiento dinámico de tareas entre distintos modelos y perfiles aislados. Veamos cómo funciona este balanceador por dentro.
Dos modos de enrutamiento: Model Routes frente a Profile Routes
La arquitectura de Advanced Delegation ofrece dos enfoques complementarios para repartir el trabajo:
- Modo de rutas con nombre (Model Routes). Creas en el archivo de configuración perfiles abstractos de potencia. Por ejemplo:
fast— un modelo ligero para extraer entidades, parsear logs y ordenar listas;deep— un modelo insignia de razonamiento para planificación de sistemas y código complejo;local— un modelo local cuantizado en un servidor vLLM para trabajar con datos sensibles sin salir a internet.
En este esquema, el agente orquestador solo ve descripciones textuales de una línea de cada ruta. Él mismo decide: «Vale, para parsear esta tabla me basta con la ruta fast, pero la arquitectura del microservicio la delego en deep». Todas las claves de API en bruto, endpoints y tokens quedan estrictamente ocultos a los subagentes.
- Modo de roles y personalidades (Profile Routes). Aquí el enrutamiento no apunta solo a un modelo, sino a un perfil completo y aislado de Hermes. Cada perfil lleva su propio archivo de identidad
SOUL.md, un conjunto único de habilidades (skills) y un directorio de trabajo cerrado. Por ejemplo, el subagentesecurity-auditorestá entrenado para buscar vulnerabilidades y no tiene permisos para editar código, mientras quedocs-writerse ocupa únicamente de actualizar la documentación en Markdown.
Configuración en acción: cómo preparar delegation.yaml
La instalación del plugin se hace con un solo comando en la terminal:
# Instalación de la extensión oficial mediante el gestor de paquetes de Hermes
hermes plugins install advanced-delegation
Después se genera en la raíz del proyecto un archivo de configuración limpio y claro llamado delegation.yaml. Así luce una combinación real de APIs comerciales y un modelo local:
version: "1.0"
mode: "model_routes"

model_map:
  fast:
    provider: "openrouter"
    model: "anthropic/claude-3-5-haiku-20241022"
    description: "Búsqueda rápida, extracción de entidades, filtrado de logs y parseo básico"
    temperature: 0.1
    max_tokens: 1024

  deep:
    provider: "anthropic"
    model: "claude-3-7-sonnet-20250219"
    description: "Planificación arquitectónica compleja, código de sistema y refactorización profunda"
    temperature: 0.2
    max_tokens: 4096

  local:
    provider: "openai_compatible"
    base_url: "http://localhost:8000/v1"
    model: "Nanbeige/Nanbeige4.3-33B-AWQ"
    description: "Trabajo confidencial con archivos locales y comandos de terminal sin acceso a la red"
    temperature: 0.1
A continuación lanzas la sesión del agente comprobando que las rutas sean válidas:
# Comprobación de la sintaxis de las rutas
hermes delegation config --validate

# Inicio de la sesión de trabajo del ingeniero principal
hermes session --profile tech-lead --with-plugin advanced-delegation
Economía y seguridad: dónde se ahorra el presupuesto
En la práctica, implantar una delegación inteligente produce un ahorro inmediato: el coste total de ejecutar un flujo de varias horas cae entre 3 y 5 veces.
El modelo pesado deep realiza literalmente el 10–15% de las llamadas (descomposición inicial del problema y verificación final del resultado). Todos los pasos mecánicos intermedios —recopilar información, lanzar tests, convertir formatos— los absorbe la ruta fast, donde el millón de tokens cuesta apenas unas decenas de céntimos.
El segundo factor clave es la protección de la infraestructura. Cuando el orquestador lanza un subagente, le entrega un contexto aislado. El proceso hijo no puede ver físicamente las claves maestras de la nube ni filtrarlas por accidente en un log externo.
Escollos del lanzamiento v1.0
Por útil que sea, la versión actual del plugin tiene detalles técnicos que conviene tener presentes.
Primero, en la versión 1.0 los modos model_routes y profile_routes son mutuamente excluyentes: configuras el enrutamiento por modelos o por perfiles (los autores prometen la cascada híbrida en la actualización 1.1).
Segundo, vigila los límites de los proveedores (Rate Limits). Si el modelo ligero de la ruta fast cae de golpe con un error 429 Too Many Requests, el flujo padre puede quedarse colgado al no tener reintentos integrados. Por eso, en entornos de producción conviene envolver las rutas fast con balanceadores como LiteLLM u OpenRouter con pasarelas de respaldo.
Pero la tendencia ya es indiscutible: la era de los agentes monolíticos que hacían todo el trabajo sobre una sola red neuronal cara está quedando atrás. El futuro pertenece a los conjuntos inteligentes de modelos especializados.
