Cuando pones a trabajar a un equipo de agentes autónomos de IA —por ejemplo, el programador de terminal Claude Code, el orquestador de sistema Hermes y un par de scripts auxiliares para recopilar datos—, chocas inevitablemente con un fenómeno que los investigadores llaman «amnesia de sesiones» (Session Amnesia).
Cada agente vive encerrado en su propia ventana de contexto. Puedes pasarte dos horas explicándole a Claude Code las manías de compilar un proyecto para arquitectura ARM64. El agente encuentra el flag exacto del compilador, corrige el fallo y cierra la sesión. Al día siguiente, Hermes tropieza con el mismo bug y vuelve a darse contra la misma pared porque no comparten memoria.
La respuesta clásica de las grandes empresas suena a «conectad una base de datos vectorial y montad un RAG». Pero en el día a día la búsqueda vectorial acaba convirtiéndose en una caja negra opaca: los embeddings no entienden bien las relaciones cronológicas estrictas, la similitud del coseno devuelve fragmentos obsoletos y un desarrollador humano no puede asomarse dentro para ver por qué el agente tomó tal o cual decisión.
La comunidad de ingeniería ha dado con un patrón arquitectónico alternativo sorprendentemente limpio: usar un almacén local de Obsidian Vault como «segundo cerebro» común (Shared Cognitive Substrate) para agentes heterogéneos. Veamos cómo se organiza esta base de conocimiento de más de mil notas enlazadas.
Por qué precisamente Markdown: transparencia frente a la caja negra
La base de la solución es renunciar a formatos propietarios en favor de archivos planos de texto Markdown (.md) con metadatos YAML frontmatter y enlaces wiki bidireccionales [[Nombre de la nota]].
¿Dónde está la fuerza de este planteamiento?
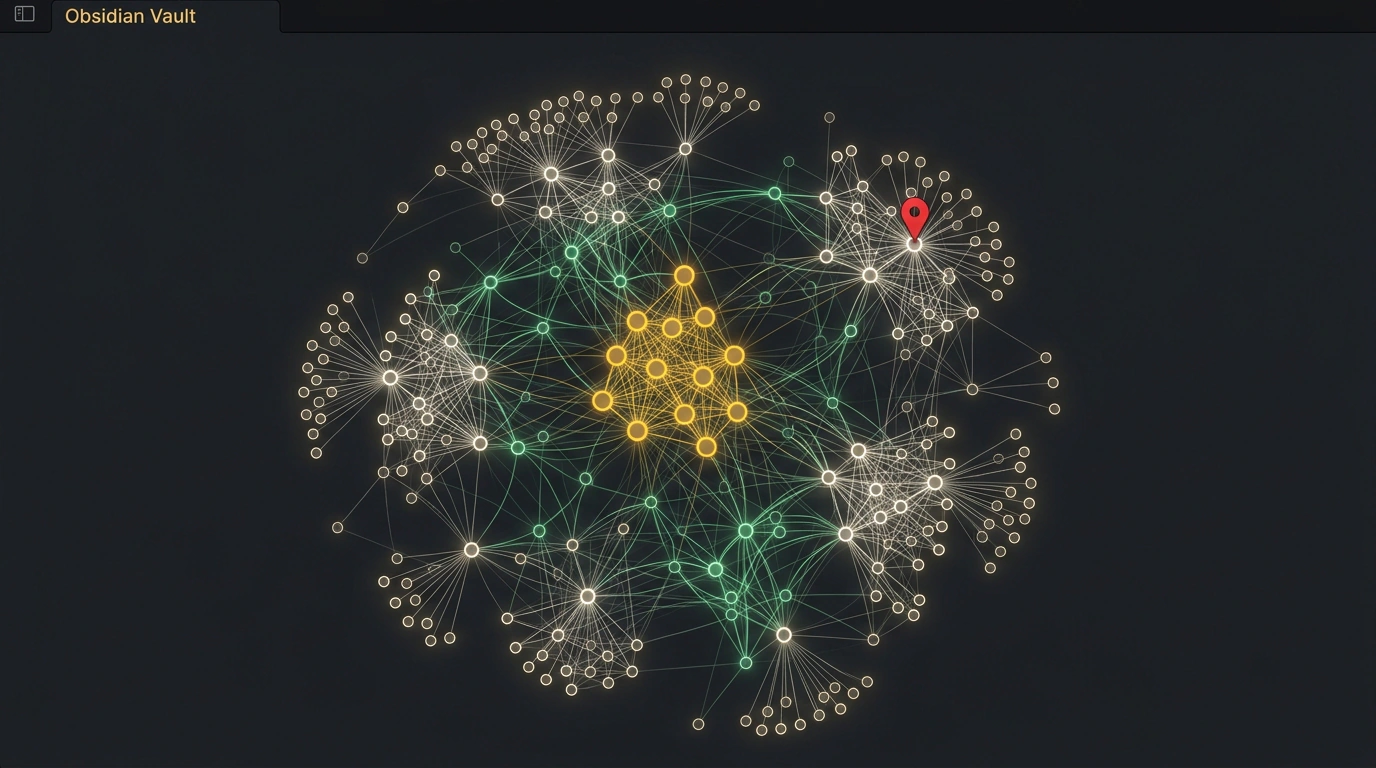
- Fuente única de verdad (Single Source of Truth). El operador humano y cualquier agente de IA leen y escriben sobre el mismo sistema de archivos. Puedes abrir Obsidian, activar el grafo interactivo de conexiones y ver con tus propios ojos la telaraña del conocimiento: cómo se enlazan las decisiones de arquitectura con los perfiles de microservicios y los registros de bugs.
- Control humano (Human-in-the-loop). Si un agente alucina y guarda un comando erróneo en la memoria, no tienes que reindexar una base vectorial. Abres el archivo en tu editor y corriges la línea a mano.
- Multiplataforma sin ataduras a proveedores. Cualquier herramienta —ya sea
ripgrep, el plugin Obsidian Local REST API o el protocolo Model Context Protocol (MCP)— puede interactuar con esa memoria sin SDKs cerrados.
Lucha contra condiciones de carrera: carpeta _inbox/ y limpieza nocturna
El peligro más serio en una memoria distribuida son las condiciones de carrera (Race Condition). Imagina a dos agentes resolviendo tareas en paralelo que intentan añadir datos nuevos al mismo tiempo en el archivo Architecture.md. Uno acabará pisando los cambios del otro sin remedio.
Para evitar que el grafo se corrompa, el sistema aplica una arquitectura de escritura en dos niveles:
- Búfer aislado
_inbox/. Los agentes tienen terminantemente prohibido editar de forma directa los nodos canónicos del grafo de conocimiento. Cuando un agente descubre un dato nuevo (por ejemplo, documenta un comando para esquivar un fallo en una librería), crea un archivo atómico separado dentro de la bandeja de entrada con marca de tiempo:_inbox/2026-10-31-arm64-fix.md. Dentro de la nota deja etiquetas y enlaces a las entidades padre. - Agente consolidador nocturno (Nightly Brain Sweep). Una vez al día, mediante
cron, arranca un agente limpiador especializado. Escanea las notas acumuladas en la bandeja de entrada, analiza su contexto, actualiza las fichas canónicas de los componentes, añade los wikilinks mutuos y mueve los borradores ya procesados a la carpeta de archivo.
Fíjate en un script mínimo en Python que automatiza esta consolidación:
import os
import glob
import datetime

VAULT_PATH = "./agent_vault"
INBOX_PATH = os.path.join(VAULT_PATH, "_inbox")
LOG_PATH = os.path.join(VAULT_PATH, "Daily_Logs")

def consolidate_inbox():
    today_str = datetime.date.today().isoformat()
    daily_file = os.path.join(LOG_PATH, f"{today_str}.md")

    inbox_files = glob.glob(os.path.join(INBOX_PATH, "*.md"))
    if not inbox_files:
        return

    with open(daily_file, "a", encoding="utf-8") as out_f:
        out_f.write(f"\n\n## Consolidación nocturna: {datetime.datetime.now().isoformat()}\n")
        for fpath in inbox_files:
            with open(fpath, "r", encoding="utf-8") as in_f:
                content = in_f.read()
            title = os.path.basename(fpath).replace(".md", "")
            out_f.write(f"\n### Extraído de [[{title}]]\n{content}\n")
            os.rename(fpath, fpath.replace("_inbox", "_archive"))
Ficha canónica: cómo se orientan los agentes en el grafo
Para que los agentes extraigan al instante la información que necesitan sin tragarse archivos enteros, la cabecera de cada nota lleva un bloque YAML estricto:
---
id: ent-agent-hermes
type: architecture-component
status: active
tags:
  - AI
  - Agentes de IA
  - Arquitectura
updated_by: claude-code-worker-01
last_verified: 2026-10-30T22:15:00Z
related_nodes:
  - "[[Hermes-Advanced-Delegation]]"
  - "[[Model-Routing-Schema]]"
---

# Arquitectura del agente Hermes

El agente se encarga de las operaciones en terminal y de coordinar subtareas.
La especificación de delegación está descrita en [[Hermes-Advanced-Delegation]].
Gracias a esa estructura, cualquier agente hace una búsqueda rápida por etiquetas o cabeceras YAML antes de empezar a trabajar y carga solo la porción de datos vigente.
Límites de escala: qué pasa cuando se acumulan demasiados archivos
Mientras la base de conocimiento tenga entre mil y cinco mil notas, la búsqueda de texto con grep o el índice integrado de Obsidian vuela en milisegundos.
Pero si tu granja de agentes genera cientos de notas cada hora y el almacén supera los cien mil archivos, el sistema de archivos tradicional empieza a atragantarse al escanear directorios. En ese punto se añade encima un índice ligero de metadatos en SQLite o se conecta un motor de búsqueda de texto completo como Tantivy.
El segundo detalle es la disciplina de enlaces. Si una persona renombra un archivo a mano desde el explorador de Windows o macOS en lugar de hacerlo dentro de Obsidian, los wikilinks antiguos pueden quedar rotos. Para evitar enlaces huérfanos, en la rutina nocturna del agente se incluye siempre un linter que revisa los enlaces rotos.
Como base de memoria práctica, transparente a la vista y totalmente bajo control humano, el grafo de Obsidian le saca hoy cien cuerpos de ventaja a cualquier base vectorial compleja en la nube.
