En la industria del desarrollo reina ahora mismo una euforia contagiosa. Los managers celebran que los tickets se cierran tres veces más rápido, los programadores presumen en redes de haber montado un prototipo funcional en una tarde con Claude Code o Cursor, y los analistas anuncian con total seriedad el fin inminente de la programación clásica. Parece mágico: pulsas Tab y la función ya descansa en el repositorio con sus tipos, interfaces, tests unitarios y una descripción kilométrica en el pull request.
Pero si rascas bajo el barniz brillante de esa supuesta productividad, aparece una realidad técnica inquietante. Las bases de código longevas se degradan a toda velocidad, cubriéndose de capas monstruosas de pseudoabstracciones, dependencias circulares y código muerto que nadie en el equipo entiende ni se atreve a borrar.
Este problema urgente lo diseccionó a fondo el reconocido experto en arquitectura y creador de HowProgrammingWorks Timur Shemsedinov en su contundente charla en vídeo de Timur Shemsedinov. La grabación provocó un enorme revuelo en la comunidad porque puso sobre la mesa lo que muchos ingenieros sénior temían decir en voz alta: la IA generativa, sin una supervisión arquitectónica estricta, puede convertir un proyecto vivo en ruinas radiactivas en apenas unos meses.
Desmontemos paso a paso la anatomía de este desastre: veremos por qué los modelos lingüísticos producen tanto boilerplate, cómo los tests sintéticos lo dejan sellado en hormigón y qué reglas protegen tu proyecto de la parálisis.
Fábrica de fábricas: por qué a los modelos de lenguaje les encanta complicarlo todo
Para entender la raíz del problema hay que recordar con qué se entrenaron los grandes modelos de lenguaje (LLM). Sus enormes corpus están repletos de millones de líneas de sistemas corporativos enterprise en Java y C# de principios de los 2010, manuales clásicos de patrones orientados a objetos de la Banda de los Cuatro (GoF) e incontables repositorios académicos donde alguien intentó meter a la fuerza Abstract Factory, Visitor, Bridge y Strategy en una simple calculadora de consola.
Cuando le pides a la IA algo tan cotidiano como «escribe una función para validar un email y guardar un usuario nuevo en la base de datos», el modelo no razona como un ingeniero pragmático: maximiza la verosimilitud estadística del código corporativo pesado. En lugar de escribir diez líneas limpias de lógica de negocio en TypeScript, Go o Python, el agente genera al instante toda una jerarquía de archivos:
- Una interfaz abstracta
IEmailValidatorStrategy; - La clase
RegexEmailValidatorServiceImpl; - Una fábrica de fábricas
EmailServiceFactoryProvider; - El adaptador
NotificationDispatchAdapterBridge; - Un envoltorio DTO
UserEmailPayloadValueObject.
Mira lo que ocurre en realidad. El problema original se resolvía con una función pura de diez líneas. Pero la IA ha parido cinco archivos, media docena de tipos y tres niveles de indirección. ¿Por qué? Porque en sus datos de entrenamiento, el código con diez interfaces parece «sólido», «escalable» y «profesional». El modelo optimiza la complejidad aparente del texto, no la facilidad de mantenimiento.
Echa un vistazo a un ejemplo clarísimo de esta sobreingeniería generada por IA en TypeScript:
// Lo que generó la IA ante una petición sencilla de guardar un usuario:
export interface IUserRepositoryPort {
  save(user: UserEntity): Promise<UserResultDto>;
}

export interface IUserDataMapper<TSource, TTarget> {
  mapToDomain(source: TSource): TTarget;
  mapToPersistence(target: TTarget): TSource;
}

export class PostgresUserDataMapperImpl implements IUserDataMapper<RawDbRecord, UserEntity> {
  mapToDomain(source: RawDbRecord): UserEntity {
    return new UserEntity(source.id, source.email_address, source.created_timestamp);
  }
  mapToPersistence(target: UserEntity): RawDbRecord {
    return { id: target.id, email_address: target.email, created_timestamp: target.createdAt };
  }
}

export class UserPersistenceOrchestratorService {
  constructor(
    private readonly repositoryPort: IUserRepositoryPort,
    private readonly mapperService: IUserDataMapper<RawDbRecord, UserEntity>
  ) {}

  async executeUserRegistrationFlow(payload: RegisterUserCommandDto): Promise<UserResponseEnvelopeDto> {
    // Toda la lógica real queda enterrada bajo capas de llamadas a mappers
    const domainEntity = this.mapperService.mapToDomain(payload.rawRecord);
    const saveResult = await this.repositoryPort.save(domainEntity);
    return new UserResponseEnvelopeDto(saveResult);
  }
}
Toda esta pirámide monumental de clases aporta exactamente cero valor de negocio. El proyecto jamás va a cambiar PostgreSQL por Oracle en caliente a medianoche, el servicio tiene una única implementación de repositorio y el mapper solo mueve campos de un objeto a otro pasando claves de snake_case a camelCase. Pero la base de código ya carga con 40 líneas de boilerplate que hay que leer, compilar, indexar y sostener en la cabeza.
La trampa de los tests sintéticos: cómo sellar el código muerto con cemento
El código inflado es molesto, pero en condiciones normales podrías limpiarlo en un par de horas de refactorización sensata. Y justo ahí se cierra la segunda trampa, la más letal de la programación asistida por IA: la generación de tests unitarios sintéticos.
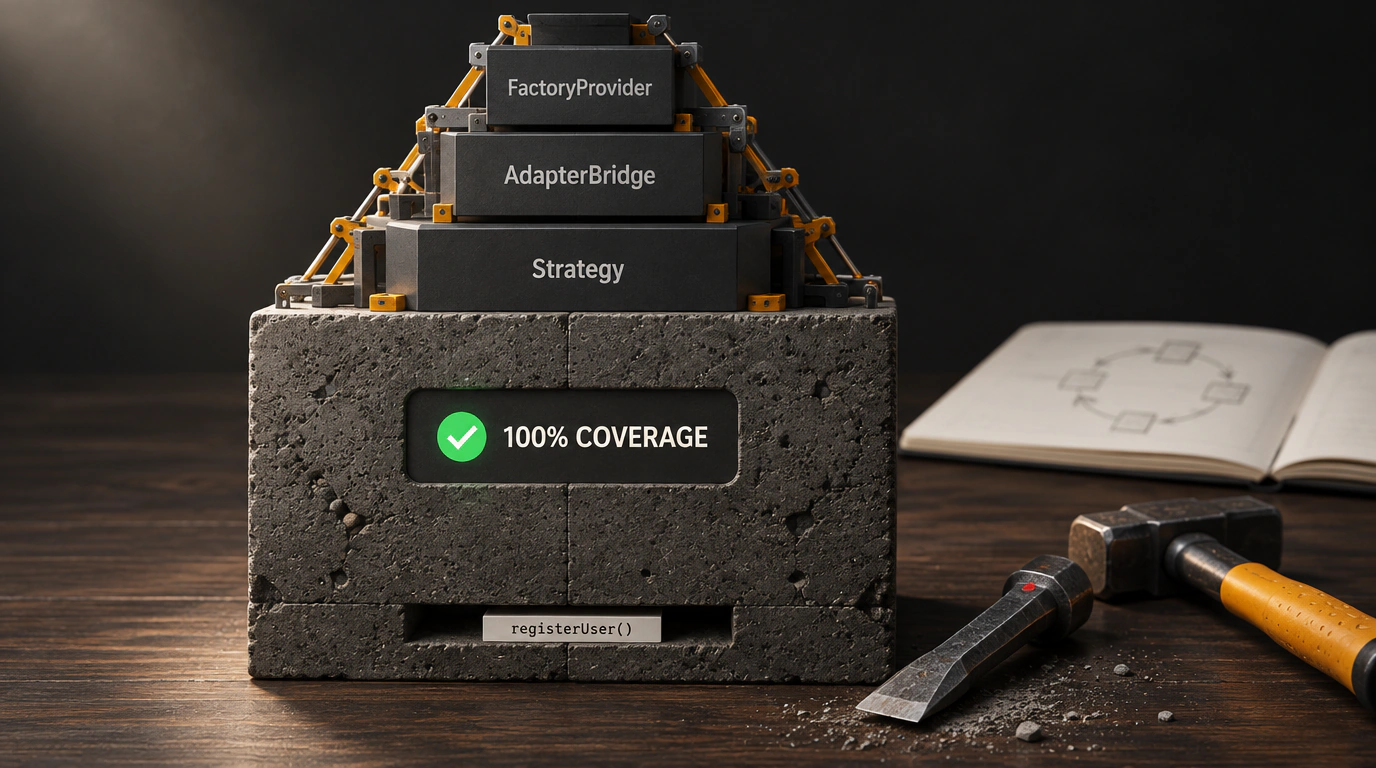
Diagrama isométrico en vista explotada de una frágil rejilla de mocks sintéticos en Jest desmoronándose al eliminar una interfaz ficticia.
El desarrollador ve que el agente ha creado una estructura compleja de clases y lanza la siguiente orden: «Ahora cubre todas estas clases con tests unitarios al 100 % de cobertura». El agente obedece encantado y escupe doscientas líneas de pruebas en Jest, Vitest o pytest.
¿Pero cómo se prueban interfaces vacías y mappers artificiales? El modelo empieza a mockearlo absolutamente todo:
// Test unitario sintético generado por IA que se prueba a sí mismo:
describe('UserPersistenceOrchestratorService', () => {
  it('должен вызывать маппер и сохранять пользователя через порт', async () => {
    // Creamos mocks interminables para cada paso trivial
    const mockMapper: jest.Mocked<IUserDataMapper<RawDbRecord, UserEntity>> = {
      mapToDomain: jest.fn(),
      mapToPersistence: jest.fn(),
    };
    const mockRepo: jest.Mocked<IUserRepositoryPort> = {
      save: jest.fn(),
    };

    const dummyUser = new UserEntity('u-1', 'test@example.com', new Date());
    mockMapper.mapToDomain.mockReturnValue(dummyUser);
    mockRepo.save.mockResolvedValue(new UserResultDto('u-1', 'SUCCESS'));

    const orchestrator = new UserPersistenceOrchestratorService(mockRepo, mockMapper);
    const result = await orchestrator.executeUserRegistrationFlow({ rawRecord: {} as any });

    // Comprobamos que el mock llamó al mock con los argumentos del mock:
    expect(mockMapper.mapToDomain).toHaveBeenCalledTimes(1);
    expect(mockRepo.save).toHaveBeenCalledWith(dummyUser);
    expect(result.status).toBe('SUCCESS');
  });
});
Mira con atención este caso de prueba. ¿Qué verifica en realidad? ¿El comportamiento del sistema? ¿Que el guardado en la base de datos funciona? ¿Las reglas de negocio? ¡Nada de eso! Solo comprueba que el método A llamó al mock B, que pasó un argumento al mock C. Si en producción se cae la tabla, cambia el esquema o falla la red, este test seguirá poniéndose en verde tan campante en el pipeline de CI, dándote una falsa sensación de seguridad total.
Lo peor llega tres meses después. Cuando un ingeniero humano abre el archivo y decide con buen criterio: «Qué horror, ¿para qué cinco clases aquí? Lo reescribo en una función simple», ejecuta la suite de tests... ¡y estallan cincuenta errores en rojo!
Los tests están atados con cadenas a la implementación interna de clases ficticias y firmas de mocks. Cualquier intento de borrar una interfaz inútil rompe la suite. El ingeniero se asusta: «Vaya, han fallado cincuenta comprobaciones, esto debe de ser arquitectura crítica, mejor no tocarlo». Y el código muerto se queda en el sistema para siempre. La IA literalmente ha sellado con hormigón sus propias alucinaciones arquitectónicas usando tests sintéticos.
Simbiosis de código muerto y dependencias circulares parásitas
En su charla, Timur Shemsedinov detalla la siguiente fase de degradación: la aparición de ciclos entre módulos de código muerto.
Cuando varios agentes de IA o distintos desarrolladores lanzan prompts en ramas paralelas, los agentes no inspeccionan el repositorio entero. El modelo solo ve una ventana local de contexto de unos pocos miles de tokens. Si necesita una función auxiliar para formatear fechas o validar cadenas, no la busca en las utilidades compartidas del proyecto: le resulta mucho más fácil generar un nuevo helper privado en el módulo actual o crear un archivo dateUtilsV2.ts.
Tras unos cuantos sprints, la base de código se llena de una telaraña de llamadas duplicadas:
- El módulo A importa un tipo del módulo B;
- El módulo B importa una interfaz auxiliar del módulo C;
- El módulo C, para su lógica interna, importa un helper de vuelta desde el módulo A.
Aparece una dependencia circular. Para empaquetadores modernos como Vite, Rollup o Webpack esto es un lastre enorme: el grafo de módulos se enreda, el tree-shaking deja de eliminar código sobrante y el tamaño del bundle cliente se multiplica. Ningún analizador estático automático se atreve a borrar el módulo B porque el módulo C lo referencia formalmente en sus tipos, aunque en ejecución real jamás pase por ahí ni una sola línea de lógica de negocio.
Si recuerdas lo que vimos sobre la higiene de contexto en agentes de IA, alimentar a los modelos con archivos inflados cierra el círculo vicioso: cuanto más sucia está la base de código, más enredado y redundante es el código que devuelve el modelo en la siguiente iteración.
El coste oculto de propiedad: por qué sufre la productividad del equipo
A menudo desde gestión llega la objeción: «Bueno, ¿y qué más da que el código esté inflado si el disco es barato y la IA escribe rápido?».
Es un error gravísimo. Cada clase sobrante, cada archivo sintético y cada interfaz ficticia imponen un coste de propiedad (Total Cost of Ownership) constante y creciente:
- Carga sobre el servidor de lenguaje (LSP): Los servidores de TypeScript,
goplsen Go orust-analyzertienen que parsear, tipar y mantener en RAM miles de símbolos ficticios. Tu IDE empieza a ir a tirones, el autocompletado tarda un segundo entero y la indexación del proyecto pone el ventilador del portátil al máximo. - Pipelines de CI/CD lentos: Ejecutar cientos de tests inútiles que solo se prueban a sí mismos estira el build de 2 a 25 minutos. El equipo pierde horas valiosas esperando a que el pipeline se ponga en verde.
- Parálisis cognitiva del ingeniero: El cerebro humano no puede sostener infinitas entidades a la vez. Cuando alguien nuevo entra al proyecto y ve siete capas de abstracción alrededor de una sola tabla, tarda semanas simplemente en localizar dónde se ejecutan las reglas de negocio reales.
Cómo debería lucir un código sano: refactorización radical
Veamos cómo resuelve exactamente esa misma funcionalidad de guardar un usuario un ingeniero experimentado que aplica de verdad los principios YAGNI (You Aren't Gonna Need It) y KISS (Keep It Simple, Stupid):
// Implementación sana, legible y fiable sin un gramo de grasa sobrante:
import { sql } from '@/database/client';

export interface UserRegistrationInput {
  email: string;
  fullName: string;
}

export interface UserRecord {
  id: string;
  email: string;
  fullName: string;
  createdAt: Date;
}

// Función asíncrona simple y limpia con validación directa y consulta SQL
export async function registerUser(input: UserRegistrationInput): Promise<UserRecord> {
  if (!input.email.includes('@')) {
    throw new Error('Некорректный формат адреса электронной почты');
  }

  const [createdUser] = await sql<UserRecord[]>`
    INSERT INTO users (email, full_name, created_at)
    VALUES (${input.email.toLowerCase()}, ${input.fullName.trim()}, NOW())
    RETURNING id, email, full_name as "fullName", created_at as "createdAt"
  `;

  return createdUser;
}
Siente la diferencia abismal:
- En lugar de cinco archivos y una telaraña de mocks, un único módulo cristalino.
- La lógica salta a la vista: datos de entrada, validación básica, consulta SQL parametrizada y resultado tipado.
- Se prueba con un solo test de integración contra una base de datos real en Docker en 20 milisegundos, ¡sin un solo mock! Si cambia el esquema de la base, el test de integración fallará con honestidad y señalará el problema real.
Reglamento de ingeniería: cómo salvar el proyecto de la degradación
Para no ahogarse en el pantano de la sobreingeniería autogenerada, el equipo de Timur Shemsedinov propuso reglas prácticas muy estrictas de higiene arquitectónica para equipos que trabajan con IA generativa:
- Regla de las tres implementaciones: Queda prohibido crear una interfaz abstracta o una fábrica si no existen en el sistema al menos tres implementaciones reales y distintas de esa interfaz. Si solo hay una, se escribe una clase concreta o una función simple.
- Separación de contextos al generar: Nunca pidas al mismo modelo, en la misma conversación, que genere la lógica de negocio y sus tests. Las pruebas debe escribirlas otra persona o un modelo independiente que reciba únicamente la especificación de requisitos, no las entrañas del código generado.
- Límite al tamaño del pull request: Si el asistente de IA ha generado un PR de 1.500 líneas, está prohibido aceptarlo a ciegas. Hay que trocear la tarea en micropasos de 100–200 líneas y revisar personalmente cada una.
- Días periódicos de arqueología (Dead Code Archaeology): Una vez al mes conviene pasar analizadores especializados de código muerto (
Knip,ts-prune,depcheck) y recortar sin piedad exportaciones sin uso y mappers intermedios. - Prioridad a los tests de integración: Reduce el peso de los tests con mocks en favor de comprobaciones de extremo a extremo o de componente sobre bases reales aisladas (Testcontainers). Un test debe verificar el resultado del sistema, no la secuencia de llamadas a métodos internos.
La conclusión de toda esta historia es sencilla y da que pensar: en la era de la IA, el valor de un ingeniero no se mide por lo rápido que pulsa el botón de generar código. La verdadera maestría arquitectónica hoy consiste en saber decirle un «no» firme al código innecesario y proteger el proyecto de entidades que nadie pidió.