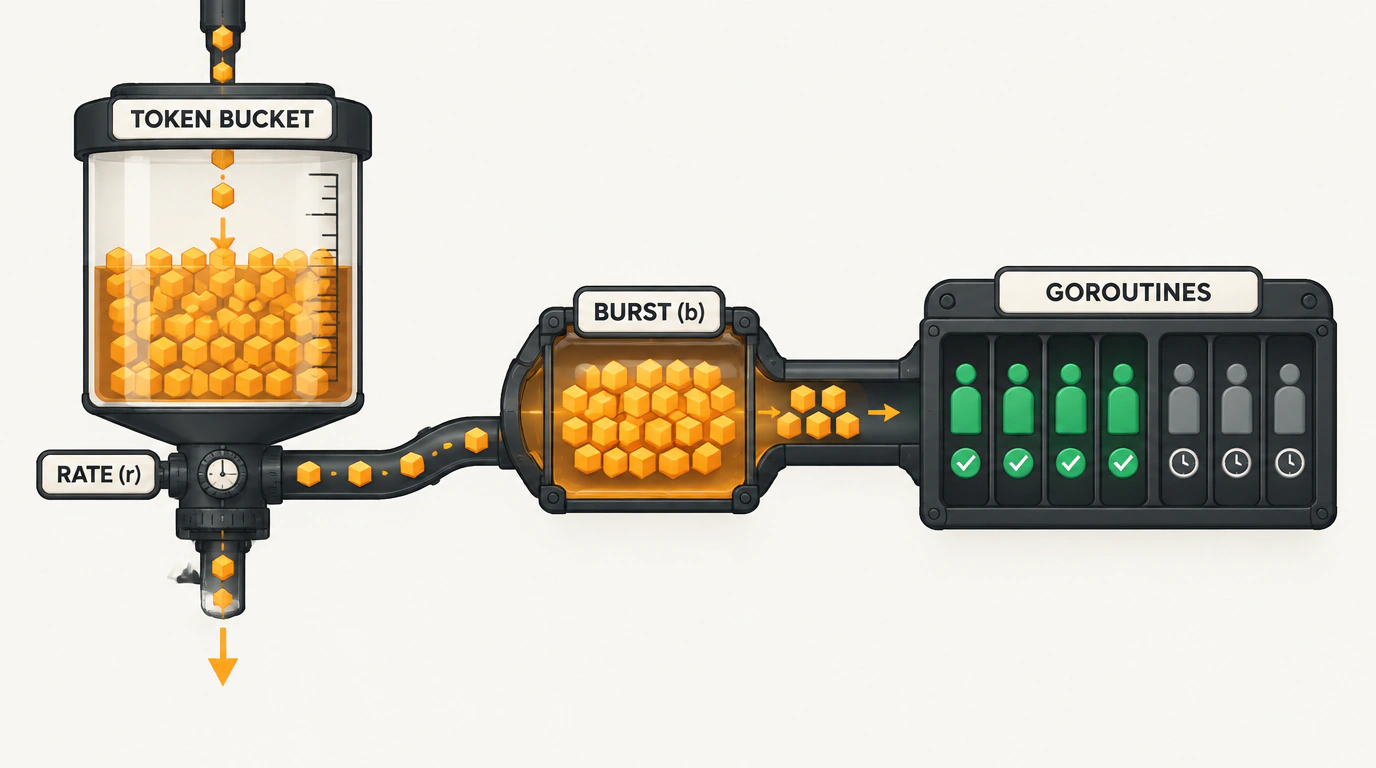
Todo ingeniero backend se enfrenta tarde o temprano al reto de proteger su servicio contra sobrecargas. El tráfico entrante crece, las integraciones externas empiezan a fallar y la base de datos gime bajo una avalancha de peticiones. Lo primero que se le ocurre a quien programa en Go es echar mano del paquete casi oficial golang.org/x/time/rate y plantar un limitador en el endpoint HTTP de entrada.
Y aquí es donde se esconde una de las ilusiones arquitectónicas más comunes y traicioneras. El ingeniero escribe limiter := rate.NewLimiter(100, 10) pensando: «Listo, ahora no corren más de 10 peticiones a la vez y la base queda a salvo de la tormenta». Una semana después estalla un incidente en producción: el pool de conexiones de PostgreSQL se agota, las latencias p99 se disparan a las nubes y el servicio deja de responder.
Asomémonos a las tripas de rate.Limiter para desmontar este mecanismo pieza a pieza.
La matemática del token bucket: frecuencia frente a concurrencia
Debajo del paquete golang.org/x/time/rate vive el clásico algoritmo Token Bucket (cubo de tokens). Su lógica es sencillísima:
- El cubo tiene una capacidad máxima de $b$ tokens: ese es el parámetro
burst. - A una velocidad constante $r$ van cayendo tokens nuevos al cubo: ese es el parámetro
limit(tokens por segundo). - Cada petición entrante debe tomar un token del cubo. Si hay token disponible, se ejecuta al instante. Si el cubo está vacío, la petición se rechaza de inmediato (método
Allow()) o se bloquea esperando a que se reponga (métodoWait(ctx)).
Fíjate en la diferencia fundamental: El token bucket controla la frecuencia de eventos en el tiempo (rate limit), pero no tiene ni idea del número de tareas ejecutándose simultáneamente (concurrency limit).
Imagina este escenario: el cubo está lleno, tiene 10 tokens acumulados (burst = 10). De golpe llegan 10 peticiones paralelas al servicio. El limitador da luz verde con toda diligencia a las 10. Las 10 gorutinas se lanzan a la vez contra la base de datos. Y ahora lo decisivo: si cada una ejecuta un SELECT pesado que tarda 5 segundos, durante esos cinco segundos tu base soporta 10 sesiones concurrentes. Y si el limitador se recarga a 100 tokens por segundo, en apenas un segundo entrará la siguiente oleada.
Cuándo usar rate.Limiter y cuándo un semáforo
Para proteger servicios aguas abajo (bases de datos, APIs externas con tope estricto de sockets simultáneos), rate.Limiter por sí solo no basta. Necesitas combinar dos piezas independientes:
rate.Limiter: recorta picos en la frecuencia de llamadas por unidad de tiempo.- Un semáforo ponderado (
semaphore.Weighteddel paquetegolang.org/x/sync/semaphore): limita con rigor cuántos workers pueden trabajar en paralelo.
Veamos el patrón de ingeniería correcto para combinar ambas herramientas:
package main

import (
    "context"
    "fmt"
    "net/http"
    "time"

    "golang.org/x/sync/semaphore"
    "golang.org/x/time/rate"
)

type ProtectedService struct {
    rateLimiter *rate.Limiter
    concurrency *semaphore.Weighted
}

func NewProtectedService(rps float64, burst int, maxConcurrent int64) *ProtectedService {
    return &ProtectedService{
        rateLimiter: rate.NewLimiter(rate.Limit(rps), burst),
        concurrency: semaphore.NewWeighted(maxConcurrent),
    }
}

func (s *ProtectedService) HandleTask(ctx context.Context, taskID int) error {
    // 1. Comprobamos el límite de frecuencia: esperamos a que haya un token en el tiempo
    if err := s.rateLimiter.Wait(ctx); err != nil {
        return fmt.Errorf("превышен таймаут ожидания токена: %w", err)
    }

    // 2. Limitamos el paralelismo: tomamos un hueco en el semáforo
    if !s.concurrency.TryAcquire(1) {
        return fmt.Errorf("все слоты параллельной обработки заняты")
    }
    defer s.concurrency.Release(1)

    // Simulación de carga útil (consulta a la base de datos)
    time.Sleep(200 * time.Millisecond)
    return nil
}
Presta atención a TryAcquire(1): si todos los huecos paralelos están ocupados por operaciones lentas, el servicio devuelve un error al cliente al instante (HTTP 429 o 503) sin acumular una cola de gorutinas colgadas en memoria. Si recuerdas cómo funciona la concurrencia en Go, controlar el ciclo de vida de las gorutinas mediante contextos y semáforos es la base de cualquier sistema fiable.
Matices de Allow, Wait y Reserve
El paquete rate ofrece tres métodos principales para interactuar con el cubo, cada uno con su papel claro:
// 1. Método Allow(): comprobación no bloqueante (ideal para API gateways)
if !limiter.Allow() {
    http.Error(w, "Too Many Requests", http.StatusTooManyRequests)
    return
}

// 2. Método Wait(ctx): espera bloqueante con soporte de cancelación por contexto
ctx, cancel := context.WithTimeout(context.Background(), 2*time.Second)
defer cancel()
if err := limiter.Wait(ctx); err != nil {
    // Contexto cancelado o timeout agotado antes de que hubiera un token libre
    return err
}

// 3. Método Reserve(): reserva un token y devuelve el tiempo de espera (Reservation)
r := limiter.Reserve()
if !r.OK() {
    return fmt.Errorf("запрос превышает максимальный burst")
}
time.Sleep(r.Delay()) // Dormimos el tiempo exacto hasta que el token esté listo
Fíjate en un detalle sutil: si llamas a Wait(ctx) pidiendo más tokens que el tamaño de burst (limiter.WaitN(ctx, n) con n > burst), el método falla de inmediato porque el cubo no puede contener físicamente más tokens que su propia capacidad.
El parámetro burst es tu amortiguador de ráfagas de red, no un fusible contra la carga concurrente. Separa bien ambos conceptos en tu código y tu sistema no caerá ante una tormenta inesperada de peticiones.
