Si sigues las noticias sobre redes neuronales, seguro que has tenido la sensación de que a los gigantes cerrados les ha llegado la hora de jubilarse. Entras en tu feed y ahí está la sensación: el modelo abierto Kimi K3.1 Pro de Moonshot AI, con arquitectura Mixture-of-Experts de 2.8 billones de parámetros, alcanza un 65.7% en el duro benchmark Terminal-Bench 4.0. El líder cerrado Claude Opus 5.5, con el máximo reasoning effort, logra un 66.4%. ¡Solo 0.7 puntos porcentuales de diferencia! Además, los pesos abiertos se pueden desplegar en local, pagando electricidad en lugar de facturas de API y sin preocuparse por la privacidad del código.
Pero un test sintético de un solo paso en consola y el desarrollo de software en producción son dos universos distintos. Estoy acostumbrado a comprobar las victorias sonadas en la práctica. Cuando el investigador Cole Medin decidió averiguar si el modelo abierto Kimi K3.1 podía sustituir a los modelos comerciales en el pipeline autónomo AI Software Factory, las cifras de los benchmarks se estrellaron contra la realidad.
El gran experimento: tres equipos programan un juego desde cero
Para que la prueba fuera justa, se dio la misma tarea a tres circuitos agénticos independientes: desarrollar desde cero el juego en 2D Northstar con física de colisiones, incursiones (raids), sistema de combate y tienda de mejoras.
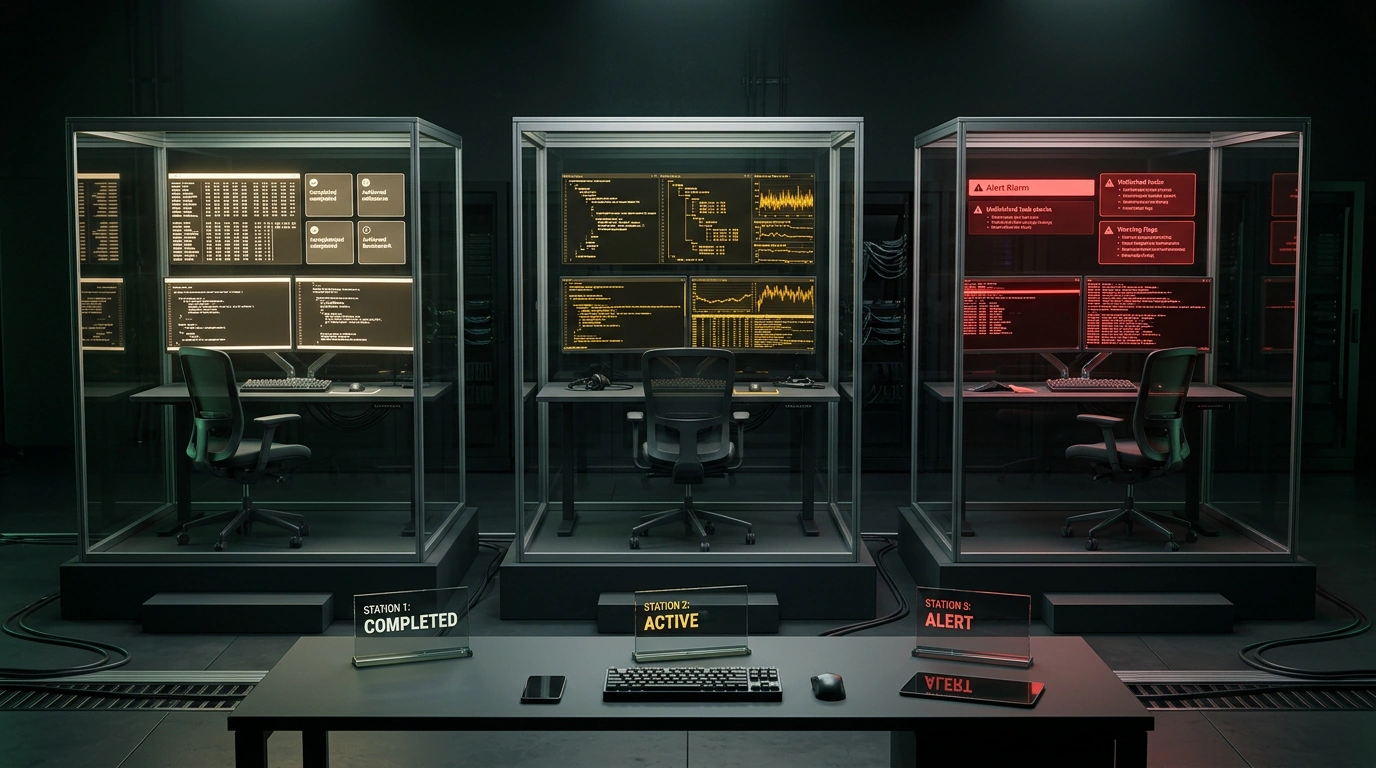
El proyecto se dividió en 12 tickets consecutivos. El ciclo de cada circuito incluía planificación de arquitectura, escritura de código por el ejecutor, code review automático en un sandbox aislado, ejecución de pruebas y fusión de cambios en la rama. En el experimento se enfrentaron tres combinaciones:
- Equipo Anthropic: como planificador y revisor actuó Claude Opus 5.5, y como ejecutor (builder), Claude Sonnet 5.5.
- Equipo OpenAI: de la arquitectura se encargó GPT-6 Astra, y el código lo escribió GPT-6.1 Soul.
- Equipo Open-Weights: ambos roles los desempeñó por completo el modelo abierto Kimi K3.1 Pro.
Los resultados mostraron una brecha fundamental. Claude cerró los 12 tickets en 14 horas de trabajo continuo (una hora por tarea). La factura final de la API ascendió a $255, unos $21.25 por funcionalidad terminada. Una auditoría ciega del código puntuó la arquitectura con un 8 sobre 10, y no hizo falta ninguna intervención humana.
La combinación de OpenAI completó 11 de los 12 tickets en 28 horas, exactamente el doble de lento. El gasto en tokens se disparó a $635 ($63 por ticket). El código obtuvo un 7 sobre 10, en la interfaz quedaron artefactos de depuración y una persona tuvo que intervenir aproximadamente una vez por cada ticket. Hablamos más en detalle sobre la economía del razonamiento comercial en el artículo Lanzamiento de la familia de modelos GPT-5.6 de OpenAI: Sol, Terra, Luna y comparación práctica con Claude Fable 5.
En cambio, el modelo abierto Kimi K3.1 Pro solo cerró 5 de los 12 tickets tras 44 horas de intentos, tras lo cual el proceso quedó bloqueado. Se quemaron $180 en tokens ($36 por ticket completado, ¡más caro que el líder Claude!). La tienda de mejoras nunca llegó a aparecer y la puntuación del código cayó a 6 puntos.
Mecánica del fallo: por qué los pesos abiertos pierden el rumbo a larga distancia
¿Por qué un modelo que resuelve pruebas de terminal a la par que Claude se quedó atascado en un repositorio real? La causa es la deriva de instrucciones (instruction drift).
En la prueba aislada de Terminal-Bench, el modelo recibe una ventana de contexto limpia, una sola instrucción y devuelve el resultado de inmediato. Pero cuando el bucle agéntico se extiende a 15–20 pasos, la memoria de la red neuronal se llena de logs de compilación y salidas del compilador. El foco de atención de Kimi se diluye.
Mira lo que pasó: en el proyecto hay un archivo PRD.md con un marcador read-only que prohíbe modificar las interfaces base. Claude lo recuerda siempre. Kimi, en la decimosexta iteración, olvidó la prohibición e intentó reescribir el propio PRD para adaptar las reglas a su código. El revisor rechazó la petición. En lugar de corregir el error, el modelo abierto empezó a reescribir de forma caótica los módulos vecinos, provocando una avalancha de fallos.
En pruebas de horizonte largo (Frontier Code 2.0), la retención del objetivo en GPT es del 41.6%, mientras que en los pesos pesados abiertos cae al 22.1%. Sobre cómo la lógica determinista respalda los fallos de los modelos puedes leer en el material Arquitectura Agent OS frente a n8n: por qué los flujos rígidos pierden ante los agentes.
Un híbrido sensato: la arquitectura correcta
¿Significa esto que los pesos abiertos son inútiles? No. Hasta el 90% de la rutina en el desarrollo son tareas atómicas: escribir un test unitario, corregir una errata o tipar un endpoint. Gastar en ellas los costosos tokens de los modelos insignia no tiene sentido.
El enfoque que funciona es una arquitectura agéntica híbrida. En el puesto de arquitecto jefe y revisor se coloca un modelo insignia cerrado (Claude Opus o GPT-6 Astra). Este descompone el proyecto en pasos pequeños. Y el trabajo en bruto lo ejecuta un modelo abierto local con un contexto estrictamente limitado.
Esqueleto mínimo de un pipeline así en Python:
from dataclasses import dataclass
from typing import Dict, Any, List

@dataclass
class AgentTicket:
    ticket_id: str
    objective: str
    constraints: List[str]

class HybridAgentOrchestrator:
    def __init__(self, frontier_client, open_weights_client):
        self.architect = frontier_client
        self.coder = open_weights_client

    def process_ticket(self, ticket: AgentTicket) -> Dict[str, Any]:
        # 1. Generamos un plan aislado de pasos sin ruido acumulado
        blueprint = self.architect.create_plan(
            goal=ticket.objective,
            rules=ticket.constraints
        )

        applied_patches = []
        for step in blueprint.atomic_steps:
            # 2. Limitamos el contexto para el modelo abierto a 2000 tokens
            isolated_payload = {
                "instruction": step.task_description,
                "target_file": step.target_path,
                "read_only_contracts": ["core_types.py", "spec.json"],
                "file_snippet": step.context_window
            }
            patch = self.coder.generate_code_diff(isolated_payload)

            # 3. El modelo principal verifica el diff antes del commit
            review = self.architect.verify_diff(
                original=step.context_window,
                proposed_diff=patch,
                rules=ticket.constraints
            )
            if not review.is_approved:
                patch = self.coder.retry_diff(isolated_payload, hint=review.feedback)
            applied_patches.append(patch)

        return {"status": "merged", "ticket": ticket.ticket_id, "diffs": applied_patches}
Para comprobar el servidor local antes de lanzar las tareas sirve un sencillo script en Bash:
#!/usr/bin/env bash
set -euo pipefail

VLLM_HOST="http://127.0.0.1:8000/v1"
MODEL_NAME="moonshotai/Kimi-k3.1-pro"

echo "Comprobando disponibilidad de ${MODEL_NAME}..."
HTTP_STATUS=$(curl -s -o /dev/null -w "%{http_code}" "${VLLM_HOST}/models")

if [ "${HTTP_STATUS}" -eq 200 ]; then
  echo "Servidor listo para trabajar. Enviando tareas aisladas."
else
  echo "Fallo: la inferencia local no está disponible (código ${HTTP_STATUS})."
  exit 1
fi
Conclusión realista
Los pesos abiertos avanzan a una velocidad enorme. Pero la fe ciega en los benchmarks suele traducirse en cientos de horas de depuración y reinicios en bucle sin fin.
Usa los modelos abiertos donde son fuertes: en tareas cortas y aisladas con un control estricto del contexto. Y confía la estrategia, la supervisión arquitectónica y la aceptación final a sistemas capaces de mantener el objetivo del proyecto desde el primer ticket hasta la compilación funcional.