En el mundo de las bases de datos relacionales existe un santo grial del alto rendimiento: los lectores nunca deben bloquear a los escritores, y los escritores bajo ninguna circunstancia deben hacer esperar a los lectores.
Si cada consulta SELECT colocara un bloqueo compartido sobre toda la tabla o fila, y cada UPDATE congelara la lectura, ninguna tienda online o red social moderna soportaría ni un segundo de carga real. Para resolver este conflicto se inventó el concepto de control de concurrencia multiversión: MVCC (Multi-Version Concurrency Control).
La idea es sencilla: cuando una transacción inicia una lectura de datos, fija una instantánea de la base (Snapshot o Read View) y ve el estado de las filas estrictamente en ese instante, ignorando las modificaciones paralelas de otros usuarios.
Pero lo que asombra es que los dos principales SGBD relacionales de la web moderna —MySQL (con el motor InnoDB) y PostgreSQL— implementaron este principio bajo leyes de física de almacenamiento diametralmente opuestas.
El análisis fundamental de esta diferencia lo documentó el ex arquitecto principal de bases de datos de Twitter y Yahoo!, Jeremy Cole, en su investigación, mientras que los detalles de concurrencia los detalla la documentación oficial de MVCC en PostgreSQL. Analicemos ambos enfoques bajo el capó.
El modelo InnoDB en MySQL: una única fila viva y cadena de deshacer
La arquitectura de InnoDB profesa el principio in-place update (actualización en el sitio):
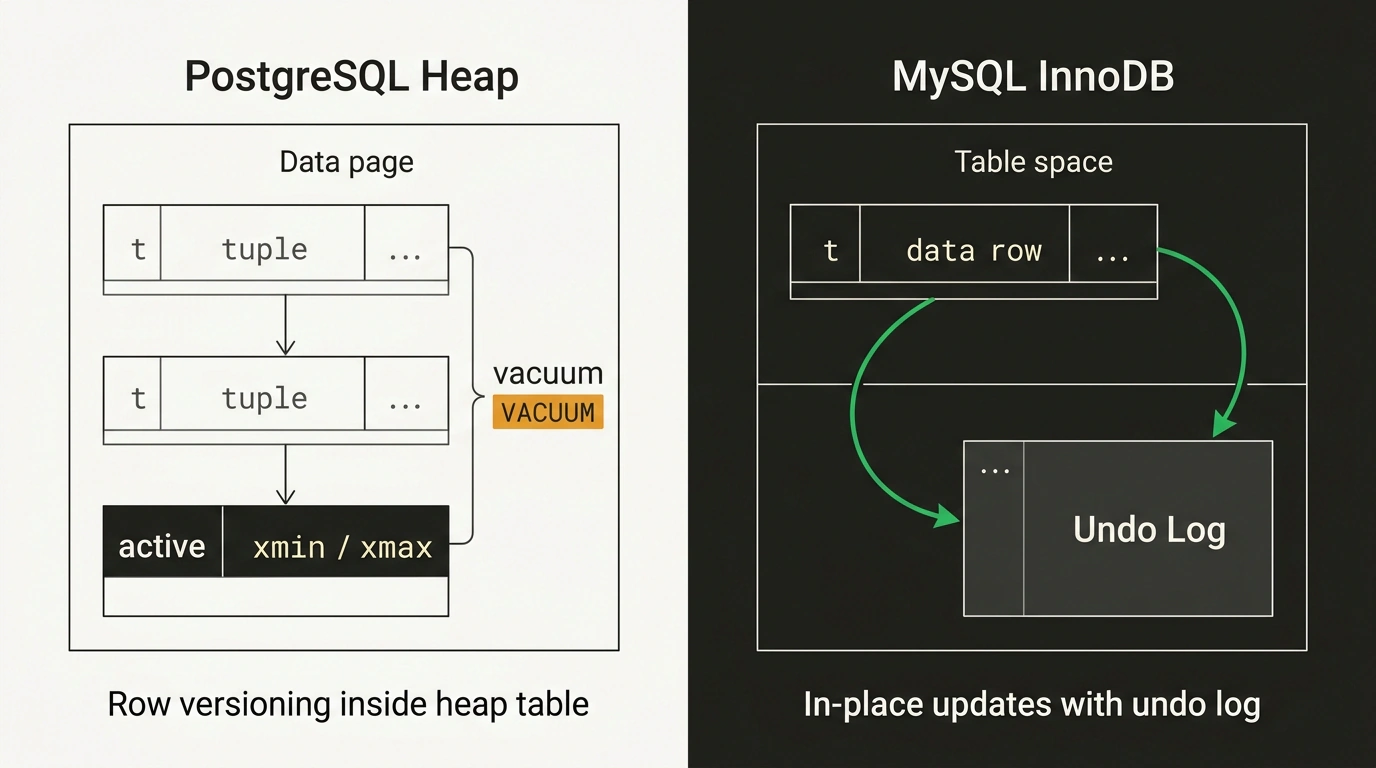
- En el índice B-Tree agrupado primario físicamente siempre se almacena una sola versión actual de la fila;
- En la cabecera de cada registro se ocultan dos campos de sistema obligatorios:
DB_TRX_ID(6 bytes, identificador de la transacción que creó o modificó el registro) yDB_ROLL_PTR(7 bytes, puntero de reversión Rollback Pointer); - Cuando una transacción ejecuta una operación
UPDATE, el valor antiguo de la fila se copia en un espacio especial de disco para deshacer —el Undo Log— y el registro en la tabla se sobrescribe con el nuevo valor directamente en su sitio. Al mismo tiempo, el campoDB_ROLL_PTRpasa a apuntar a la copia antigua en el Undo Log.
Si una fila se ha actualizado cinco veces seguidas, en el Undo Log se forma una lista enlazada (cadena de reversión) que lleva desde el estado actual de la fila hacia atrás en el tiempo.
¿Cómo funciona la lectura? Si una transacción lectora con un Read View más antiguo accede a la fila y ve que su DB_TRX_ID es más reciente que el momento de la instantánea, el motor InnoDB desenrolla al vuelo la cadena del Undo Log en memoria RAM, aplicando los deltas inversos y reconstruyendo para el lector la instantánea de la fila del pasado.
Y cuando las transacciones antiguas finalizan, el proceso de sistema en segundo plano Purge escanea la lista de historial (History List Length, HLL) y libera los segmentos innecesarios del Undo Log.
El modelo PostgreSQL: múltiples versiones de tuplas directamente en el heap de la tabla
Los ingenieros de PostgreSQL tomaron un camino completamente distinto al elegir el modelo append-only (solo añadir):
- En PostgreSQL no existe un espacio Undo Log separado para guardar valores históricos;
- Al ejecutar
UPDATE, la fila antigua no se sobrescribe en absoluto. En su lugar, en la página física de la tabla (el heap de la tabla, heap page) se escribe una tupla completamente nueva (una nueva versión de la fila); - La cabecera de cada tupla contiene metadatos del sistema:
xmin(ID de la transacción creadora) yxmax(ID de la transacción que eliminó o actualizó; para una fila viva vale 0).
La versión antigua de la fila permanece en su sitio dentro del archivo de la tabla, pero su campo xmax queda marcado con el identificador de la transacción actualizadora.
La transacción lectora simplemente escanea la página de la tabla y, comparando xmin y xmax con su lista de transacciones activas, determina exactamente qué versiones de tuplas le son visibles y cuáles debe ignorar.
Pero esta sencillez tiene una cara oculta: la hinchazón de tablas (Table Bloat). Con el funcionamiento continuo, en las tablas se acumulan millones de «tuplas muertas» (dead tuples). Para liberar espacio, PostgreSQL necesita de forma vital el demonio en segundo plano autovacuum, que recorre continuamente las páginas, limpia los registros muertos y actualiza los mapas de espacio libre.
Consecuencias operativas: lo que pagas en producción
La diferencia en la arquitectura fundamental provoca un comportamiento totalmente distinto de las bases bajo carga real:
1. Coste de las actualizaciones frecuentes (Write Amplification)
En MySQL, actualizar columnas no indexadas resulta increíblemente barato: el registro se modifica en su sitio dentro de la memoria RAM del buffer pool, se escribe un delta corto en el Undo Log y los índices secundarios de la tabla ni siquiera se tocan. En PostgreSQL, cualquier actualización crea una nueva tupla. Esto significa que todos los índices secundarios de la tabla deben recibir nuevos punteros hacia la nueva fila, salvo que actúe el mecanismo especial de optimización HOT (Heap-Only Tuples), que requiere margen de espacio libre en la misma página de la tabla.
2. La trampa de las transacciones largas (Long-running Transactions)
Es la mayor pesadilla de cualquier DBA:
- En MySQL: si un analista lanzó un informe pesado o se quedó colgado un proceso de copia de seguridad en modo
REPEATABLE READ, retiene un Read View antiguo. Esto bloquea por completo el proceso Purge para toda la base de datos. La métrica History List Length empieza a crecer hasta millones, el espacio de sistemaibdata1o los tablespaces de undo se hinchan y las consultasSELECTnormales empiezan a ralentizarse cientos de veces, obligadas a desenrollar cadenas de reversión kilométricas. - En PostgreSQL: una transacción abierta larga fija el umbral del sistema
OldestXmin. El proceso VACUUM pierde el derecho a eliminar cualquier tupla muerta aparecida después de ese instante. Como resultado, el tamaño de las tablas en disco se multiplica, la caché de buffers se llena de basura y la base corre el riesgo de quedarse sin espacio en disco.
Conclusiones sobrias del arquitecto
No existe un SGBD «absolutamente mejor»: cada motor sacrificó cosas distintas para lograr sus ventajas.
InnoDB en MySQL es ideal para escenarios con una frecuencia altísima de actualizaciones puntuales por clave primaria (contadores, saldos, transacciones financieras), pero exige un control férreo sobre las transacciones colgadas y la monitorización de History List Length.
PostgreSQL ofrece una flexibilidad increíble de extensiones, tipos de datos complejos e indexación, pero exige calibrar bien los umbrales de autovacuum y comprender que cada fila actualizada ocupa físicamente el espacio de una nueva tupla en disco. Entender esta mecánica interna permite diseñar esquemas de datos resilientes y no sorprenderse por el comportamiento de las bases en momentos de carga pico.