Haz un cálculo rápido de tu facturación en la nube en un rato libre. La semana laboral estándar de ingenieros, testers y product managers dura unas 45–50 horas: de nueve de la mañana a siete de la tarde, de lunes a viernes. El día tiene 24 horas y la semana 168 horas. Esto significa que los entornos de pruebas y preproducción (development, QA, staging) son utilizados por personas activas menos de un tercio del tiempo.
Las otras 118 horas de la semana —casi el 70% de toda la vida del clúster— costosas máquinas virtuales en AWS EKS, Google GKE o nodos alquilados en un centro de datos simplemente mueven aire. Los pods siguen girando, las bases de datos permanecen ociosas y el contador de dinero en el panel de la nube avanza monótonamente a favor del proveedor.
Parecería que la solución salta a la vista: configurar un horario y apagar los pods por la noche. Pero en el arsenal estándar de Kubernetes te espera una sorpresa desagradable.
El callejón sin salida arquitectónico de Horizontal Pod Autoscaler
La primera idea de cualquier ingeniero de sistemas es recurrir al mecanismo nativo Horizontal Pod Autoscaler (HPA). Pero aquí chocamos con una restricción arquitectónica rígida del núcleo de Kubernetes: el campo minReplicas en la especificación del HPA no puede ser por principio menor que uno.
Si intentas aplicar un manifiesto con minReplicas: 0, el servidor de API lo rechazará en la fase de validación del esquema. Los desarrolladores del controlador partieron de una lógica conservadora: el HPA evalúa el uso de CPU y memoria de los pods existentes. Si hay cero pods en el clúster, es imposible recopilar métricas de ellos, lo que significa que el sistema nunca sabrá cuándo debe volver a despertar.
Al final, los equipos o bien escriben scripts en bash engorrosos que por las noches ejecutan kubectl scale deployment --replicas=0 mediante cron, o bien se resignan a pagar sobrecostes enormes.
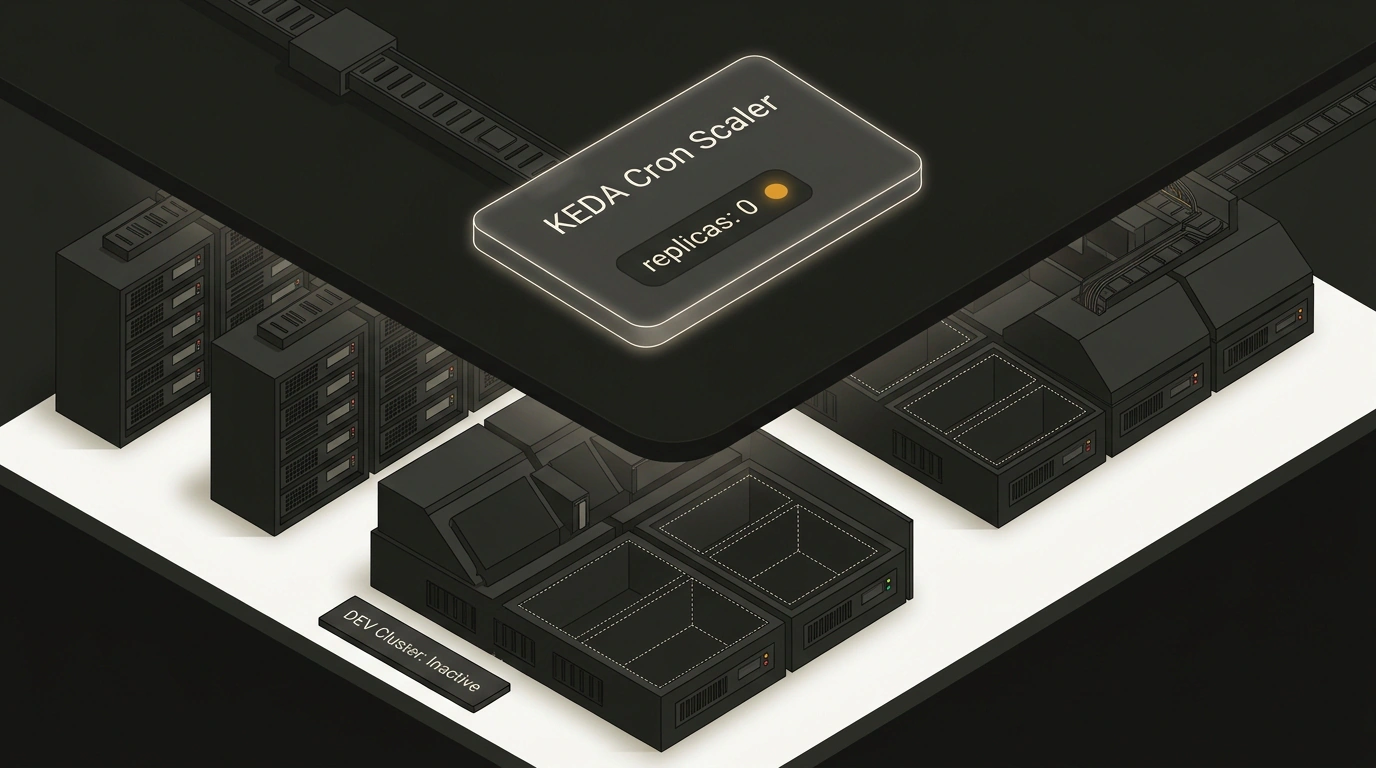
Por suerte, en el ecosistema Cloud Native existe un proyecto maduro de nivel CNCF Graduated: KEDA (Kubernetes Event-Driven Autoscaling). El ingeniero Mijndert Stuij mostró en su guía cómo poner a dormir con elegancia un entorno de desarrollo usando el disparador KEDA Cron Scaler.
Cómo sortea KEDA la limitación de cero réplicas
El secreto de KEDA reside en una clara división de responsabilidades entre dos niveles de control distintos:
- Modo despierto (de 1 a Max réplicas): cuando el horario laboral está activo, KEDA crea y controla dinámicamente un objeto HPA convencional, permitiendo que el servicio escale libremente bajo carga.
- Transición a cero (Scale to Zero): cuando llega la hora de dormir, el controlador de KEDA toma el mando y sobrescribe directamente el campo
.spec.replicasen el Deployment objetivo, dejándolo en cero.
En el manifiesto ScaledObject declaramos la ventana temporal de disponibilidad del servicio:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: backend-service-autoscaler
  namespace: development
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: backend-service
  minReplicaCount: 0
  maxReplicaCount: 5
  cooldownPeriod: 300
  triggers:
    - type: cron
      metadata:
        timezone: Europe/Moscow
        start: 0 8 * * 1-5    # Arranque a las 08:00 en días laborables
        end: 0 20 * * 1-5      # Hibernación a las 20:00 en días laborables
        desiredReplicas: "1"
Fíjate en el campo timezone: especificar explícitamente la zona horaria evita la confusión clásica con la hora UTC, en la que operan por defecto los nodos del clúster. Fuera del intervalo de 08:00 a 20:00, KEDA pasa automáticamente los pods al estado 0 current / 0 desired.
El escollo de GitOps: la guerra entre ArgoCD y KEDA
Si en tu empresa tienes configurado un GitOps estricto con ArgoCD o Flux, implantar KEDA a lo bruto provocará de inmediato una «guerra de controladores».
La escena es esta: a las 20:00 KEDA fija 0 réplicas en el Deployment. ArgoCD detecta que el estado vivo del clúster diverge de la descripción en el repositorio Git (donde figuraba replicas: 1), declara el estado OutOfSync y devuelve solícitamente una réplica a su sitio.
Para reconciliar KEDA con ArgoCD es necesario configurar dos reglas importantes:
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: development-backend
  namespace: argocd
spec:
  # 1. Prohibimos a ArgoCD sobrescribir el número de réplicas gestionado por KEDA
  ignoreDifferences:
    - group: apps
      kind: Deployment
      jsonPointers:
        - /spec/replicas
  syncPolicy:
    automated:
      selfHeal: true
      prune: true
    syncOptions:
      # 2. Activamos obligatoriamente ServerSideApply para instalar los pesados CRD de KEDA
      - ServerSideApply=true
La directiva ignoreDifferences le indica al motor GitOps: «Vigila las versiones de las imágenes, las variables de entorno y los puertos, pero deja el número de pods a criterio del autoescalador externo».
Economía y realidad del arranque en frío
¿Qué beneficio aporta este esquema en la práctica? Si tu clúster de desarrollo consta de una decena de microservicios, ponerlo a dormir por las noches y los fines de semana ahorra entre un 60% y un 67% de los costes en nodos de cómputo. Si el clúster tiene configurado Karpenter o Cluster Autoscaler, al dormir los pods las máquinas virtuales vacías se retirarán automáticamente del pool (node consolidation), reduciendo físicamente la factura de infraestructura.
Pero no hay milagros, y el ahorro se paga con un compromiso de ingeniería comprensible: el arranque en frío (cold start). Cuando el primer desarrollador o tester abre el servicio por la mañana, el clúster necesita entre 15 y 60 segundos para levantar los contenedores, calentar el runtime y superar las sondas de Readiness.
Para servicios en Go, Rust o Node.js la demora es casi imperceptible: arrancan en un par de segundos. En cambio, para monolitos pesados en Spring Boot o servicios de machine learning el calentamiento puede llevar un par de minutos. La forma más sencilla y elegante de sortear esta espera es programar el start 15–30 minutos antes del inicio real de la jornada del equipo. A las 08:30 el clúster despierta con suavidad y, a las nueve de la mañana, todos los servicios esperan ya a los ingenieros en plena forma.