Si alguna vez intentaste ejecutar un modelo de lenguaje local en una estación de trabajo doméstica o en una laptop de oficina común, seguro chocaste contra el muro físico de la memoria de video. La industria de los últimos años nos acostumbró a una regla extensiva y bruta: si quieres que la red neuronal entienda mejor tablas complejas, analice informes contables o llame con precisión a las API, prepárate para descargar modelos de 27, 32 o 70 mil millones de parámetros. Y eso significa de inmediato comprar tarjetas tope de gama como la RTX 4090, hacer malabares con la cuantización o pagar facturas interminables por clústeres en la nube.
Pero el 30 de octubre de 2026, la división de investigación SenseNova de la empresa china SenseTime demostró que la ley de escalado se puede hackear desde un ángulo completamente distinto. Publicaron en acceso abierto bajo la licencia libre Apache 2.0 el modelo SenseNova Loop 9B Preview. Físicamente tiene solo 9 mil millones de parámetros, pero en pruebas prácticas de negocio supera con claridad a transformadores abiertos de 27 mil millones de pesos, incluidos éxitos reconocidos como Gemma 2 27B y Qwen 2.5 14B. Veamos cómo funciona esta magia recursiva y dónde se esconden los compromisos de ingeniería.
Por qué los pesos gigantes llegan a un callejón sin salida
En un transformador clásico, cada capa de la red neuronal es única. Imagina una larga línea de ensamblaje con 32 o 48 talleres independientes: el token entra al primer taller, pasa por él, sigue al segundo, al tercero, y así estrictamente en línea recta hasta la salida. Ningún trabajador en ese taller vuelve a ver la pieza por segunda vez. Para aumentar la «inteligencia» de un sistema así, los ingenieros tradicionalmente solo agregaban más talleres nuevos, alargando la fábrica y el número de trabajadores contratados.
Como resultado, obtuvimos monstruos que físicamente no caben en la memoria. Incluso en formato de media precisión BF16, un modelo de 27 mil millones de parámetros requiere más de 55 gigabytes de VRAM pura. La cuantización ayuda, pero con una compresión agresiva a 4 bits, en muchas redes empiezan a fallar las conexiones lógicas sutiles.
El equipo de SenseTime se hizo una pregunta simple pero audaz: ¿y si en lugar de ampliar los talleres sin fin, hacemos que el grupo de trabajadores más experimentado revise la pieza compleja dos veces? Precisamente esa idea es la base del concepto de profundidad recurrente (recurrent depth), o transformador en bucle (Looped Decoder).
Looped Decoder: cómo hacer que 9 mil millones de parámetros piensen dos veces
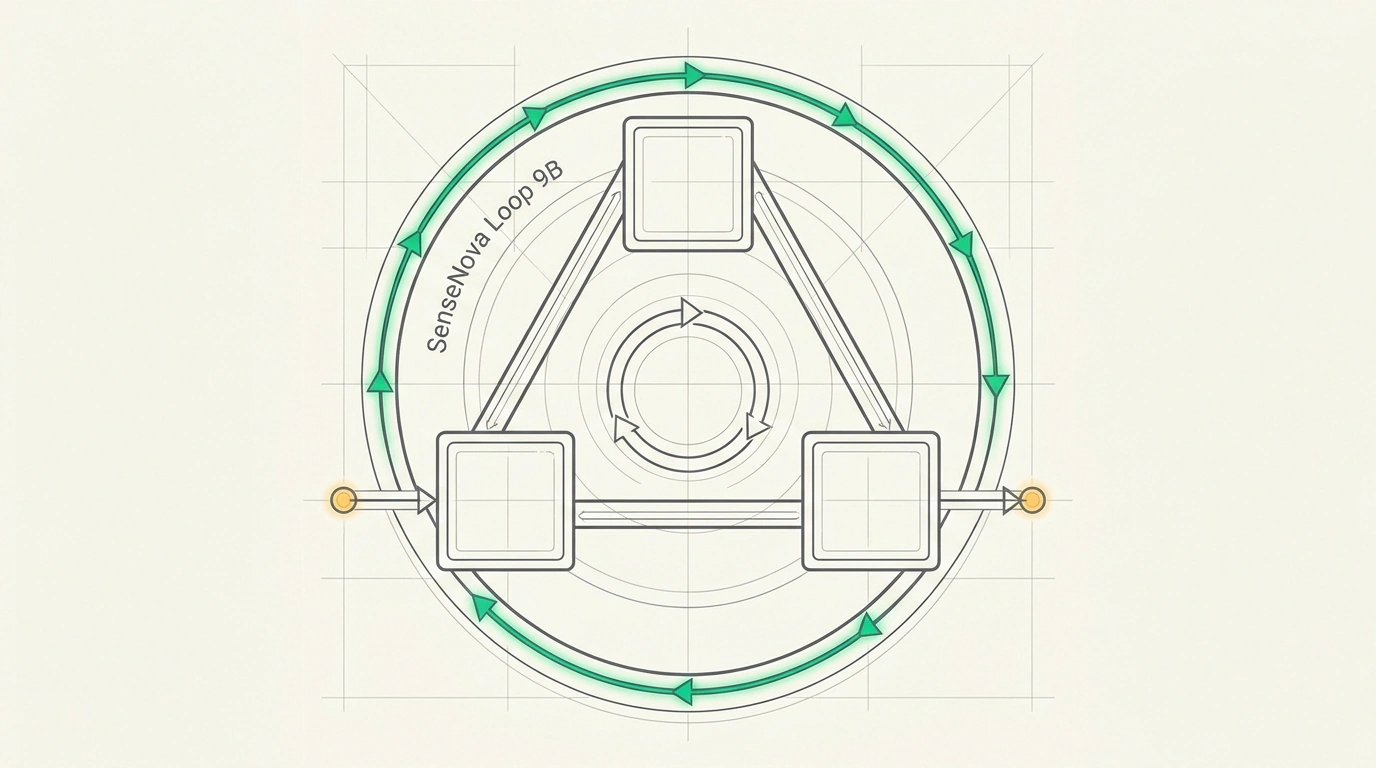
Bajo el capó de SenseNova Loop 9B Preview hay físicamente exactamente 32 capas. Sin embargo, funcionan de una manera muy distinta a la habitual en Llama o Mistral:
- Bloque de entrada (capas 0–3): estas primeras cuatro capas operan de forma lineal. Reciben los embeddings de los tokens entrantes, los proyectan en el espacio multidimensional y forman la representación inicial de la tarea.
- Bloque recurrente (capas 4–27): aquí está el verdadero corazón tecnológico. Este bloque de 24 capas se ejecuta dos veces seguidas con los mismos pesos (weight sharing across loop iterations). Es decir, los estados ocultos del token recorren las capas de la 4 a la 27, luego el resultado vuelve a la entrada de la capa 4 y recorre exactamente el mismo camino por segunda vez.
- Bloque de salida (capas 28–31): las últimas cuatro capas y la cabeza de proyección reciben el contexto enriquecido y decodifican la probabilidad final del siguiente token.
Calculemos la profundidad efectiva del paso hacia adelante. Tenemos 4 capas iniciales + 24 capas del primer ciclo + 24 capas del segundo ciclo + 4 capas finales. ¡En total, 56 capas computacionales por cada token!
Seguro te estás preguntando ahora: si los mismos pesos se ejecutan dos veces, ¿por qué los estados ocultos no explotan ni se convierten en ruido infinito? En los primeros intentos de investigación por hacer bucles en transformadores ocurría exactamente eso: los gradientes se degradaban y el contexto se desmoronaba. Para vencer ese efecto, los desarrolladores aplicaron el mecanismo de doble flujo mHC (Manifold-Constrained Hyper-Connections). Son dos buses paralelos de conexiones residuales (residual streams) con restricciones matemáticas sobre variedades, que mantienen las representaciones vectoriales dentro de un corredor estable y transfieren suavemente el contexto acumulado entre la primera y la segunda pasada.
Además, cada cuatro capas en el modelo se alternan: la atención lineal (linear attention) se sustituye por atención cuadrática completa (full attention). Gracias a este mecanismo híbrido, SenseNova Loop es capaz de mantener una ventana de contexto de hasta 262,144 tokens sin exigir terabytes de memoria gráfica para la caché KV.
Benchmarks de negocio: cuando menos significa más rápido y más preciso
Lo mejor de este lanzamiento es que sus creadores no se pusieron a competir en trivias sintéticas abstractas, sino que publicaron mediciones en escenarios reales de aplicación:
- Análisis financiero y trabajo con tablas (Financial QA & Tabular Reasoning): el modelo superó a Gemma-2-27B en un 4.2% y a Qwen-2.5-14B en un 6.8%. Confunde con mucha menor frecuencia las filas en presupuestos complejos y no pierde cifras en balances contables.
- Llamada a herramientas externas (Tool Calling): al resolver tareas agénticas de múltiples pasos, la precisión de llamadas exitosas a la API en el primer intento alcanzó el 78.4% frente al 71.2% de los modelos abiertos estándar de 9 mil millones de parámetros.
- Apetito de memoria: en formato BF16 todo el modelo ocupa solo unos 19 GB de VRAM. Y si se aplica cuantización de 4 bits AWQ o el formato GGUF, los pesos se comprimen a unos ridículos 6.5 GB. Esto significa que un modelo de trabajo completo con nivel de razonamiento de 27B cabe sin problemas en la memoria de una sola tarjeta gráfica de consumo o de una laptop con 16 GB de RAM.
Despliegue práctico y escollos de la inferencia
Como el modelo está publicado bajo la licencia Apache 2.0, se puede integrar sin riesgos legales en productos comerciales y ejecutarlo en servidores propios. Sin embargo, aquí es importante entender el precio del compromiso.
No hay milagros: físicamente hay 9 mil millones de pesos, pero sobre cada token se ejecutan tantas operaciones aritméticas como en un modelo de 16 mil millones. Debido a la segunda pasada por las capas intermedias, la latencia de generación es aproximadamente 1.6 veces mayor que en una red lineal convencional del mismo tamaño. En una tarjeta NVIDIA RTX 4090 con cuantización de 4 bits, el modelo entrega unos cómodos 42 tokens por segundo, pero si tu tarea exige streaming instantáneo de cientos de mensajes a la vez, hay que tener en cuenta este factor.
El segundo matiz es la cuantización. Debido a que las capas de la 4 a la 27 trabajan en dos rangos dinámicos distintos (en la primera pasada el contexto es grueso; en la segunda, detallado), el redondeo ingenuo directo RTN puede romper la lógica. Por eso hay que usar únicamente métodos calibrados como AWQ o GPTQ.
SenseNova Loop 9B demuestra que la era de acumular miles de millones de parámetros sin pensar está dando paso al ingenio arquitectónico. Si necesitas un analista local compacto para documentos y tablas que no devore toda la memoria del sistema, sin duda vale la pena echarle un vistazo a este modelo.
