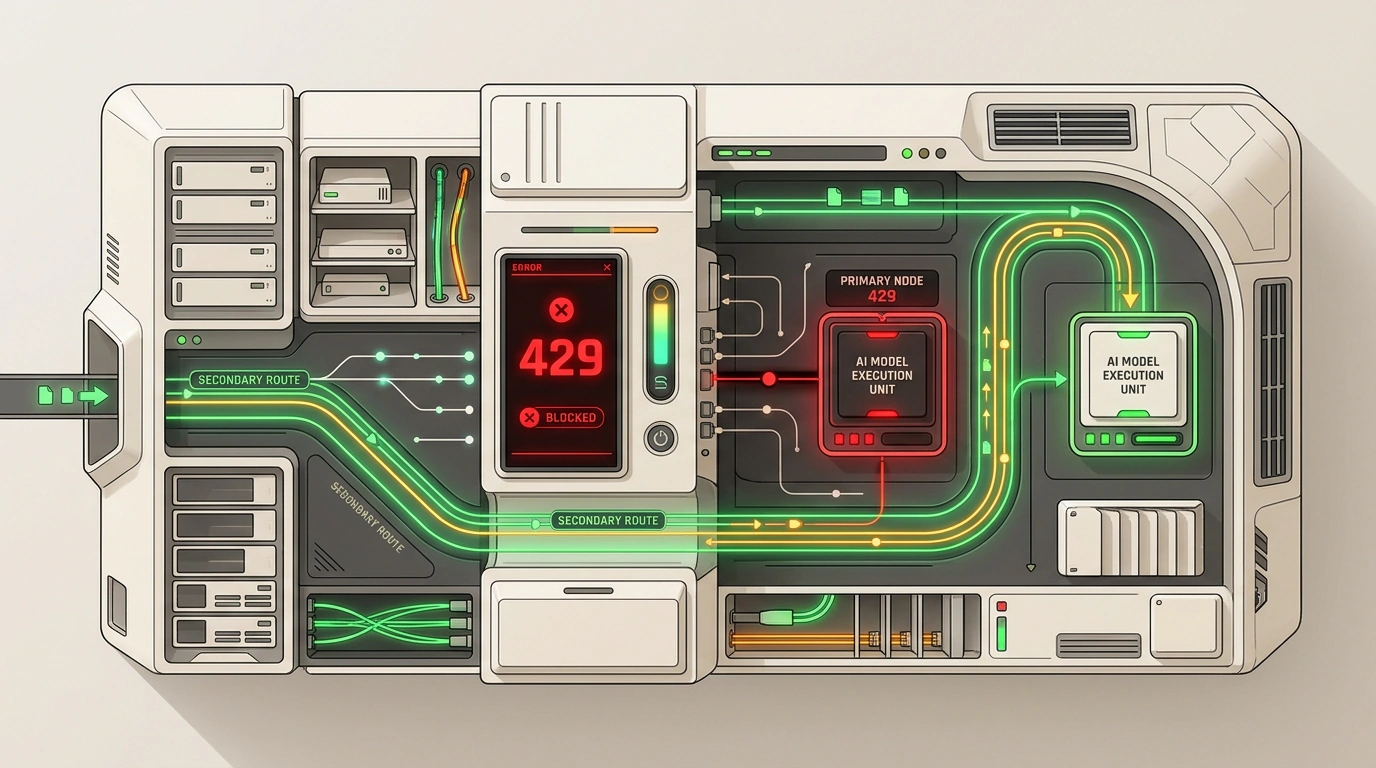
Imagina una escena clásica de trabajo: es de noche, tu agente de IA autónomo lleva cuarenta minutos armando con entusiasmo un embudo de marketing complejo o refactorizando un módulo grande en el repositorio. Decenas de archivos están enlazados entre sí, se generaron esquemas de bases de datos y se escribieron las primeras pruebas. Y de pronto, en la consola salta una línea roja: HTTP 429 Too Many Requests. En la interfaz web de Claude, el contador de cuota muestra sin piedad 0% y la ventana deslizante de cinco horas queda bloqueada hasta bien entrada la madrugada.
En ese momento, la mayoría de los desarrolladores comete exactamente el mismo error: o espera con resignación hasta la mañana, incumpliendo los plazos, o empieza a copiar en pánico fragmentos de código y prompts en la ventana de ChatGPT o Gemini. Pero con el traslado manual el contexto se desmorona al instante: el nuevo modelo no sabe qué subtareas ya se cerraron, confunde variables internas y vuelve a reescribir partes que ya funcionaban. Analicemos la arquitectura de ingeniería «Never Cut Off», que permite cambiar de modelo al vuelo en fracciones de segundo y sin perder el progreso.
La trampa del 429: cómo una pausa repentina rompe las cadenas agénticas
Los límites deslizantes de Anthropic Claude (especialmente los tokens por minuto TPM y las ventanas de mensajes de cinco horas) son estrictos. Si tu agente lee activamente la base de código y envía prompts de sistema pesados, el límite se agota en avalancha.
El problema principal aquí no es el rechazo de la API en sí, sino la pérdida del estado intermedio. Cuando el proceso cae por una excepción, los artefactos no guardados en la memoria operativa del agente se ponen a cero. Para que el pipeline funcione con fiabilidad, la arquitectura debe cumplir tres reglas:
- Monitorear los encabezados antes de que llegue el bloqueo: los servidores de Anthropic envían honestamente en cada respuesta los encabezados
anthropic-ratelimit-requests-remaining,anthropic-ratelimit-tokens-remainingyretry-after. Un gateway inteligente detecta con antelación cuando se acerca a cero. - Serializar el estado en una instantánea estandarizada: antes de pasar el relevo a otra red neuronal, todos los archivos intermedios, pasos completados y contratos de sistema se empaquetan en un manifiesto JSON universal.
- Redirigir el tráfico sin fisuras al modelo de respaldo: el ciclo agéntico ni siquiera debería notar el cambio de ejecutor.
Arquitectura Never Cut Off: serialización de estado y puerta de conmutación
La base de la tolerancia a fallos es una capa proxy intermedia entre tu script y las API externas. Como combinación de respaldo suele configurarse una cascada: el caballo de batalla principal es Claude 3.5 Sonnet, el primer respaldo es GPT-4o, el segundo es el rápido DeepSeek V4.1 Flash y, como nodo local de emergencia ante problemas de internet, el modelo abierto Qwen 2.5 32B desplegado en Ollama.
A continuación se muestra una implementación mínima, pero totalmente lista para producción, de un enrutador tolerante a fallos en Python que supervisa el estado de los límites y realiza un context hand-off transparente:
import os
import json
import time
from typing import Dict, Any, List
import requests

class ResilientAgentRouter:
    def __init__(self):
        self.anthropic_key = os.getenv("ANTHROPIC_API_KEY")
        self.openai_key = os.getenv("OPENAI_API_KEY")
        self.primary_exhausted_until = 0

    def serialize_state(self, system_prompt: str, history: List[Dict], artifacts: Dict[str, Any]) -> Dict[str, Any]:
        # Empaquetado del estado unificado de la tarea sin atadura a un proveedor específico
        return {
            "system_contract": system_prompt,
            "conversation": history,
            "checkpoint_artifacts": artifacts,
            "timestamp": time.time()
        }

    def call_anthropic(self, state: Dict[str, Any]) -> str:
        headers = {
            "x-api-key": self.anthropic_key,
            "anthropic-version": "2023-06-01",
            "content-type": "application/json"
        }
        payload = {
            "model": "claude-3-5-sonnet-20241022",
            "max_tokens": 4096,
            "system": state["system_contract"],
            "messages": state["conversation"]
        }
        response = requests.post("https://api.anthropic.com/v1/messages", headers=headers, json=payload, timeout=60)

        if response.status_code == 429:
            retry_after = int(response.headers.get("retry-after", 300))
            self.primary_exhausted_until = time.time() + retry_after
            raise RuntimeError(f"Límite de Claude agotado. Bloqueo por {retry_after} seg.")

        response.raise_for_status()
        return response.json()["content"][0]["text"]

    def call_openai_fallback(self, state: Dict[str, Any]) -> str:
        headers = {
            "Authorization": f"Bearer {self.openai_key}",
            "Content-Type": "application/json"
        }
        # Inyectamos los artefactos guardados en el prompt de sistema del modelo de respaldo
        augmented_system = (
            f"{state['system_contract']}\n\n"
            f"[ATENCIÓN: Tarea transferida desde el agente anterior. Artefactos actuales: {json.dumps(state['checkpoint_artifacts'], ensure_ascii=False)}]"
        )
        messages = [{"role": "system", "content": augmented_system}] + state["conversation"]

        payload = {
            "model": "gpt-4o",
            "messages": messages,
            "temperature": 0.2
        }
        response = requests.post("https://api.openai.com/v1/chat/completions", headers=headers, json=payload, timeout=60)
        response.raise_for_status()
        return response.json()["choices"][0]["message"]["content"]

    def execute_with_fallback(self, system_prompt: str, history: List[Dict], artifacts: Dict[str, Any]) -> str:
        state = self.serialize_state(system_prompt, history, artifacts)

        # Si el modelo primario está en cooldown, vamos directo al canal de respaldo
        if time.time() < self.primary_exhausted_until:
            print("[ROUTER] Claude en pausa por límites. Redirigiendo solicitud a OpenAI...")
            return self.call_openai_fallback(state)

        try:
            return self.call_anthropic(state)
        except Exception as err:
            print(f"[ROUTER] Fallo en llamada a Claude ({err}). Iniciando hand-off fluido...")
            return self.call_openai_fallback(state)
Sutilezas de la traducción de herramientas y contexto
Al cambiar entre Anthropic y OpenAI, los desarrolladores suelen tropezar con trampas ocultas. Claude y GPT tienen una sintaxis fundamentalmente distinta para declarar llamadas a funciones (Tool Calling). Anthropic espera el parámetro input_schema, mientras que OpenAI exige el objeto parameters. Si simplemente reenvías la solicitud en bruto, el modelo devolverá un error de esquema.
El segundo escollo son las etiquetas de marcado específicas. A Claude le encanta generar etiquetas internas como <antml> o bloques de pensamientos intermedios. Antes de enviar el historial a GPT-4o hay que normalizar esa especificidad; de lo contrario, el modelo de respaldo empezará a alucinar imitando una sintaxis desconocida. Según mediciones en pipelines agénticos prácticos, limpiar el historial de diálogo y aplicar una serialización estricta reduce el riesgo de fallos de formato del 24% a menos del 1.5%.
Despliegue de un proxy local y verificación de tolerancia a fallos
Para no reinventar la rueda en cada script nuevo, en entornos de producción conviene usar el gateway ligero ya listo LiteLLM Proxy. Se encarga del seguimiento automático de los cooldowns y del enrutamiento de solicitudes.
Aquí tienes un ejemplo listo de configuración config.yaml para arrancar un proxy local tolerante a fallos:
model_list:
  - model_name: resilient-assistant
    litellm_params:
      model: anthropic/claude-3-5-sonnet-20241022
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: resilient-assistant
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
router_settings:
  fallbacks: [{"resilient-assistant": ["openai/gpt-4o"]}]
  allowed_fails: 1
  cooldown_time: 300
Se puede iniciar este gateway en la terminal con un solo comando:
litellm --config config.yaml --port 8000
Ahora basta con indicar en cualquier aplicación la URL base http://localhost:8000 y llamar al modelo unificado resilient-assistant. El tiempo de conmutación al recibir un error 429 toma entre 120 y 350 milisegundos: tu agente ni siquiera alcanzará a parpadear antes de seguir escribiendo código por el canal de respaldo, y tú te olvidarás para siempre de las ejecuciones nocturnas arruinadas por los límites.