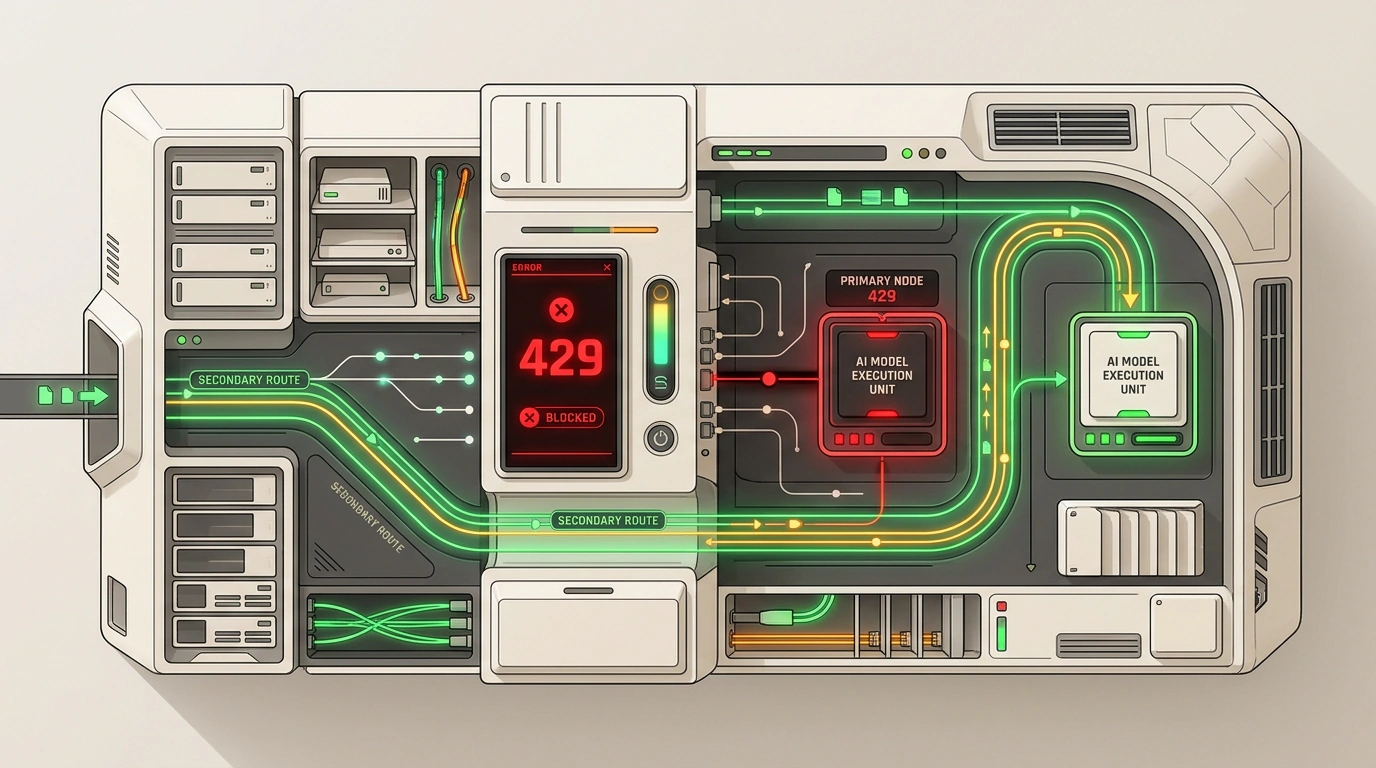
Представь классическую рабочую картину: вечер, твой автономный ИИ-агент уже сорок минут увлеченно собирает сложную маркетинговую воронку или рефакторит большой модуль в репозитории. Десятки файлов связаны между собой, сгенерированы схемы баз данных, написаны первые тесты. И тут в консоли вспыхивает красная строка: HTTP 429 Too Many Requests. В веб-интерфейсе Claude счетчик квоты безжалостно показывает 0%, а скользящее пятичасовое окно заблокировано до глубокой ночи.
В этот момент большинство разработчиков совершают одну и ту же ошибку: либо покорно ждут утра, срывая сроки, либо начинают в панике копировать куски кода и промптов в окно ChatGPT или Gemini. Но при ручном переносе контекст мгновенно рассыпается: новая модель не знает, какие подзадачи уже закрыты, путает внутренние переменные и начинает заново переписывать работающие куски. Давай разберем инженерную архитектуру «Never Cut Off», которая позволяет переключать модели на лету за доли секунды и без потери прогресса.
Ловушка 429: как внезапная пауза ломает агентные цепочки
Скользящие лимиты Anthropic Claude (особенно токены в минуту TPM и пятичасовые окна сообщений) устроены жестко. Если твой агент активно читает кодовую базу и отправляет увесистые системные промпты, лимит исчерпывается лавинообразно.
Главная проблема здесь не в самом отказе API, а в потере промежуточного состояния. Когда процесс падает по исключению, несохраненные артефакты в оперативной памяти агента обнуляются. Чтобы конвейер работал надежно, архитектура должна соблюдать три правила:
- Мониторить заголовки до наступления блокировки: серверы Anthropic честно присылают в каждом ответе заголовки
anthropic-ratelimit-requests-remaining,anthropic-ratelimit-tokens-remainingиretry-after. Умный шлюз видит приближение нуля заранее. - Сериализовать состояние в стандартизированный снимок: перед передачей эстафеты другой нейросети все промежуточные файлы, выполненные шаги и системные контракты упаковываются в универсальный JSON-манифест.
- Бесшовно перенаправлять трафик на модель-дублер: агентный контур даже не должен замечать смены исполнителя.
Архитектура Never Cut Off: сериализация состояния и шлюз переключения
Основа отказоустойчивости — промежуточный прокси-слой между твоим скриптом и внешними API. В качестве резервной связки обычно настраивают каскад: основной рабочей лошадкой выступает Claude 3.5 Sonnet, первым резервом — GPT-4o, вторым — быстрая DeepSeek V4.1 Flash, а аварийным локальным узлом на случай проблем с интернетом — развернутая в Ollama открытая Qwen 2.5 32B.
Ниже показана минимальная, но полностью боевая реализация отказоустойчивого роутера на Python, который отслеживает статус лимитов и делает прозрачный context hand-off:
import os
import json
import time
from typing import Dict, Any, List
import requests

class ResilientAgentRouter:
    def __init__(self):
        self.anthropic_key = os.getenv("ANTHROPIC_API_KEY")
        self.openai_key = os.getenv("OPENAI_API_KEY")
        self.primary_exhausted_until = 0

    def serialize_state(self, system_prompt: str, history: List[Dict], artifacts: Dict[str, Any]) -> Dict[str, Any]:
        # Упаковка единого состояния задачи без привязки к конкретному вендору
        return {
            "system_contract": system_prompt,
            "conversation": history,
            "checkpoint_artifacts": artifacts,
            "timestamp": time.time()
        }

    def call_anthropic(self, state: Dict[str, Any]) -> str:
        headers = {
            "x-api-key": self.anthropic_key,
            "anthropic-version": "2023-06-01",
            "content-type": "application/json"
        }
        payload = {
            "model": "claude-3-5-sonnet-20241022",
            "max_tokens": 4096,
            "system": state["system_contract"],
            "messages": state["conversation"]
        }
        response = requests.post("https://api.anthropic.com/v1/messages", headers=headers, json=payload, timeout=60)

        if response.status_code == 429:
            retry_after = int(response.headers.get("retry-after", 300))
            self.primary_exhausted_until = time.time() + retry_after
            raise RuntimeError(f"Лимит Claude исчерпан. Блокировка на {retry_after} сек.")

        response.raise_for_status()
        return response.json()["content"][0]["text"]

    def call_openai_fallback(self, state: Dict[str, Any]) -> str:
        headers = {
            "Authorization": f"Bearer {self.openai_key}",
            "Content-Type": "application/json"
        }
        # Инжектируем сохраненные артефакты в системный промпт резервной модели
        augmented_system = (
            f"{state['system_contract']}\n\n"
            f"[ВНИМАНИЕ: Задача передана от предыдущего агента. Текущие артефакты: {json.dumps(state['checkpoint_artifacts'], ensure_ascii=False)}]"
        )
        messages = [{"role": "system", "content": augmented_system}] + state["conversation"]

        payload = {
            "model": "gpt-4o",
            "messages": messages,
            "temperature": 0.2
        }
        response = requests.post("https://api.openai.com/v1/chat/completions", headers=headers, json=payload, timeout=60)
        response.raise_for_status()
        return response.json()["choices"][0]["message"]["content"]

    def execute_with_fallback(self, system_prompt: str, history: List[Dict], artifacts: Dict[str, Any]) -> str:
        state = self.serialize_state(system_prompt, history, artifacts)

        # Если первичная модель на кулдауне, сразу идем в резервный канал
        if time.time() < self.primary_exhausted_until:
            print("[ROUTER] Claude на паузе по лимитам. Направляем запрос в OpenAI...")
            return self.call_openai_fallback(state)

        try:
            return self.call_anthropic(state)
        except Exception as err:
            print(f"[ROUTER] Сбой вызова Claude ({err}). Запускаем бесшовный hand-off...")
            return self.call_openai_fallback(state)
Тонкости трансляции инструментов и контекста
При переключении между Anthropic и OpenAI разработчики часто наступают на скрытые грабли. У Claude и GPT принципиально разный синтаксис объявления вызова функций (Tool Calling). Anthropic ожидает параметр input_schema, а OpenAI требует объект parameters. Если ты просто перенаправишь сырой запрос, модель вернет ошибку схемы.
Второй подводный камень — специфичные теги разметки. Claude любит генерировать внутренние теги вроде <antml> или блоки промежуточных мыслей. Перед отправкой истории в GPT-4o эту специфику нужно нормализовать, иначе резервная модель начнет галлюцинировать, подражая незнакомому синтаксису. По замерам на практических агентных пайплайнах, очистка истории диалога и строгая сериализация снижают риск сбоев формата с 24% до менее чем 1.5%.
Развертывание локального прокси и проверка отказоустойчивости
Чтобы не писать кастомные велосипеды для каждого нового скрипта, в production-контурах удобно использовать готовый легковесный шлюз LiteLLM Proxy. Он берет на себя автоматический учет кулдаунов и маршрутизацию запросов.
Вот готовый пример конфигурации config.yaml для запуска локального отказоустойчивого прокси:
model_list:
  - model_name: resilient-assistant
    litellm_params:
      model: anthropic/claude-3-5-sonnet-20241022
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: resilient-assistant
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
router_settings:
  fallbacks: [{"resilient-assistant": ["openai/gpt-4o"]}]
  allowed_fails: 1
  cooldown_time: 300
Запустить такой шлюз в терминале можно одной командой:
litellm --config config.yaml --port 8000
Теперь в любом приложении достаточно указать базовый URL http://localhost:8000 и вызывать единую модель resilient-assistant. Время переключения при получении ошибки 429 занимает от 120 до 350 миллисекунд: твой агент даже не успеет моргнуть, как продолжит писать код уже через резервный канал, а ты навсегда забудешь о сорванных из-за лимитов ночных запусках.