Каждый разработчик в бэкенде рано или поздно сталкивается с безобидной на первый взгляд задачей от бизнеса: «Сделай кнопку "Выгрузить все заказы в Excel"». Ты открываешь проект, пишешь обработчик, делаешь SELECT * FROM orders, сериализуешь полученный массив объектов в строки через запятую и отправляешь клиенту. На локальной машине с базой на 500 строк все летает.
Но проходит полгода, проект вырастает, и в таблице накапливается 350 тысяч записей. Менеджер нажимает кнопку выгрузки, через три секунды второй менеджер повторяет действие, и сервер приложений внезапно падает с фатальной ошибкой JavaScript heap out of memory.
В среде Node.js с движком V8 наивная буферизация больших выборок в память — это гарантированная мина замедленного действия. Каждая строка из базы превращается в объект с скрытыми классами (hidden classes) V8, для конвертации создаются миллионы промежуточных строковых буферов, а сборщик мусора (GC) впадает в ступор.
В подробном практическом исследовании saprahan на Хабре инженер разобрал промышленную архитектуру стриминга данных из PostgreSQL в CSV с использованием фреймворка Fastify, query builder Knex.js и асинхронных генераторов.
Давай разберем эту механику по шагам: как выстроить сквозной конвейер без промежуточного сохранения на диск, обойти ловушку микросекунд и сохранить константное потребление памяти.
Почему наивный SELECT убивает память Node.js
Чтобы осознать масштаб проблемы, достаточно взглянуть на реальные замеры потребления ресурсов. В тестовом стенде выгружалась типовая таблица на 347 000 строк (результирующий CSV-файл весит около 37 мегабайт):
- Наивный метод (все строки в память процесса): Запрос отработал быстро — за 2.0 секунды. Но пиковый расход памяти кучи (
heapUsed) подскочил до 576 МБ, а общий размер процесса (RSS) превысил 833 МБ. При дефолтном лимите кучи Node.js в 1.4 ГБ два одновременных экспорта гарантированно роняют под или процесс в OOM. - Потоковый метод с пагинацией OFFSET: Расход кучи упал до стабильных 86 МБ, но время выполнения выросло в 7 раз — до 14.5 секунды.
Почему классический LIMIT 1000 OFFSET 200000 работает так медленно? Потому что реляционная база данных не умеет прыгать в произвольное место диска по номеру строки. Чтобы отдать тысячу строк с оффсетом 200 тысяч, планировщик PostgreSQL вынужден физически прочитать с диска 200 000 строк, отбросить их и только потом вернуть нужную пачку. Сложность такого запроса составляет $O(OFFSET + LIMIT)$. На каждой следующей странице сервер базы данных тратит все больше процессорного времени впустую.
Keyset-пагинация против OFFSET: бенчмарки и ловушка микросекунд
Единственный способ выгружать данные быстро и легко — использовать Keyset-пагинацию (пагинацию по курсору). Вместо подсчета смещения мы опираемся на составной B-tree индекс по полям сортировки, как мы уже обсуждали в материале о нюансах оптимизации PostgreSQL:
CREATE INDEX CONCURRENTLY idx_orders_created_at_id ON orders ("createdAt" DESC, id DESC);
Каждая следующая пачка запрашивается через сравнение кортежей: (createdAt, id) < (cursorCreatedAt, cursorId). База мгновенно находит нужную точку в индексе со сложностью $O(\log N)$.
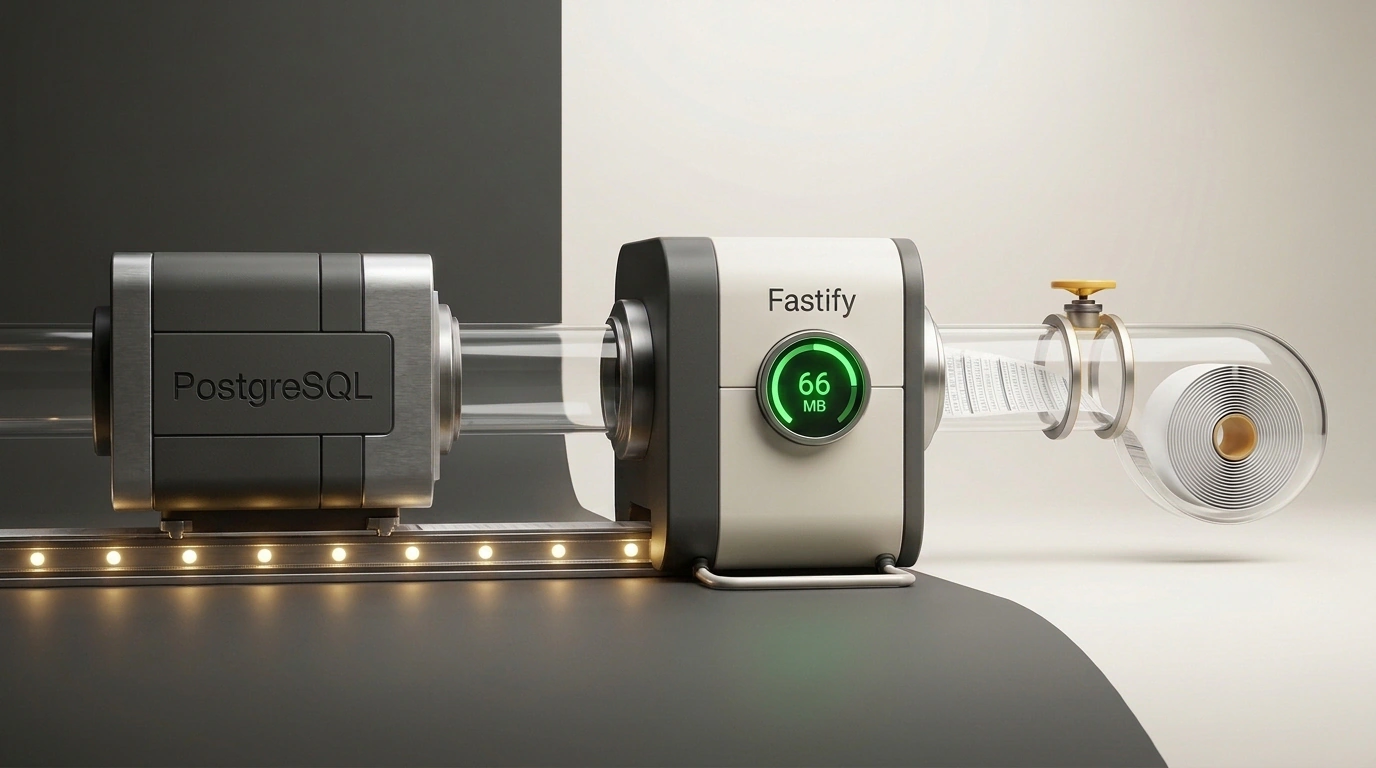
В бенчмарке на тех же 347 000 строк связка потока и Keyset-пагинации показала феноменальный результат:
- Время выполнения: всего 2.8 секунды (практически как у наивного метода в памяти);
- Пиковый
heapUsed: всего 66 МБ (в 9 раз меньше!); - Пиковый
RSS: 173 МБ.
Но здесь разработчиков подстерегает коварнейшая ловушка платформы, на которой легко потерять данные.
В объекте JavaScript Date время хранится в миллисекундах (3 знака после запятой). А в PostgreSQL тип timestamptz хранит микросекунды (6 знаков). Когда драйвер pg автоматически парсит дату из базы в JS-объект, микросекунды безвозвратно отсекаются.
Если в одну и ту же миллисекунду было создано несколько записей, усеченный курсор в следующем запросе отфильтрует строки с тем же временем, но меньшими микросекундами. В результате из выгрузки бесследно пропадут десятки строк!
Решение изящно: извлекать таймстемп из базы строго в виде сырого текста records."createdAt"::text as "cursorTs" и передавать его обратно в SQL с явным приведением типа (?::timestamptz, ?).
Сквозной стриминг через Fastify, противодавление и совместимость с Excel
Сам файл CSV на сервере не сохраняется ни на секунду. Мы строим конвейер с помощью нативного Readable-стрима:
import { Readable } from 'node:stream';
import { Knex } from 'knex';

const CHUNK_SIZE = 2000;
const DELIMITER = ';';
const UTF8_BOM = '\uFEFF';
const COLUMNS = ['id', 'email', 'status', 'createdAt'];

function escapeCsv(val: any): string {
  if (val == null) return '';
  const str = val instanceof Date ? val.toISOString() : String(val);
  return /[";\r\n]/.test(str) ? `"${str.replace(/"/g, '""')}"` : str;
}

export async function* generateOrdersCsv(db: Knex) {
  // Добавляем UTF-8 BOM и заголовок с разделителем точка с запятой для Excel
  yield UTF8_BOM + COLUMNS.join(DELIMITER) + '\r\n';

  let cursor: { createdAt: string; id: number } | null = null;

  for (;;) {
    const query = db('orders')
      .select('orders.*', db.raw('orders."createdAt"::text as "cursorTs"'))
      .orderBy('createdAt', 'desc')
      .orderBy('id', 'desc')
      .limit(CHUNK_SIZE);

    if (cursor) {
      query.whereRaw('(orders."createdAt", orders.id) < (?::timestamptz, ?)', [
        cursor.createdAt,
        cursor.id,
      ]);
    }

    const chunk = await query;
    if (!chunk.length) break;

    for (const row of chunk) {
      const line = COLUMNS.map((col) => escapeCsv(row[col])).join(DELIMITER);
      yield line + '\r\n';
    }

    const last = chunk[chunk.length - 1];
    cursor = { createdAt: last.cursorTs, id: last.id };
  }
}
Обрати внимание на три критические мелочи для совместимости с Microsoft Excel:
\uFEFF(Byte Order Mark) в самом начале потока сообщает Excel, что файл закодирован в UTF-8, предотвращая появление нечитаемых «кракозябр» вместо кириллицы.- Разделитель
;(точка с запятой) вместо запятой — стандарт для русскоязычной локали Excel. - Символы перевода строк строго
\r\n(CRLF).
Защита соединения, прерывание клиента и временные токены скачивания
Фреймворк Fastify нативно понимает потоки Node.js. Когда ты вызываешь reply.send(Readable.from(generator)), Fastify самостоятельно подключает поток к HTTP-сокету, выставляет заголовок Transfer-Encoding: chunked и активирует механизм противодавления (backpressure). Если у пользователя медленный мобильный интернет, поток автоматически приостанавливает генерацию пачек из базы, не раздувая память.
Но что, если пользователь закрыл вкладку на десятой секунде скачивания? Если не обработать разрыв соединения, асинхронный генератор продолжит вычитывать миллионы строк из базы в никуда.
Кроме того, браузерное скачивание по прямой ссылке не умеет передавать заголовок Authorization: Bearer. Решением выступает генерация одноразового подписанного JWT-токена с временем жизни 5 минут:
import Fastify, { FastifyInstance, FastifyRequest, FastifyReply } from 'fastify';
import { Readable } from 'node:stream';
import jwt from 'jsonwebtoken';
import { generateOrdersCsv } from './orders-export';

export function setupExportRoutes(app: FastifyInstance, db: any, secret: string) {
  app.get('/api/orders/export', async (req: FastifyRequest<{ Querystring: { token: string } }>, reply: FastifyReply) => {
    const { token } = req.query;
    if (!token) return reply.code(401).send({ error: 'Требуется токен' });

    try {
      const payload: any = jwt.verify(token, secret);
      if (payload.scope !== 'orders-csv') throw new Error('Неверный scope');
    } catch {
      return reply.code(403).send({ error: 'Токен недействителен или просрочен' });
    }

    const filename = `orders-${new Date().toISOString().slice(0, 10)}.csv`;
    reply.header('Content-Disposition', `attachment; filename="${filename}"`);
    reply.type('text/csv; charset=utf-8');

    const generator = generateOrdersCsv(db);
    const stream = Readable.from(generator);

    // При обрыве соединения клиентом прерываем генератор, освобождая базу
    reply.raw.on('close', () => {
      if (!reply.raw.writableEnded) {
        stream.destroy();
      }
    });

    return reply.send(stream);
  });
}
Такая архитектура делает экспорт несокрушимым: сервер держит стабильные 60 мегабайт оперативной памяти при любых объемах данных, Excel открывает файл идеально, а медленные клиенты или обрывы связи не создают утечек соединений в пуле PostgreSQL.