Если ты хоть раз пробовал запустить локальную языковую модель на домашней рабочей станции или обычном офисном ноутбуке, то наверняка упирался в железную стену видеопамяти. Индустрия последних лет приучила нас к грубому экстенсивному правилу: хочешь, чтобы нейросеть лучше понимала сложные таблицы, разбирала бухгалтерские отчеты или четко дергала ручки API — готовься скачивать модели на 27, 32 или 70 миллиардов параметров. А это сразу означает покупку топовых карт уровня RTX 4090, танцы с квантованием или бесконечные счета за облачные кластеры.
Но 30 октября 2026 года исследовательское подразделение SenseNova китайской компании SenseTime показало, что закон масштабирования можно взломать совсем с другой стороны. Они опубликовали в открытом доступе под свободной лицензией Apache 2.0 модель SenseNova Loop 9B Preview. Физически в ней всего 9 миллиардов параметров, но на практических бизнес-тестах она уверенно кладет на лопатки открытые трансформеры на 27 миллиардов весов, включая такие признанные хиты, как Gemma 2 27B и Qwen 2.5 14B. Давай разберемся, как устроена эта рекурсивная магия и где здесь спрятаны инженерные компромиссы.
Почему гигантские веса заходят в тупик
В классическом трансформере каждый слой нейросети уникален. Представь длинный конвейер из 32 или 48 независимых цехов: токен влетел в первый цех, прошел через него, перешел во второй, в третий — и так строго по прямой до самого выхода. Ни один рабочий в этом цехе не видит деталь повторно. Чтобы повысить «ум» такой системы, инженеры традиционно просто достраивали новые цеха, увеличивая длину фабрики и количество нанятых рабочих.
В результате мы получили монстров, которые физически не влезают в память. Даже в формате половинной точности BF16 модель на 27 миллиардов параметров требует больше 55 гигабайт чистой VRAM. Квантование выручает, но при сильном сжатии до 4 бит у многих сетей начинают плыть тонкие логические связи.
Команда SenseTime задала простой, но дерзкий вопрос: а что, если вместо бесконечного расширения цехов заставить самую опытную группу рабочих осмотреть сложную деталь дважды? Именно эта идея лежит в основе концепции рекуррентной глубины (recurrent depth), или зацикленного трансформера (Looped Decoder).
Looped Decoder: как заставить 9 миллиардов параметров думать дважды
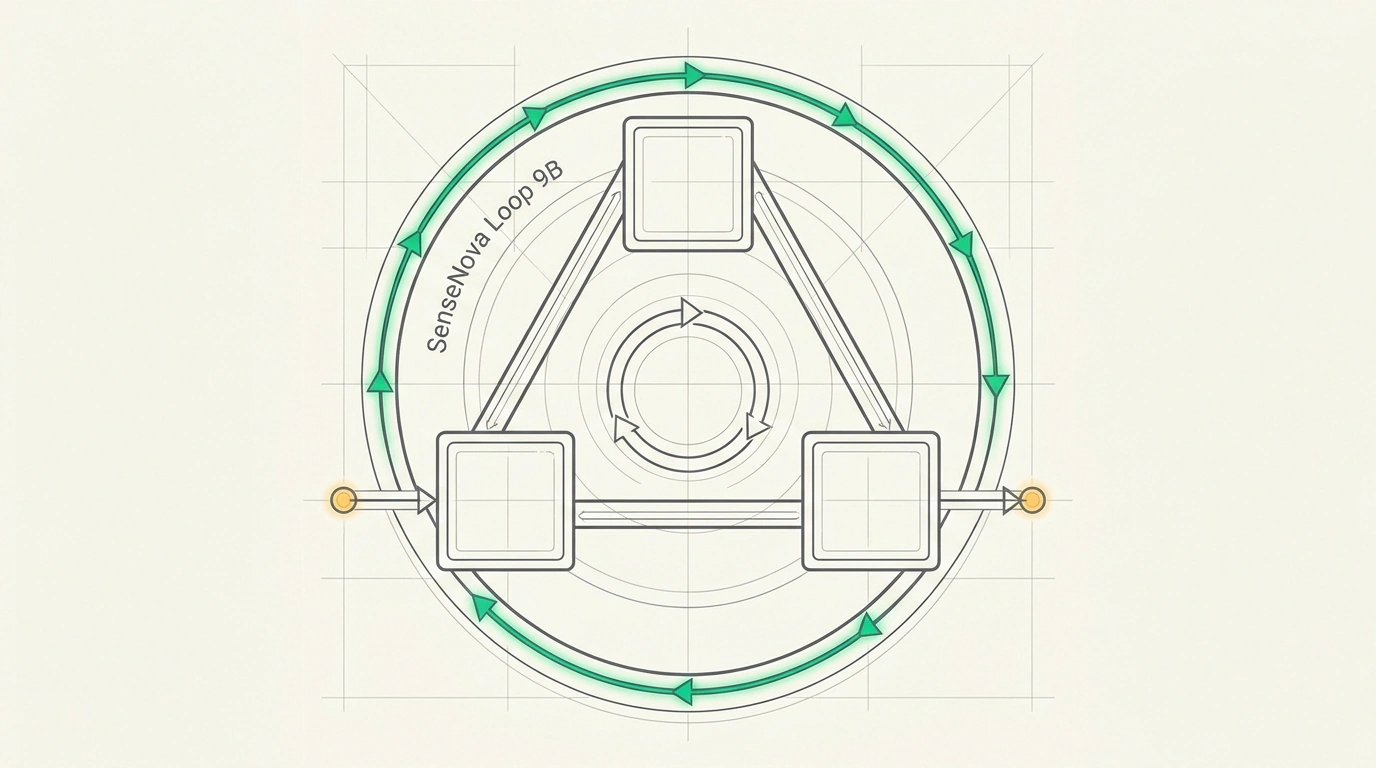
Под капотом SenseNova Loop 9B Preview физически размещены ровно 32 слоя. Однако работают они совершенно не так, как в привычной Llama или Mistral:
- Входной блок (слои 0–3): эти первые четыре слоя работают линейно. Они принимают эмбеддинги входящих токенов, проецируют их в многомерное пространство и формируют первичное представление задачи.
- Рекуррентный блок (слои 4–27): вот здесь находится главное технологическое сердце. Этот блок из 24 слоев выполняется два раза подряд с одними и теми же весами (weight sharing across loop iterations). То есть скрытые состояния токена проходят слои с 4 по 27, затем результат снова возвращается на вход 4-го слоя и пробегает тот же путь во второй раз.
- Выходной блок (слои 28–31): финальные четыре слоя и проекционная голова принимают обогащенный контекст и декодируют итоговую вероятность следующего токена.
Давай посчитаем эффективную глубину прямого прохода. Мы имеем 4 начальных слоя + 24 слоя первого цикла + 24 слоя второго цикла + 4 финальных слоя. Итого 56 вычислительных слоев на каждый токен!
Ты сейчас наверняка спросишь: если одни и те же веса прогоняются дважды, почему скрытые состояния не взрываются и не уходят в бесконечный шум? В ранних исследовательских попытках зацикливания трансформеров ровно это и происходило — градиенты деградировали, а контекст разваливался. Чтобы победить этот эффект, разработчики применили двухпоточный механизм mHC (Manifold-Constrained Hyper-Connections). Это две параллельные шины остаточных связей (residual streams) с математическими ограничениями на многообразиях, которые удерживают векторные представления в стабильном коридоре и плавно передают накопленный контекст между первым и вторым проходом.
Вдобавок каждые четыре слоя в модели чередуются: линейное внимание (linear attention) сменяется полным квадратичным вниманием (full attention). Благодаря этому гибридному механизму SenseNova Loop способна удерживать контекстное окно до 262 144 токенов, не требуя терабайтов графической памяти под KV-кэш.
Бенчмарки бизнеса: когда меньше значит быстрее и точнее
Самое приятное в этом релизе — то, что создатели не стали соревноваться в абстрактных синтетических викторинах, а выкатили замеры на реальных прикладных сценариях:
- Финансовый анализ и работа с таблицами (Financial QA & Tabular Reasoning): модель обошла Gemma-2-27B на 4.2%, а Qwen-2.5-14B — на 6.8%. Она намного реже путает строки в сложных сметах и не теряет цифры в бухгалтерских балансах.
- Вызов внешних инструментов (Tool Calling): при решении многошаговых агентных задач точность успешного обращения к API с первой попытки составила 78.4% против 71.2% у стандартных открытых моделей на 9 миллиардов параметров.
- Аппетиты к памяти: в формате BF16 вся модель занимает всего около 19 ГБ VRAM. А если применить 4-битное квантование AWQ или формат GGUF, веса ужимаются до смешных 6.5 ГБ! Это означает, что полноценная рабочая модель с рассуждениями уровня 27B спокойно помещается в память одного потребительского видеоадаптера или ноутбука с 16 ГБ RAM.
Практический запуск и подводные камни инференса
Поскольку модель выложена под лицензией Apache 2.0, ее можно без юридических рисков встраивать в коммерческие продукты и крутить на собственных серверах. Однако здесь важно понимать цену компромисса.
Чудес на свете не бывает: физически весов 9 миллиардов, но арифметических операций над каждым токеном выполняется столько же, сколько в 16-миллиардной модели. Из-за повторного прохода средних слоев задержка генерации (latency) примерно в 1.6 раза выше, чем у обычной линейной сети того же размера. На видеокарте NVIDIA RTX 4090 при 4-битном квантовании модель выдает комфортные 42 токена в секунду, но если твоя задача требует мгновенного стриминга сотен сообщений одновременно, этот фактор надо учитывать.
Второй нюанс — квантование. Из-за того, что слои с 4 по 27 работают в двух разных динамических диапазонах (на первом проходе контекст грубый, на втором — детализированный), прямое наивное округление RTN может сломать логику. Поэтому использовать нужно только калиброванные методы вроде AWQ или GPTQ.
SenseNova Loop 9B доказывает: время бездумного наращивания миллиардов параметров уступает место архитектурной изобретательности. Если тебе нужен компактный локальный аналитик для документов и таблиц, который не сожрет всю память системы, к этой модели определенно стоит присмотреться.