En la industria de las redes neuronales se ha instalado una curiosa dualidad. Los creadores de los mayores modelos de lenguaje invierten recursos colosales en limpiar sus muestras: eliminan borradores e hipótesis fallidas de los datasets y dejan solo versiones finales impecables de artículos. Pero la ciencia real funciona justo al revés: en los laboratorios la mayoría de los experimentos termina en fallo, y precisamente esos callejones sin salida trazan los límites reales de las leyes de la naturaleza.
Cuando el equipo de investigación de Deep Principle entrenó el modelo abierto Hydrogen 1.0 con archivos de experimentos fallidos, superó a los sistemas cerrados más caros del mundo. Revisé el informe técnico de los desarrolladores: veamos por qué analizar tropiezos ajenos resultó más eficaz para la IA que memorizar respuestas correctas.
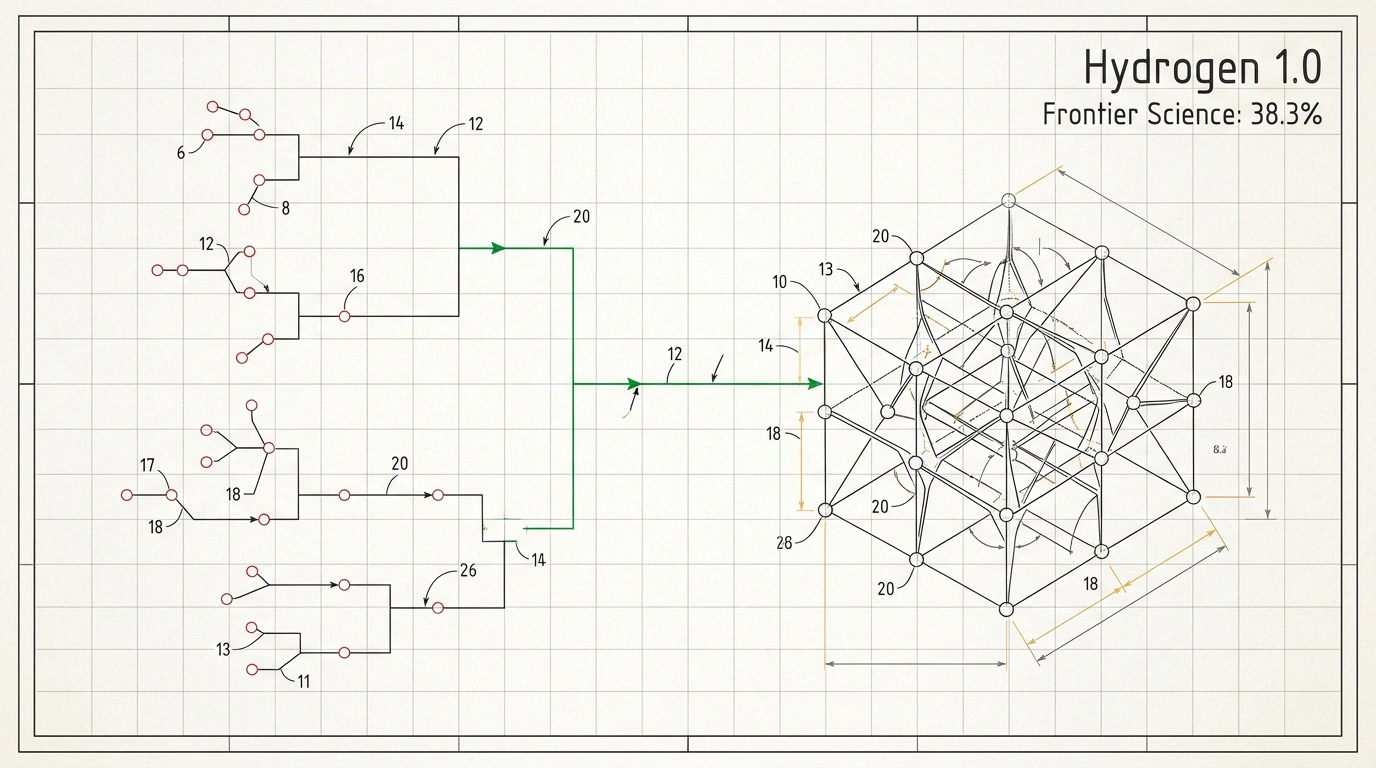
Avance en el test Frontier Science: 38.3% del modelo abierto frente al 33.3% del líder cerrado
Suele darse por sentado que resolver problemas en la frontera de la ciencia solo está al alcance de gigantes comerciales cerrados. El modelo Hydrogen 1.0, lanzado el 2 de noviembre de 2026 y analizado por Julian Goldie en su vídeo, desmintió esa idea con cifras.
En el benchmark interdisciplinar Frontier Science Research (FSR — prueba de resolución de problemas en química, ciencia de materiales y bioingeniería), el desarrollo de Deep Principle obtuvo un 38.3%, superando al líder GPT-6 Astra y su 33.3% por 5 puntos porcentuales. Me impresionó la arquitectura pragmática del modelo: sobre la base abierta GLM-5.3 con mezcla de expertos (Mixture of Experts, MoE — esquema en el que al procesar una palabra solo se activa una pequeña parte de la red), de 753 mil millones de parámetros se activan alrededor de 40 mil millones por token. Su ventana de contexto admite 1,000,000 de tokens de entrada y hasta 128,000 tokens de generación, lo que permite cargar monografías enteras y tablas de mediciones.
Cómo los archivos de experimentos fallidos y las trayectorias de búsqueda curan a la red neuronal de adivinar
Con razón te preguntarás: ¿de dónde sale semejante ventaja con un número moderado de pesos activos? A los modelos convencionales se les premia durante el alineamiento por ofrecer un resultado pulido, como un estudiante somnoliento que adivina una fórmula verosímil. Pero en ciencia más del 90% de los experimentos fracasan, y sin entender las causas de esos fallos el algoritmo no percibe las restricciones físicas.
En Deep Principle reunieron un dataset de cuatro capas: teoría sobre química, materiales y ciencias de la vida; escenarios reales de sus propios científicos; registros de cuadernos electrónicos de laboratorio (Electronic Laboratory Notebooks, ELN); y trayectorias de descubrimiento: cadenas completas desde la hipótesis y el error hasta el ajuste de parámetros. Ya analicé un descarte similar de ramas débiles en el repaso del modo de razonamiento paralelo Gemini Deep Think, pero en Hydrogen 1.0 esa capacidad viene grabada directamente en los pesos mediante archivos de ensayos.
Cuando un ingeniero químico diseña un nuevo polímero resistente al calor y pide una ruta de síntesis, la diferencia de entrenamiento salta a la vista. Una red neuronal común devuelve una receta pulida tomada de artículos exitosos que en el reactor se convierte en resina inutilizable. Hydrogen 1.0, apoyándose en los registros ELN, analiza la hipótesis y descarta de forma secuencial tres vías de síntesis sin salida antes de responder, señalando los límites ocultos de temperatura donde se degrada el catalizador.
Para el investigador esto ahorra semanas de trabajo y reactivos: el tecnólogo ve al instante las zonas térmicas peligrosas y guía la reacción por un margen seguro. Tras estudiar miles de fracasos documentados, la red neuronal deja de imitar el tono de los informes triunfales y empieza a razonar por eliminación.
Del reactor químico a los flujos de trabajo: despliegue local y validación de hipótesis de negocio
Esta deducción mediante descarte de callejones sin salida también resulta útil fuera de los laboratorios científicos. Los pesos de Hydrogen 1.0 están abiertos bajo licencia MIT junto con compilaciones de 4 bits NVFP4 (vía NVIDIA ModelOpt) y MXFP4 (para aceleradores AMD). Las empresas pueden ejecutar el modelo en sus propios servidores sin enviar secretos a API externas, especialmente con el enrutamiento veloz de nuestro análisis sobre optimización de inferencia MoE en el motor vLLM. Y el propio principio de buscar errores Julian Goldie aconseja trasladarlo a la rutina laboral: detectar con ayuda de la IA tres puntos de fricción en correos de onboarding, identificar las tres principales lagunas a partir de 20 preguntas reales de clientes y registrar en los primeros 30 minutos de prueba de un servicio nuevo dónde falla.
El éxito de Hydrogen 1.0 muestra hacia dónde irá la industria. Las reservas de textos públicos limpios en internet se han agotado, así que el próximo salto en precisión de la IA lo darán los equipos que abran para entrenar sus propios registros internos de bugs, hipótesis descartadas y protocolos de pruebas fallidas.