21 de noviembre · NotaPruebas independientes de Gemini 4 Neon: 110 tokens/s, 65% en Cursor Bench y tests en código real👍 10+1
25 de octubre · A fondoKimi K3.1 Pro: el modelo chino de pesos abiertos al nivel de Claude Opus 5.5👍 0
11 de noviembre · ArtículoLanzamiento de Claude Fable 5.2 de Anthropic: 1 millón de contexto, 128 mil tokens de salida y pruebas de estrés con artefactos interactivos👍 27
11 de noviembre · NotaSWE-2 Flash de Cognition: modelo 3 veces más rápido para agentes de código basado en 12 mil millones de parámetros activos👍 12
9 de noviembre · NotaHydrogen 1.0 de Deep Principle: por qué entrenar con fracasos científicos superó a los mejores modelos cerrados👍 7
6 de noviembre · ArtículoClaude y 12 frameworks JS: cuánto cuesta el código de agentes y qué bundle viaja al navegador👍 19
2 de noviembre · ArtículoSparkX 2.6: modelos compactos de 1.7B y 4B para agentes locales y resolución de tareas de código👍 7
31 de octubre · ArtículoEl coste oculto de los frameworks para la IA: por qué los agentes gastan más dinero en Angular que en Hono👍 0
29 de octubre · A fondoKimi K3.1 Pro frente a Claude Opus 5.5: comparativa a fondo de los pesos abiertos contra el líder mundial👍 0+1
27 de octubre · ArtículoLing 3.1 Flash en AutomationBench: el salto de los modelos abiertos en tareas agénticas👍 0
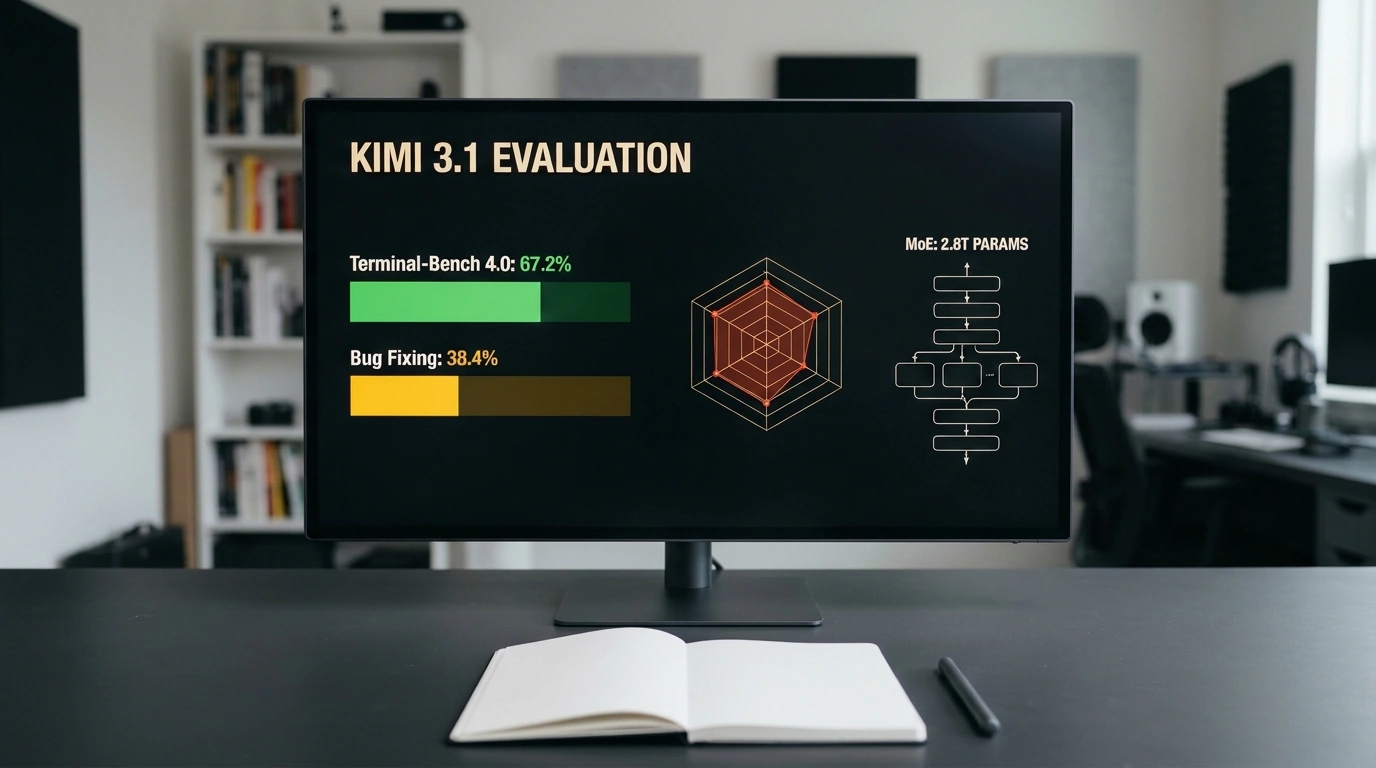
27 de octubre · ArtículoPor qué Kimi 3.1 generó debate: una mirada fría a los benchmarks y cambios arquitectónicos👍 0
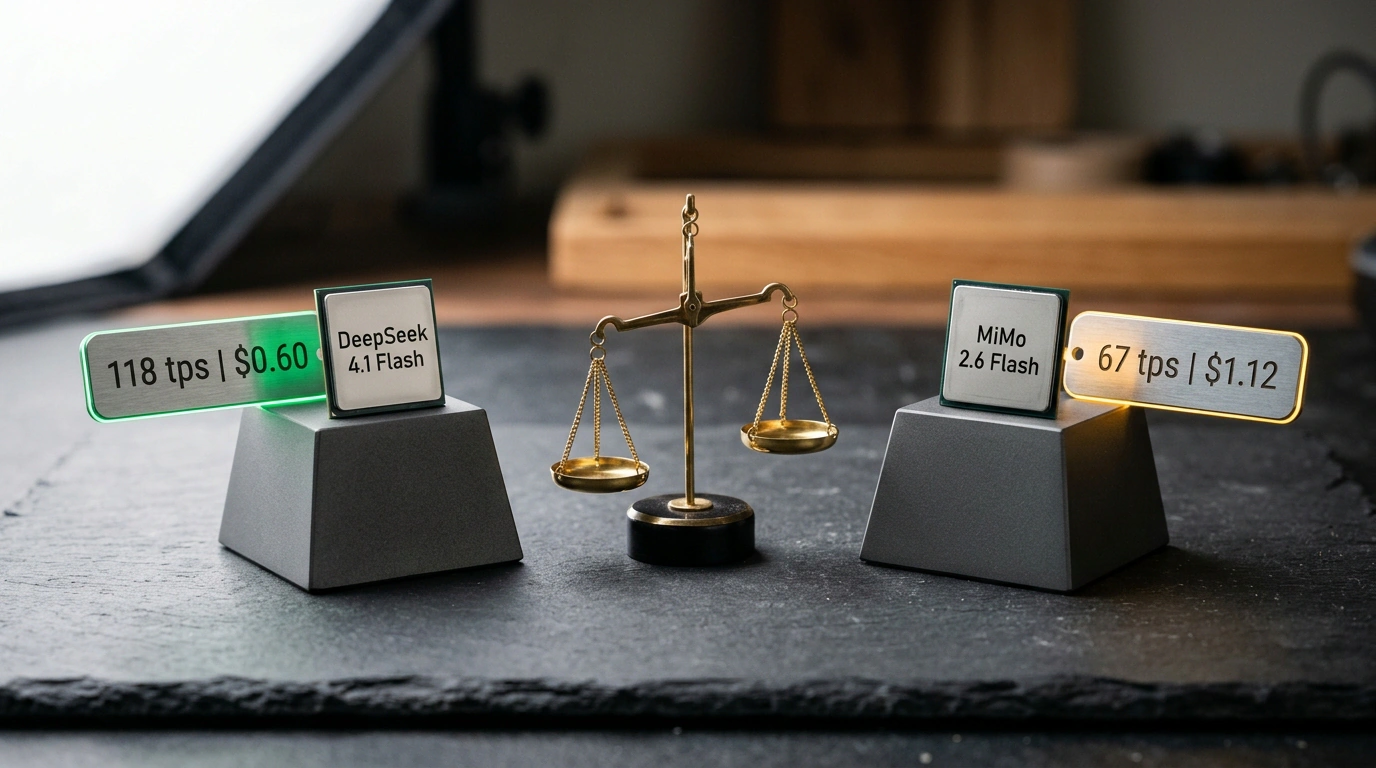
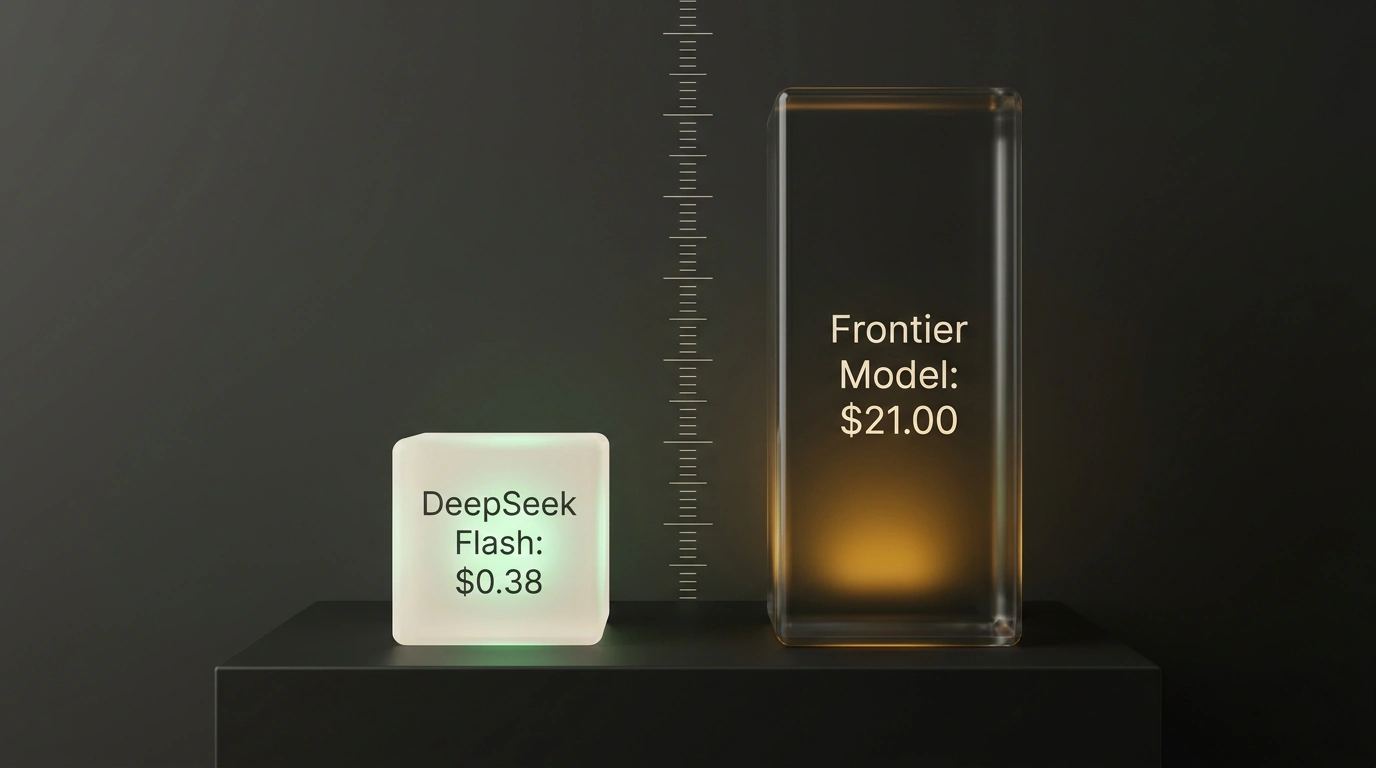
26 de octubre · ArtículoProgramar un servicio web por un dólar: comparamos DeepSeek 4.1 Flash y MiMo 2.6 Flash👍 0
21 de octubre · ArtículoGemini 4 Argon: un millón de tokens de salida, tres modos de pensamiento e integración con Manus👍 0
20 de octubre · BreveActualización de Hermes Index: GPT-6.1 Sol supera a Astra en relación coste-calidad en pruebas de agentes👍 0
19 de octubre · ArtículoDeepSeek V4.1 Flash 1017: creación ultrarrápida de apps y comparativa de costes frente a Claude Opus👍 0

 +1