Hasta hace un par de años, entre los investigadores de inteligencia artificial reinaba un dogma inquebrantable: «La escala lo resuelve todo». Se daba por hecho que resolver tareas complejas de programación, entender contextos multinivel y controlar herramientas de forma autónoma solo estaba al alcance de modelos colosales de entre 70 y 400 mil millones de parámetros. Todo lo que quedara por debajo se relegaba automáticamente a la categoría de autocompletados primitivos para smartphones.
Sin embargo, las redes neuronales gigantes chocaron contra un callejón económico sin salida: las facturas de electricidad se disparan, la inferencia cuesta sumas astronómicas y ejecutar semejante mole en un portátil personal sin conectarse a una nube ajena es imposible por principio. La industria buscaba desesperadamente respuesta a una pregunta: ¿se puede empaquetar verdadera inteligencia de agente en un tamaño compacto?
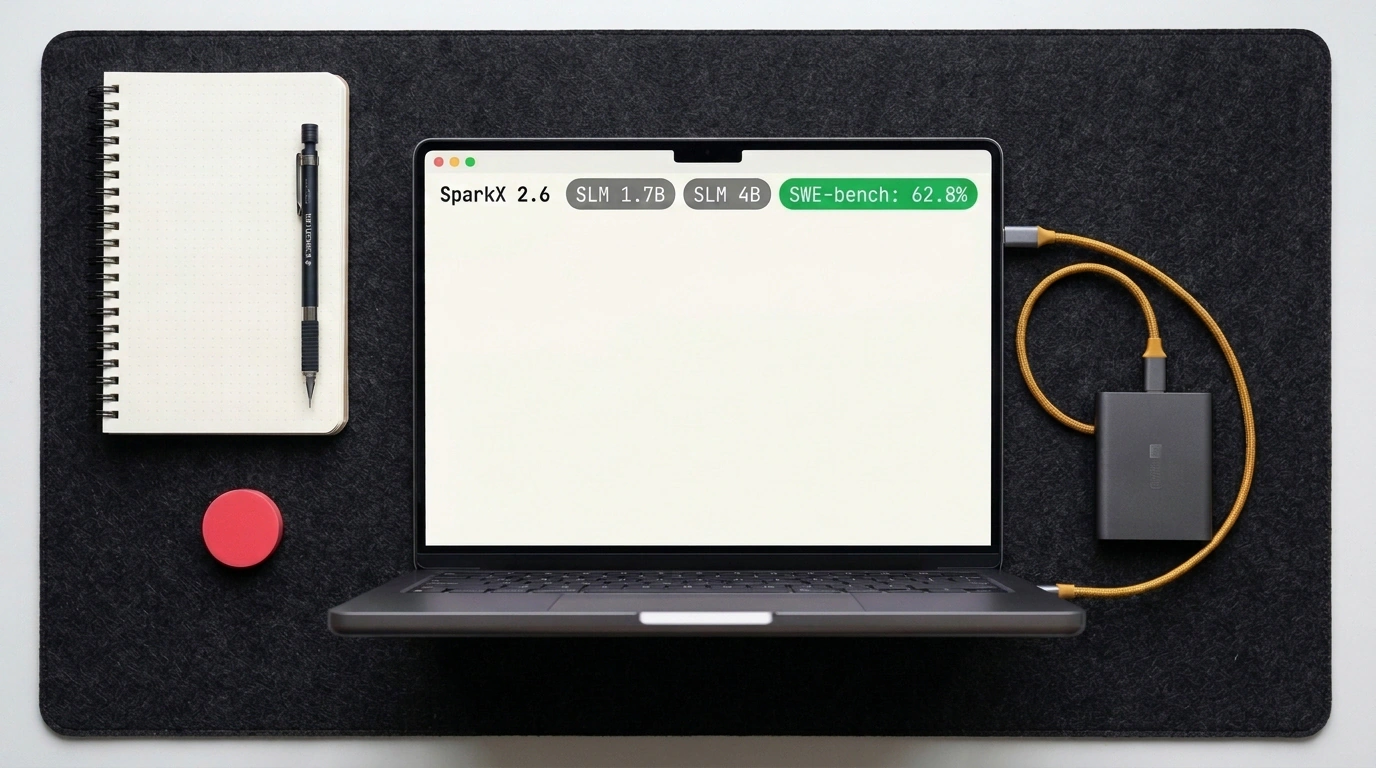
La respuesta a este desafío llegó con el lanzamiento de la familia de modelos compactos (Small Language Models, SLM) SparkX 2.6, del laboratorio XHToken y el equipo SparkLLM. En acceso abierto bajo licencia libre Apache 2.0 en Hugging Face y ModelScope se publicaron dos modelos: de 1.7 mil millones (1.7B) y 4 mil millones (4B) de parámetros. Los resultados en benchmarks hicieron silbar de asombro incluso a los escépticos más curtidos. Analicemos la arquitectura de estos «pequeños», evaluemos sus cifras en SWE-bench y veamos cómo se comportan en hardware de consumo común.
La rebelión de los modelos pequeños: por qué los gigantes ceden terreno a los SLM
El principal problema de los modelos grandes es su monstruosa inercia. Si necesitas lanzar un agente local que permanezca siempre en segundo plano en tu sistema operativo, vigile el portapapeles, ayude a refactorizar código en el IDE y revise erratas, un modelo de 70B devorará toda la RAM y hará rugir los ventiladores del portátil como turbinas de avión despegando.
Los desarrolladores de SparkX 2.6 se fijaron una meta: crear un modelo abierto capaz de razonar no peor que los buques insignia del año pasado, pero que arranque en un ordenador doméstico modesto. El secreto de su eficiencia reside en dos pilares:
- Filtrado de alta calidad del dataset de entrenamiento: el énfasis no se puso en «internet en bruto», sino en cadenas sintéticas de razonamiento lógico estricto, repositorios Git depurados y análisis paso a paso de problemas algorítmicos;
- Presupuesto de razonamiento controlable (Reasoning Budget): el modelo incorpora un mecanismo nativo de cadena de pensamiento (Chain-of-Thought), y el desarrollador puede limitar dinámicamente la cantidad de tokens internos dedicados a pensar, equilibrando la velocidad de respuesta y la profundidad del análisis.
60% en SWE-bench: cómo un pequeño supera a los buques insignia del año pasado
El termómetro principal de madurez para modelos de programación hoy en día es el benchmark SWE-bench Verified. En él, la red neuronal no escribe una función aislada «en el vacío», sino que recibe la descripción real de un fallo (Issue) de un repositorio abierto real en GitHub: debe estudiar código ajeno de múltiples archivos, localizar la causa del error, editar los ficheros necesarios y lograr que todas las pruebas de integración existentes del proyecto pasen con éxito.
Los resultados de SparkX 2.6 dejaron atónitos a los expertos:
- La versión SparkX 2.6 1.7B resolvió con éxito el 59.8% de las tareas reales;
- La versión mayor SparkX 2.6 4B alcanzó la marca del 62.8%.
Para dimensionar este logro, basta recordar que hace apenas año y medio los buques insignia comerciales cerrados como la primera versión de GPT-4 apenas arañaban un 20–25% en esta misma prueba, y entre los modelos abiertos de clase 70B superar la barrera del 40% se consideraba un éxito extraordinario. ¡Un modelo compacto de 4 mil millones de parámetros hoy resuelve bugs en código real mejor que los gigantes del pasado reciente!
El segundo benchmark clave es TAU-bench, que evalúa la capacidad del modelo para actuar como agente de soporte: respetar reglas de la empresa, invocar funciones externas vía API y solicitar correctamente datos faltantes al usuario. Aquí los modelos SparkX 2.6 obtuvieron 85.3% (versión 1.7B) y 86.9% (versión 4B), confirmando una fiabilidad altísima al trabajar con llamadas a herramientas en JSON (Tool Calling). Como ya vimos en el análisis de las capacidades del modelo Spark-X2.6-4B, la capacidad de los modelos pequeños para seguir un formato estricto abre el camino a la autonomía total del software aplicado.
Dieta de hardware: 90 tokens por segundo en un portátil normal
La parte más agradable de esta historia son los requisitos del sistema. Ambos modelos se publicaron en acceso abierto bajo licencia comercial libre Apache 2.0 y ya están convertidos a los formatos populares GGUF, MLX y AWQ:
- SparkX 2.6 1.7B: en cuantización de 4 bits (Q4_K_M), el archivo del modelo ocupa menos de 1.2 gigabytes. Consume apenas alrededor de 1.5 GB de memoria de video y entrega más de 90 tokens por segundo en procesadores Apple Silicon M2/M3 o en tarjetas gráficas económicas del nivel de una Nvidia RTX 3060;
- SparkX 2.6 4B: en 4 bits exige alrededor de 3 gigabytes de memoria de video, entrando holgadamente incluso en el búfer de VRAM de tarjetas gráficas de oficina antiguas.
Literalmente en tres minutos puedes descargar el modelo con Ollama (ollama run sparkx:4b), conectarlo como autocompletado en VS Code mediante la extensión Continue o Cursor y obtener un asistente de programación autónomo completo que funciona sin internet, no envía tu código a servidores ajenos y genera sugerencias al instante.
Límites de aplicabilidad: dónde pasa factura el poco peso
Sin embargo, mantengamos la cabeza fría y entendamos los límites físicos de los modelos compactos. Ninguna magia de destilación puede burlar las leyes de conservación de la información:
- Base factual limitada: En 1.7 mil millones de parámetros es físicamente imposible empaquetar toda la Wikipedia, la historia del mundo antiguo y los matices legislativos de distintos países. Si preguntas a SparkX un dato raro de biología o la biografía de un escritor poco conocido, el modelo o bien admitirá no saberlo, o bien mentirá con total seguridad. El modelo fue diseñado para lógica y sintaxis de código, no para hacer de enciclopedia omnisciente. Cualquier hecho debe entregársele en el contexto mediante RAG (Retrieval-Augmented Generation).
- Dependencia del prompt: A diferencia de los modelos superpesados capaces de leer la mente del usuario a partir de frases confusas y descuidadas, SparkX exige instrucciones claras y sin ambigüedades. Si el contexto de la tarea está formulado con desorden, el modelo puede quedarse dando vueltas en uno de los razonamientos intermedios.
SparkX 2.6 confirma de forma palpable que la era del gigantismo ciego en IA está dando paso a una época de optimización de ingeniería precisa. Para agentes autónomos y programación local ya no hacen falta granjas de servidores: el futuro de la inteligencia artificial local ya cabe sin problemas en el bolsillo de tu chaqueta.