Si sigues la evolución de los grandes modelos de lenguaje, seguro has notado una paradoja: los modelos se vuelven más inteligentes, pero su voracidad crece a un ritmo alarmante. Para alimentar a una red neuronal con un libro extenso o una base de código de un par de cientos de miles de tokens, un servidor necesita terabytes de memoria operativa. La raíz de este callejón sin salida está en el corazón mismo de la arquitectura Transformer: el mecanismo de atención (self-attention). Cuanto más largo es el texto, más cálculos debe realizar el algoritmo en cada palabra, y la complejidad no crece de forma lineal, sino cuadrática.
Por eso el anuncio de la startup Liquid AI, fundada por egresados del laboratorio MIT CSAIL, desató una ola de entusiasmo entre los ingenieros. El 27 de octubre de 2026, el equipo liberó en acceso abierto la tercera generación de la familia Liquid Foundation Models: LFM 3. El buque insignia de la línea de modelos compactos, LFM3-1.7B, ofrece una gigantesca ventana de contexto de 256,000 tokens, pero pesa en cuantización de 4 bits apenas un gigabyte y se ejecuta sin problemas incluso en un microordenador de placa única. Desarmemos pieza por pieza esta inusual arquitectura «líquida» y veamos cómo lograron sus creadores vencer la complejidad cuadrática.
La maldición de la atención cuadrática: el límite de los transformers clásicos
Imaginemos por un segundo cómo lee un texto un transformer clásico. Al encontrarse con cada nueva palabra, se ve obligado a compararla mentalmente con todas las palabras anteriores que ya reposan en su memoria. Si la petición tiene 1,000 palabras, la matriz de relaciones exige un millón de operaciones. Pero si cargas 250,000 palabras, la cantidad de conexiones se dispara hasta la cifra astronómica de 62 mil millones.
Toda esa avalancha de datos intermedios se deposita en un almacén especial de la memoria de video: la caché KV (Key-Value cache). En los transformers convencionales, la caché KV para un contexto largo crece rápidamente hasta cientos de gigabytes, devorando al instante toda la memoria de la GPU. Por eso mismo, ejecutar modelos con contexto de 128K o 256K tokens seguía siendo hasta ahora privilegio de gigantescos clústeres de servidores.
El equipo de Liquid AI apostó por un experimento arquitectónico audaz. En lugar de optimizar por enésima vez el transformer clásico, diseñaron un modelo fundamentalmente distinto, no transformer, apoyado en sistemas dinámicos continuos (Liquid Neural Networks). En estas redes, los parámetros de las neuronas pueden adaptarse con fluidez al flujo de datos entrantes, igual que un líquido que cambia de forma bajo fuerzas externas.
Arquitectura Tri-hybrid: 24 capas con tres tipos de procesamiento
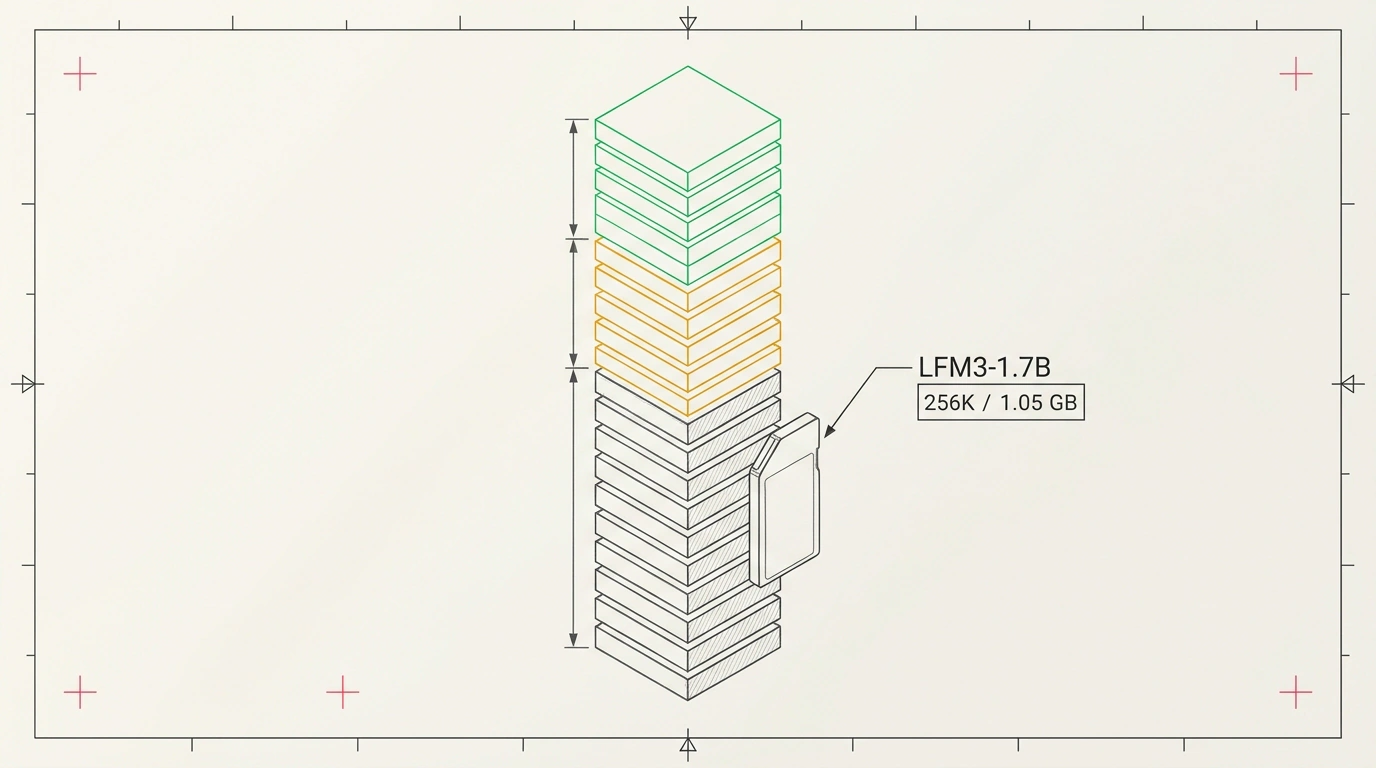
La gran joya de ingeniería de LFM3-1.7B es su estructura interna «trihíbrida» (tri-hybrid). El modelo consta de 24 capas profundas, pero organizadas de maneras completamente distintas:
- 13 capas de convoluciones con compuerta (Gated Convolutions con ventana k=7): Forman la columna vertebral del modelo. A diferencia del mecanismo de atención, las convoluciones tienen una complejidad estrictamente lineal O(N). Se encargan del procesamiento instantáneo de la sintaxis local, el orden de las palabras y las relaciones gramaticales. Una capa convolucional no necesita una caché KV gigantesca y procesa el flujo entrante casi al instante.
- 5 capas de atención local de ventana deslizante (Sliding-window Attention): Estas capas mantienen en el foco de atención el contexto más cercano (unos cientos de tokens vecinos), permitiendo que el modelo enlace con precisión pronombres con sustantivos y conserve el hilo local del razonamiento.
- 6 capas de atención global (Global Attention): Su misión es conectar nodos semánticos distantes del documento a través de intervalos enormes de texto. Pero gracias a que solo hay seis capas globales, la carga total sobre la memoria sigue siendo minúscula.
Este enfoque híbrido permitió reducir el consumo de memoria de la caché KV en un 82% en comparación con transformers puros de tamaño equivalente. El modelo fue entrenado sobre un volumen colosal de 22 billones de tokens (22T), lo que le garantizó una comprensión profunda de los lenguajes naturales y de la sintaxis de programación.
256 mil tokens en el bolsillo: mediciones y ejecución en dispositivos edge
Las cifras frías de las especificaciones dejan una impresión imborrable:
- Ventana de contexto: 256,000 tokens (alcanza para medio centenar de capítulos de «Guerra y paz» completos);
- Cantidad de parámetros: 1.73 mil millones (1.73B);
- Tamaño del archivo en cuantización de 4 bits GGUF (Q4_K_M): apenas 1.05 gigabytes;
- Rendimiento en Apple Silicon: más de 85 tokens por segundo a través de MLX.
Revisé especialmente los resultados de las pruebas sintéticas de extracción de información oculta en un enorme bloque de texto (needle-in-a-haystack en el test LongEval). El modelo LFM3-1.7B mostró una precisión para hallar el dato del 99.1% a lo largo de todo el contexto de 256K. No «olvida» detalles de la mitad del documento, un fallo habitual incluso en sistemas cerrados pesados.
En pruebas lingüísticas generales, el modelo compacto se mantiene al nivel de soluciones sólidas de clase 7B de la generación anterior: MMLU alcanzó el 68.4% y el benchmark matemático GSM8K el 74.2%. El modelo se publicó bajo licencia abierta y recibió de inmediato soporte nativo en los entornos de inferencia populares vLLM, Ollama y llama.cpp. Como ya analizamos en detalle en el repaso de la familia de modelos LFM 3, semejante salto de eficiencia traslada el trabajo con documentos largos desde la nube directamente a los dispositivos personales de los usuarios.
Dónde cambian las reglas del juego las redes neuronales líquidas
Gracias a su peso de un gigabyte, LFM3-1.7B abre la puerta a escenarios que antes parecían ciencia ficción:
- Agentes personales en smartphones y relojes: el modelo puede desplegarse directamente en el teléfono móvil para analizar toda la mensajería personal, notas y recibos sin enviar datos confidenciales a nubes ajenas.
- Sistemas embarcados e IoT: análisis autónomo de telemetría, registros de sensores de maquinaria industrial o drones en microcontroladores Raspberry Pi 5.
- Auditoría local de bases de código: búsqueda rápida de inconsistencias arquitectónicas y vulnerabilidades en repositorios corporativos sin riesgo de filtrar secretos comerciales.
Límites de aplicabilidad: dónde está el truco
Sin embargo, no hay que pensar que un modelo de 1.7 mil millones de parámetros puede sustituir por completo a buques insignia pesados como GPT-6 o Claude Opus. No hay milagros: el tamaño compacto impone limitaciones objetivas.
En primer lugar, el modelo tiene un volumen limitado de conocimiento enciclopédico de fondo. Si necesitas un ensayo histórico detallado o un análisis profundo de un precedente jurídico específico sin aportar el texto fuente, el modelo empezará a confundir fechas y nombres. Es un analista ideal del texto proporcionado, pero un generador modesto de hechos propios.
En segundo lugar, a distancias superiores a 150,000 tokens el modelo pierde ligeramente precisión al ejecutar síntesis complejas multipaso, cuando hace falta no solo encontrar un dato, sino contrastar hipótesis contradictorias de diez capítulos distintos de un informe.
LFM 3 es una señal decisiva para toda la industria: el monopolio de los transformers clásicos está llegando a su fin. Las redes neuronales líquidas demostraron que la capacidad de trabajar con volúmenes colosales de información no depende de cuántos terabytes haya en el rack del servidor, sino de la elegancia de la arquitectura matemática.