Cada anuncio de un nuevo modelo de lenguaje grande en la industria de la IA polariza al instante a la comunidad. Unos comentaristas citan de inmediato los gráficos triunfales de marketing de sus creadores proclamando la victoria sobre el ser humano, mientras otros desentierran un prompt fallido con un acertijo lógico de olimpiada y declaran que estamos ante otra burbuja más.
Exactamente eso ocurrió con el reciente lanzamiento del modelo insignia Kimi 3.1 (Kimi K3.1 Pro) del laboratorio de Shanghái Moonshot AI. En redes sociales se desató una auténtica batalla verbal: parte de los ingenieros criticó el coste relativamente alto por token en inferencia y unos resultados discretos en corrección automática de bugs (bug fixing), mientras otros analistas se deshacían en elogios por la calidad de sus interfaces maquetadas y su comportamiento agéntico en la terminal.
El líder técnico y autor del canal System Design & Highload, Aleksey Rybak, propuso analizar este lanzamiento con cabeza fría, sin emociones ni publicidad. Veamos juntos qué hay realmente bajo el capó de Kimi 3.1, por qué los tests unidimensionales ya no sirven y qué giro tectónico se perfila en los modelos neuronales abiertos.
La trampa de los tests unidimensionales: tres roles en el desarrollo real
El principal error metodológico de la mayoría de pruebas amateurs es intentar medir un modelo complejísimo con una única escala numérica como HumanEval o problemas matemáticos de GSM8k.
En la práctica de ingeniería real, cuando integramos agentes de IA autónomos en el ciclo de desarrollo (AI Software Development Life Cycle), la red neuronal nunca actúa como un algorrista esférico en el vacío. Desempeña roles funcionales radicalmente distintos, y lo que se exige a cada rol es casi opuesto:
- Rol de ingeniero de producto (Product Discovery): aquí el modelo necesita pensamiento analítico, capacidad para desenredar requisitos contradictorios en una especificación, formular casos límite y dividir épicas en historias de usuario verificables.
- Rol de diseñador de interfaces (UI/UX): aquí manda la estética, la comprensión de la rejilla espacial, la adaptabilidad, la tipografía y los sistemas de diseño modernos.
- Rol de ingeniero de sistemas / desarrollador de pipelines: aquí se exige precisión absoluta de sintaxis, integración con APIs REST/gRPC, generación de migraciones de bases de datos, gestión del entorno y escritura de scripts para CI/CD.
Y aquí es donde Kimi 3.1 dio la gran sorpresa. En las votaciones ciegas de usuarios en la arena de diseño (LMSYS Design Arena), Kimi 3.1 se convirtió en el primer modelo asiático abierto cuyas interfaces generadas compiten de tú a tú en las elecciones de los usuarios con las versiones propietarias cerradas de Claude de Anthropic. A diferencia de los benchmarks estándar, donde es posible «entrenar para el examen» (overfitting al dataset), la evaluación a ciegas de diseñadores y maquetadores reales no se puede engañar.
Qué mostraron los benchmarks independientes de Artificial Analysis
Para dejar atrás la subjetividad, veamos las mediciones de la plataforma de investigación Artificial Analysis, que sometió a Kimi K3.1 Pro a baterías estandarizadas de pruebas:
- Índice global de inteligencia (Intelligence Index): el modelo obtuvo 55.1 puntos, situándose con solidez en el 4.º puesto mundial entre más de 200 redes comerciales y abiertas, pisándoles los talones a Claude Opus y Claude Sonnet.
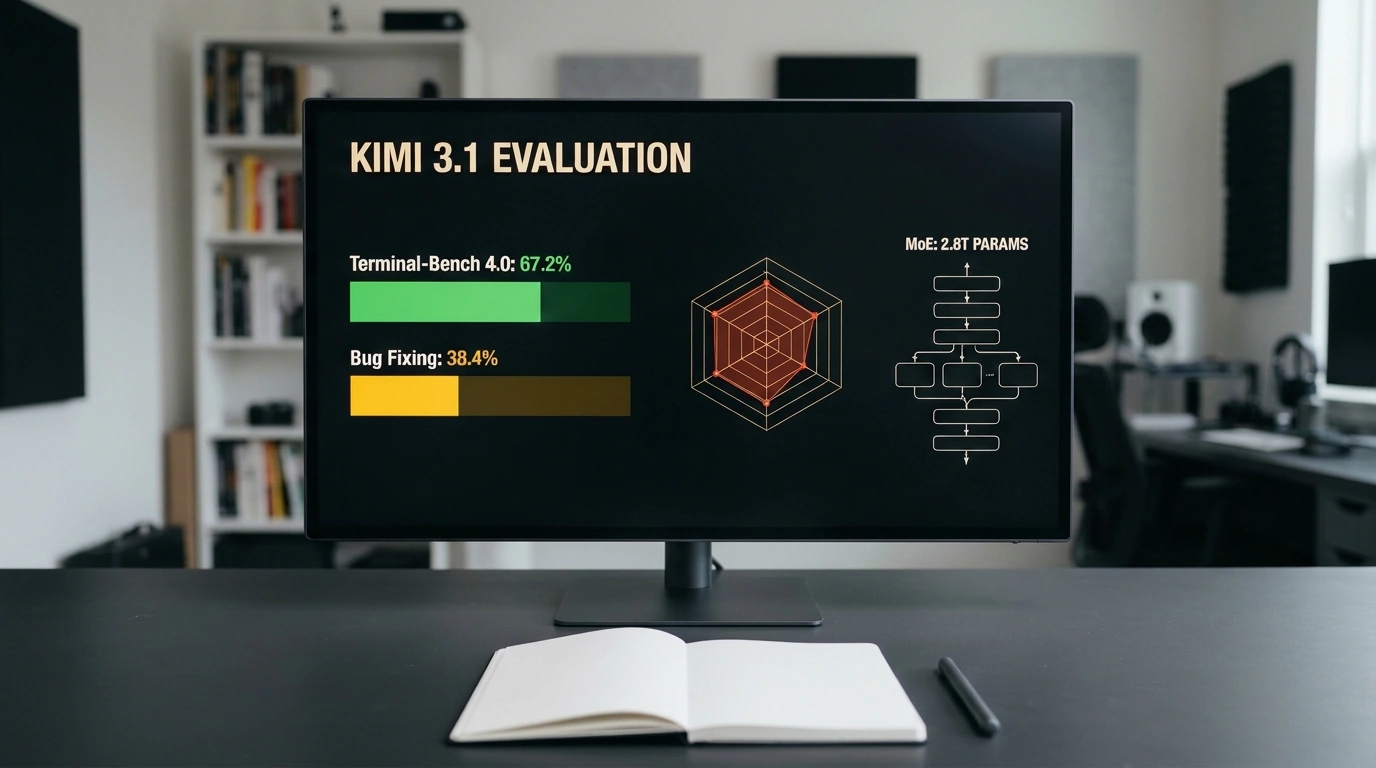
- Trabajo en terminal (Terminal-Bench 4.0): he aquí el gran salto del lanzamiento. En tareas de control real de un sistema operativo por consola, encadenamiento de comandos Bash, despliegue de paquetes y ejecución de tests, Kimi 3.1 alcanzó un récord del 67.2% de éxito. Para comparar: la generación anterior Kimi K3 apenas lograba un 12.6% en esta misma prueba.
- Escenarios largos complejos (AutomationBench y GDPval-AA): en flujos agénticos complejos, el modelo sumó 1846 puntos Elo (una mejora neta de +312 Elo respecto a la versión previa), demostrando gran estabilidad al seguir instrucciones en recorridos largos.
- Olimpiadas académicas: en el test de problemas académicos de altísima dificultad Humanity's Last Exam, el resultado subió de forma más modesta: del 47% al 52%. Precisamente esa evolución moderada decepcionó a quienes esperaban un milagro en matemáticas de olimpiada.
Arquitectura: 2.8 billones de parámetros y 1 millón de contexto
Detrás de estas cifras hay un trabajo arquitectónico de fondo. Kimi K3.1 Pro utiliza un esquema Mixture-of-Experts (MoE) con activación dispersa:
- Volumen total de pesos: unos gigantescos 2.8 billones (trillones en escala corta) de parámetros.
- Parámetros activos por token: 104 mil millones de parámetros. Esto le da al modelo una erudición enorme sin frenar de forma desmedida la generación de cada token individual.
- Ventana de contexto: 1 000 000 de tokens con recuperación densa y fiable de datos sin «ceguera en el medio» (efecto Needle in a Haystack).
Pero la noticia principal es su política de distribución. Moonshot anunció su intención de abrir los pesos del modelo para la comunidad. Esto convierte a Kimi 3.1 en el modelo abierto más potente del planeta. Si te interesa seguir la evolución de esta familia de modelos, echa un vistazo a nuestro anterior análisis detallado de Kimi K3 y sus matices arquitectónicos.
El gran giro tectónico: se cierra la brecha
Aleksey Rybak señala con acierto una tendencia global del mercado: la distancia entre los gigantes tecnológicos estadounidenses cerrados y los laboratorios internacionales que venían detrás se está cerrando a toda velocidad.
Estamos viendo la clásica espiral del software abierto:
- Primero aparece un monopolista cerrado y caro con suscripción mensual.
- Luego los modelos abiertos igualan la calidad base, reduciendo la brecha al margen de error estadístico.
- En el tercer paso se optimizan los métodos de cuantización y las empresas pueden desplegar pesos de calidad comparable en sus propios servidores y estaciones de trabajo (on-premise), resolviendo de raíz la seguridad de los datos y los riesgos de sanciones.
Kimi 3.1 es la prueba palpable de que la era del monopolio de dos o tres proveedores cerrados en el desarrollo corporativo está llegando definitivamente a su fin.