Imagina la escena: tienes una red global de miles de servidores por la que pasan decenas de millones de peticiones HTTP cada segundo. La memoria en los nodos literalmente arde: los demonios de caché llenan la RAM hasta el tope, y la monitorización muestra que una parte enorme de esa memoria ni siquiera se va en páginas de usuarios o archivos multimedia, sino en las propias estructuras de datos internas del enrutamiento. La primera reacción de muchos equipos sería ir a dirección, pedir presupuesto y comprar más módulos de RAM. Pero los ingenieros de Cloudflare tomaron otro camino: echaron mano de la teoría de probabilidades, abrieron el código fuente de su proxy Pingora escrito en Rust y ahorraron 100 terabytes de memoria RAM sin gastar un solo céntimo en hardware.
Lo que más me enganchó de esta historia es cómo un buen razonamiento matemático combinado con el compilador de Rust puede darle la vuelta a la arquitectura de una producción gigante. Vamos a desarmar esta mecánica pieza por pieza.
Dónde se escondían cientos de terabytes: el servicio PBR y el anillo Ketama
Para entender el fondo del problema, hay que asomarse a la arquitectura de caché de Cloudflare. Cuando una petición llega a un servidor perimetral, el sistema necesita asegurarse de que una misma URL dentro del centro de datos siempre sea atendida por el mismo nodo interno. Es una regla básica: si cinco peticiones idénticas aterrizan en cinco máquinas distintas, acabamos con cinco duplicados en memoria y cinco veces más carga sobre el servidor de origen (origin).
El encargado de elegir el servidor concreto es el servicio Pingora Backend Router (PBR), un proxy en Rust que sustituyó al veterano NGINX. Para mantener un direccionamiento estable dentro de PBR, se utiliza la librería pingora-ketama, que implementa el algoritmo de hashing consistente (consistent hashing).
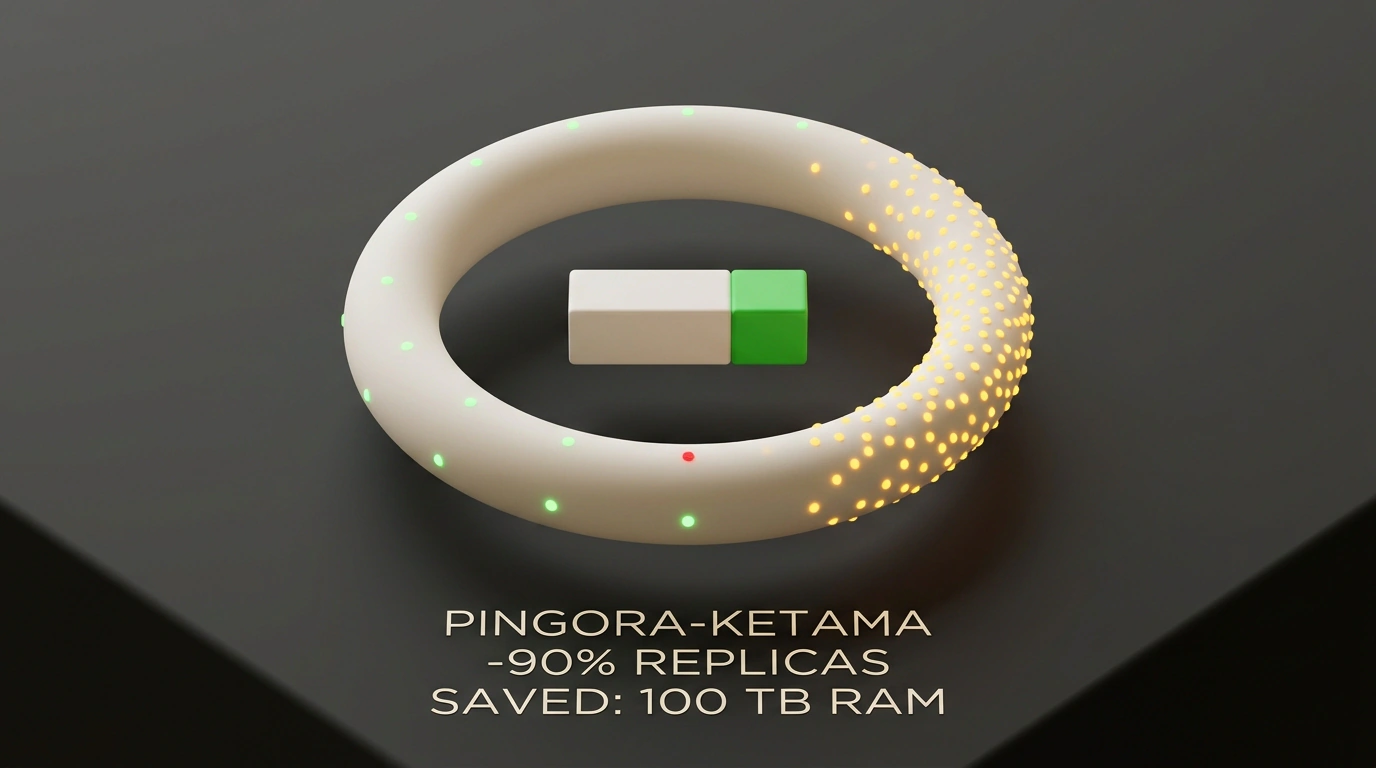
La idea de Ketama es sencilla: imagina un anillo cerrado de hashes que va de 0 a 2^32 - 1. Los servidores físicos del clúster se hashean por nombre o dirección IP y ocupan puntos concretos en ese anillo. Cada petición también se hashea según su clave de caché, cae en un punto de la circunferencia y se dirige al servidor más cercano siguiendo el sentido de las agujas del reloj.
El esquema es todo un clásico, pero durante una auditoría de rendimiento el ingeniero Ivan Babrou detectó una cifra alarmante: ¡las estructuras de pingora-ketama dentro de PBR consumían hasta 6 GB de RAM en algunos nodos! A escala de miles de servidores, eso se traducía en cientos de terabytes de memoria pura dedicados únicamente a los anillos de enrutamiento.
La paradoja de los nodos virtuales y la meseta de eficiencia
¿Por qué ocupa tanta memoria un anillo de hashing? Todo se debe a la distribución aleatoria. Si colocas 100 servidores en el anillo con un solo punto por nodo, las matemáticas te dan una sorpresa desagradable: para 100 servidores, el coeficiente de variación de la longitud de los segmentos supera el 98%. Un servidor se ahoga recibiendo el doble de tráfico mientras el vecino se queda de brazos cruzados.
La receta histórica para resolverlo son los nodos virtuales (réplicas de hash). A cada servidor físico se le asignan decenas de etiquetas pseudoaleatorias repartidas por el anillo. En NGINX y en las primeras versiones de Pingora, el valor base era de 160 réplicas. Y al tener en cuenta distintas capacidades de disco, el número de puntos de hash por máquina superaba las decenas de miles.
Los ingenieros de Cloudflare graficaron el error de balanceo en función del número de nodos virtuales y se toparon con la ley de los rendimientos decrecientes:
- Los primeros cientos de hashes bajan el error de distribución de un catastrófico 99% a un 5–8%.
- Pero a partir de ahí empieza una meseta: el tramo de 10 000 a 100 000 hashes (¡noventa mil puntos!) apenas reduce la desigualdad en un 0.7%.
- Además, en un espacio de hashes de 32 bits con clústeres grandes entraba en juego la paradoja del cumpleaños: los hashes de los nodos virtuales colisionaban entre sí, desplazándose del anillo e introduciendo ruido.
Durante años, producción estuvo pagando millones de gigabytes de memoria por una fracción minúscula de mejora en el balanceo. El equipo decidió recortar en un 90% el número de hashes generados (dividirlo por 10). La carga real de los backends ni se inmutó, pero el volumen de las estructuras de datos en RAM cayó en picado un orden de magnitud.
Cómo alinea Rust la memoria y dónde se perdía un 25%
Después, los investigadores examinaron la representación binaria de los datos en memoria. En la implementación original del crate pingora-ketama, cada punto del anillo se definía con esta estructura:
struct Point {
    hash: u32,
    index: u32,
}
El campo hash ocupa 4 bytes (la posición en el anillo) y index es el índice del servidor en el array de backends (otros 4 bytes). El ingeniero Zaidoon Abd Al Hadi reparó en un detalle obvio: ningún centro de datos de Cloudflare tiene más de 65 536 servidores. Para el índice bastaba un entero de 16 bits, u16.
Sin embargo, cambiar el tipo directamente a u16 en Rust no ahorra nada: el compilador alinea los campos al límite del tipo más grande (4 bytes para u32) e inserta implícitamente 2 bytes de relleno (padding). La estructura seguía ocupando exactamente 8 bytes.
Usar la directiva #[repr(packed)] aquí es peligroso: el acceso desalineado a memoria en los servidores puede degradar la velocidad de lectura. Así que los ingenieros empaquetaron el punto en un array compacto de bytes crudos con métodos inline:
struct Point([u8; 6]);

impl Point {
    #[inline]
    fn hash(&self) -> u32 {
        u32::from_ne_bytes(self.0[0..4].try_into().unwrap())
    }

    #[inline]
    fn index(&self) -> u16 {
        u16::from_ne_bytes(self.0[4..6].try_into().unwrap())
    }
}
Esta jugada comprimió limpiamente el tamaño de la estructura a exactamente 6 bytes, logrando otro 25% adicional de ahorro de memoria sin perder velocidad en la búsqueda binaria.
Migración canario sin picos de carga hacia el origin
Si cambias el algoritmo de hashing de golpe en toda la flota de máquinas, todos los puntos del anillo se desplazan. Las peticiones empiezan a llegar a servidores distintos que no tienen esas páginas en caché. Se produce una invalidación masiva (cache churn), millones de peticiones atraviesan la protección a la vez y golpean directamente los backends de los clientes (cache stampede).
El equipo desplegó una cuidadosa migración canario:
- PBR mantuvo simultáneamente en memoria los anillos antiguos
v1y los nuevos anillos compactosv2. - La elección de la versión del anillo se hacía de forma determinista a partir del hash de la petición, evitando que rebotara entre servidores.
- Los cambios se activaron primero en puntos de prueba aislados, luego en pequeños centros de datos regionales y, finalmente, a escala global.
- En todo momento se monitorizaron en tiempo real las latencias de respuesta, el tráfico hacia el origin y el consumo de memoria de los procesos (RSS).
Tras migrar todo el tráfico a los anillos v2, las viejas estructuras v1 se descargaron de la memoria. El resultado final: más de 100 terabytes de RAM liberados en todo el mundo. Si te interesan este tipo de casos de optimización de infraestructura, échale un vistazo también a nuestro artículo sobre la optimización del arranque UEFI en servidores bare-metal de Cloudflare.
No corras a escalar la infraestructura «a lo ancho» cuando crezca el apetito de un servicio. Hacer profiling de las estructuras de datos en memoria y aplicar teoría de probabilidades básica suele destapar reservas de rendimiento de cientos de terabytes justo donde todo el mundo daba por buenos los valores por defecto de las librerías.