Seguro que has escrito tests unitarios en Go más de una vez: montas una tabla []struct{ input, expected }, listas cinco entradas obvias, compruebas los ceros límite, una cadena vacía y cierras la tarea tranquilo. En CI todo sale en verde y el revisor aprueba el PR. Y una semana después, en producción, el parser de protocolo de red o de configuraciones JSON suelta de repente un panic: runtime error: index out of range ante una petición torcida de un cliente con un carácter UTF-8 exótico.
¿Por qué ocurre esto? El cerebro humano tiene sesgo: instintivamente probamos el código con los datos que consideramos «razonables». Pero el mundo real fuera de nuestros tests está lleno de ruido, paquetes corruptos y cargas maliciosas.
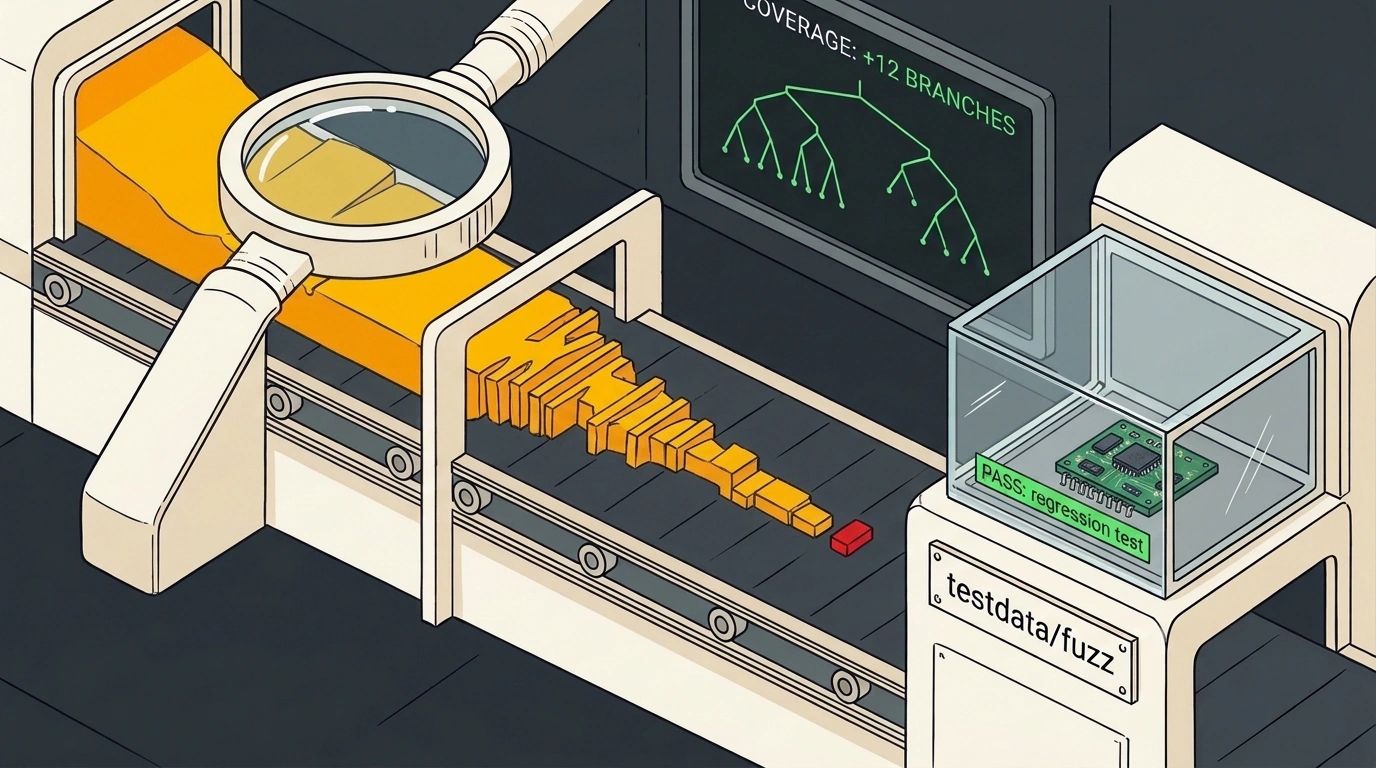
Aquí es donde entra en escena el mecanismo integrado Go Fuzzing, presente en la librería estándar testing desde Go 1.18. No es un simple generador de números aleatorios, sino fuzzing guiado por cobertura (coverage-guided fuzzing). El motor analiza el grafo de ramificación de tu código compilado y muta bytes de forma dirigida para colarse en las ramas más recónditas de tus if, switch y bucles, allí donde jamás habrías pensado probar a mano.
Veamos cómo escribir un buen fuzz test, qué pasa cuando el fuzzer encuentra un pánico y cómo guardar ese artefacto en el repositorio para que el bug no vuelva a aparecer nunca más.
Cómo se estructura un fuzz test: firma f.Fuzz y corpus inicial
Un fuzz test en Go se escribe en los mismos archivos *_test.go de siempre, pero en lugar del objeto estándar *testing.T, la función recibe el parámetro *testing.F:
package parser_test

import (
    "bytes"
    "testing"
    "myproject/parser"
)

func FuzzParseMessage(f *testing.F) {
    // 1. Llenamos el corpus semilla inicial con ejemplos válidos
    f.Add([]byte("HEADER:OK\nBODY:hello\n"))
    f.Add([]byte("HEADER:PING\nBODY:\n"))

    // 2. Declaramos el objetivo del fuzzing
    f.Fuzz(func(t *testing.T, data []byte) {
        msg, err := parser.Parse(data)
        if err != nil {
            // ¡Un error de validación es el comportamiento normal del parser!
            return
        }

        // 3. Comprobamos invariantes: si el parser tuvo éxito, el contrato debe cumplirse
        if len(msg.Header) == 0 {
            t.Fatalf("el parseo exitoso devolvió una cabecera vacía para la entrada: %q", data)
        }

        // Invariante de reversibilidad (round-trip test)
        serialized := msg.Bytes()
        if !bytes.Equal(serialized, data) {
            t.Errorf("invariante de reversibilidad roto: %q != %q", serialized, data)
        }
    })
}
Aquí hay tres reglas fundamentales:
- El método
f.Addconstruye el corpus semilla (seed corpus): el fuzzer no empieza a mutar a ciegas desde cero. Toma tus ejemplos válidos conocidos y empieza a alterar bytes sueltos, invertir bits, borrar subcadenas e insertar caracteres especiales. - Los errores de validación son normales: si tu función devuelve
err != nil, el test no debe fallar. Ese error indica que el parser rechazó correctamente datos basura. El fuzzer no busca errores esperados, sino pánicos inesperados, bucles infinitos o rupturas de invariantes lógicos del negocio. - Comprobación de invariantes: lo ideal es hacer fuzzing sobre propiedades que siempre deben cumplirse (invariantes). Por ejemplo: «el tamaño del búfer descomprimido no supera el límite», «tras serializar y deserializar el objeto es idéntico al original» o «la función no entra en pánico ante ninguna secuencia de bytes». Si sueles comparar estructuras de datos complejas en tests de Go, échale un vistazo a nuestro análisis de la librería go-cmp para encontrar el diff exacto entre objetos.
Dos modos de ejecución: corrida normal frente al mutador
Muchos desarrolladores no saben que ejecutar:
go test ./...
¡no arranca en absoluto el generador activo de mutaciones!
En modo normal, go test trata la función FuzzParseMessage simplemente como un test unitario parametrizado. Ejecuta en orden únicamente los valores que hayas añadido con f.Add, más los archivos guardados previamente en el directorio testdata/fuzz. Esta pasada tarda fracciones de segundo y es totalmente segura para los pipelines habituales de CI/CD.
Para encender el motor real de fuzzing, hay que pasar explícitamente el flag -fuzz:
# Ejecutar fuzzing activo sobre un test concreto con un límite de 30 segundos
go test -fuzz=FuzzParseMessage -fuzztime=30s -v
Cuando lanzas este comando, el runtime de Go hace lo siguiente:
- Recopila el perfil base de cobertura de código (baseline coverage) usando los ejemplos del seed corpus.
- Lanza workers en paralelo aprovechando todos los núcleos disponibles del procesador.
- Empieza a generar millones de mutaciones por segundo. Cada vez que una mutación descubre un camino nuevo en el código compilado (una nueva rama
if), ese vector de entrada se añade a la caché temporal de cobertura para seguir descomponiéndolo.
Anatomía de un fallo: la magia de la minimización automática
Imagina que el fuzzer lleva 15 minutos rodando, ha generado un array de entrada de 8192 bytes aleatorios y, con ese array, el parser por fin revienta con un pánico:
--- FAIL: FuzzParseMessage (12.45s)
    --- FAIL: FuzzParseMessage (0.00s)
        panic: runtime error: slice bounds out of range [:12] with capacity 8
Si la herramienta se limitara a escupirte un archivo de 8 kilobytes de basura, te pasarías la noche entera descifrando el volcado. Pero el motor de Go Fuzzing hace algo fantástico: activa de inmediato el algoritmo de minimización de entrada (input minimization).
El fuzzer empieza a recortar trozos de bytes, bit a bit, y a relanzar el código sin parar comprobando si se reproduce exactamente el mismo pánico. Si al eliminar los primeros 4000 bytes el fallo persiste, los descarta para siempre. El proceso continúa hasta quedarse con el conjunto mínimo posible de bytes capaz de provocar la caída. Como resultado, un array de 8 KB se reduce literalmente a tres bytes: ÿ\n!
Tras minimizar la entrada, Go:
- Finaliza el comando con código de salida
1. - Imprime en consola la traza exacta de la pila y el valor de los argumentos que fallaron.
- Guarda automáticamente este escenario mínimo de fallo en disco dentro del archivo:
testdata/fuzz/FuzzParseMessage/c7a8b9f123...
Convertir el fallo en un test de regresión: hacemos commit de testdata/fuzz
Asomémonos al interior del archivo generado en el directorio testdata/fuzz/FuzzParseMessage/:
go test fuzz v1
[]byte(" ÿ\n")
El formato del archivo es totalmente transparente: la primera línea indica la versión del esquema (go test fuzz v1) y debajo van los argumentos tipados que provocaron el fallo.
Y aquí reside la mayor elegancia arquitectónica del enfoque de Go: ¡este archivo está pensado para hacerle commit en el sistema de control de versiones (git)!
# Añadimos a git el caso límite descubierto
git add testdata/fuzz/FuzzParseMessage/
git commit -m "test: reproduce boundary panic in message parser via fuzz corpus"
A partir de ese momento, el archivo pasa a formar parte de tu suite permanente de tests de regresión. Cuando cualquier compañero del equipo o el runner de GitHub Actions ejecute el go test ./... rápido de siempre, el fuzz test recogerá automáticamente ese archivo de testdata, lo pasará a la función objetivo y garantizará que el bug corregido jamás vuelva a colarse sin ser detectado.
Corregimos el error en el parser (añadiendo la comprobación de longitud del slice antes de hacer el corte) y verificamos la solución:
# Verificamos que el test ahora pasa correctamente con la entrada fallida guardada
go test -run=FuzzParseMessage -v
No lances fuzzing infinito dentro del pipeline principal que bloquea los pull requests. Ejecuta el rápido go test ./... de regresión en cada commit (comprueba al instante el corpus acumulado en testdata) y lleva el fuzzing profundo go test -fuzz=. -fuzztime=10m a un job nocturno programado con cron.