Entre quienes empiezan en desarrollo circula un mito muy arraigado: si la base de datos va lenta, basta con crear un índice para cada columna del WHERE y todo volará por arte de magia.
A menudo me encuentro proyectos con tablas de 15 columnas que llevan colgados 10 o 12 índices distintos. Por fuera todo pinta genial: el SELECT encuentra la fila en fracciones de milisegundo. Pero en producción el sistema empieza a ahogarse, los discos se saturan de operaciones de E/S, las transacciones acumulan latencia y la replicación se retrasa decenas de segundos.
¿Dónde está el truco? Los índices no aceleran la base de datos en términos absolutos. Un índice es una estructura auxiliar que acelera las lecturas a cambio de un impuesto garantizado sobre cada operación de escritura (INSERT, UPDATE, DELETE).
Anatomía de un B-Tree: qué hay dentro de las páginas de 8 kilobytes
En los motores relacionales (PostgreSQL, MySQL/InnoDB), el estándar es el árbol balanceado B-Tree en la documentación de PostgreSQL, implementado según el algoritmo de Lehman & Yao.
El árbol se guarda en disco en páginas de memoria fijas de 8 kilobytes cada una. Su estructura consta de tres capas:
- Nodo raíz (Root page): el punto de entrada para cualquier búsqueda.
- Nodos intermedios (Internal pages): enrutadores con claves separadoras y punteros hacia las páginas del siguiente nivel.
- Nodos hoja (Leaf pages): el nivel inferior, donde se almacenan los pares ordenados
valor_clavey el identificador de tuplaTID(Tuple ID: número de página de la tabla y desplazamiento de la fila). Todas las páginas hoja están enlazadas en una lista doblemente enlazada, lo que permite recorrer rangos (BETWEEN,>,<) a toda velocidad.
Buscar una fila en un B-Tree tiene complejidad O(log n): en vez de escanear toda la tabla secuencialmente, el optimizador lee apenas 3 o 4 páginas del árbol.
Qué ocurre bajo el capó en un INSERT: divisiones de página y avalancha de WAL
Ahora imagina una tabla con 8 índices creados. Cuando la aplicación lanza un simple INSERT:
- El motor escribe la fila en la tabla.
- Acto seguido, la base está obligada a descender desde la raíz hasta la hoja en los 8 índices uno tras otro.
- En cada índice se adquiere un bloqueo exclusivo (exclusive lock) y el valor se inserta manteniendo el orden.
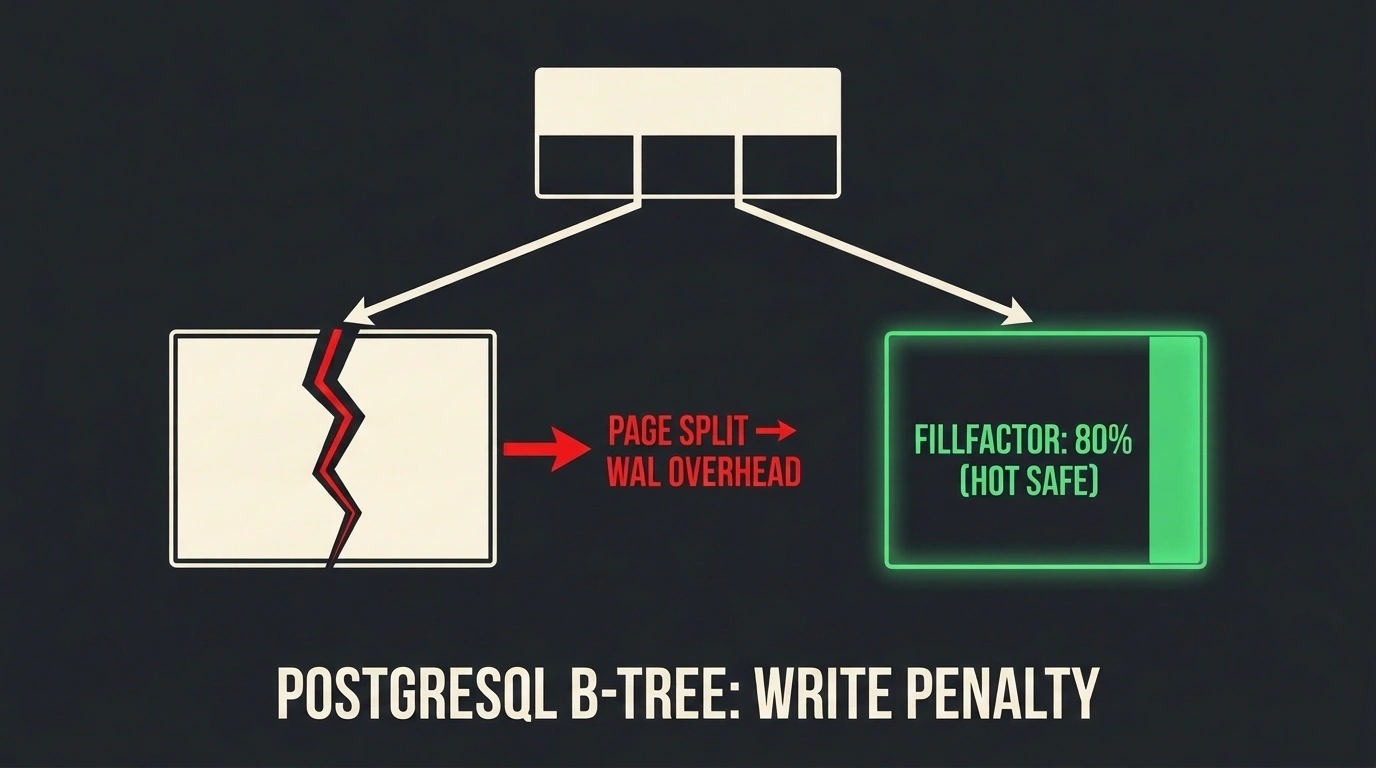
Y aquí llega lo más desagradable: la división de página (Page Split). Un bloque hoja del B-Tree tiene un tamaño fijo de 8 KB. Si se agota el espacio libre, el motor tiene que asignar una página nueva, mover allí la mitad de los registros (aproximadamente el 50%), reescribir los punteros de las páginas vecinas e insertar la nueva clave en el nodo padre. Si la página padre también está llena, ¡la división se propaga en cascada hacia arriba hasta llegar a la raíz!
Cada división de página genera una avalancha de registros en el Write-Ahead Log (WAL). En lugar de una pequeña fila, la base vuelca a disco megabytes de páginas internas. El subsistema de disco se colapsa y las réplicas empiezan a quedarse atrás respecto al primario.
Cómo reducir el coste de escritura: la magia de HOT y fillfactor
Para no pagar los índices con una degradación de las escrituras, se aplican técnicas de arquitectura bien probadas:
- Heap-Only Tuples (optimización HOT en PostgreSQL): si un
UPDATEmodifica columnas que no forman parte de ningún índice y hay espacio libre en la página actual de la tabla, ¡PostgreSQL ni siquiera toca los índices! La nueva versión de la fila se guarda en la misma página de la tabla y se enlaza mediante una cadena interna. La sobrecarga sobre los índices pasa a ser cero. - Ajuste del parámetro
fillfactor: por defecto, PostgreSQL rellena las páginas de la tabla al 100%. Por culpa de eso, ante cualquierUPDATEla nueva versión de la fila no cabe en la página y la cadena HOT se rompe. Si en tablas muy actualizadas bajas el factor de llenado del 100% al 80% (ALTER TABLE orders SET (fillfactor = 80)), el motor reserva un 20% de espacio libre en cada página y la proporción de actualizaciones HOT rápidas sube por encima del 95%. - Índices parciales (Partial Indexes): en lugar de indexar toda la tabla, crea el índice solo para las filas activas (
WHERE status = pending). Esto reduce el tamaño del árbol varias veces y elimina por completo el impuesto de escritura al trabajar con datos históricos.
Los índices son como un préstamo financiero: ganas microsegundos al leer, pero firmas el compromiso de pagar intereses en E/S de disco en cada escritura. Si quieres pulir aún más tu criterio con las consultas, revisa nuestro artículo 10 reglas para un SQL rápido: índices, selectividad y lectura de planes de ejecución.