Seguro que más de una vez miraste con escepticismo la enésima tabla triunfalista de pruebas de IA. En las notas de prensa los desarrolladores presumen de un 90% de aciertos en MMLU o GSM8k, pero luego pones el modelo frente a una tarea real de oficina y tropieza en el tercer paso, confunde las columnas de una tabla o se inventa argumentos de una API. A mí esa desconexión entre las cifras académicas y la práctica siempre me ha exasperado. Por eso los nuevos resultados del modelo abierto Ling 3.1 Flash en el benchmark especializado AutomationBench causaron tanto revuelo en la comunidad técnica.
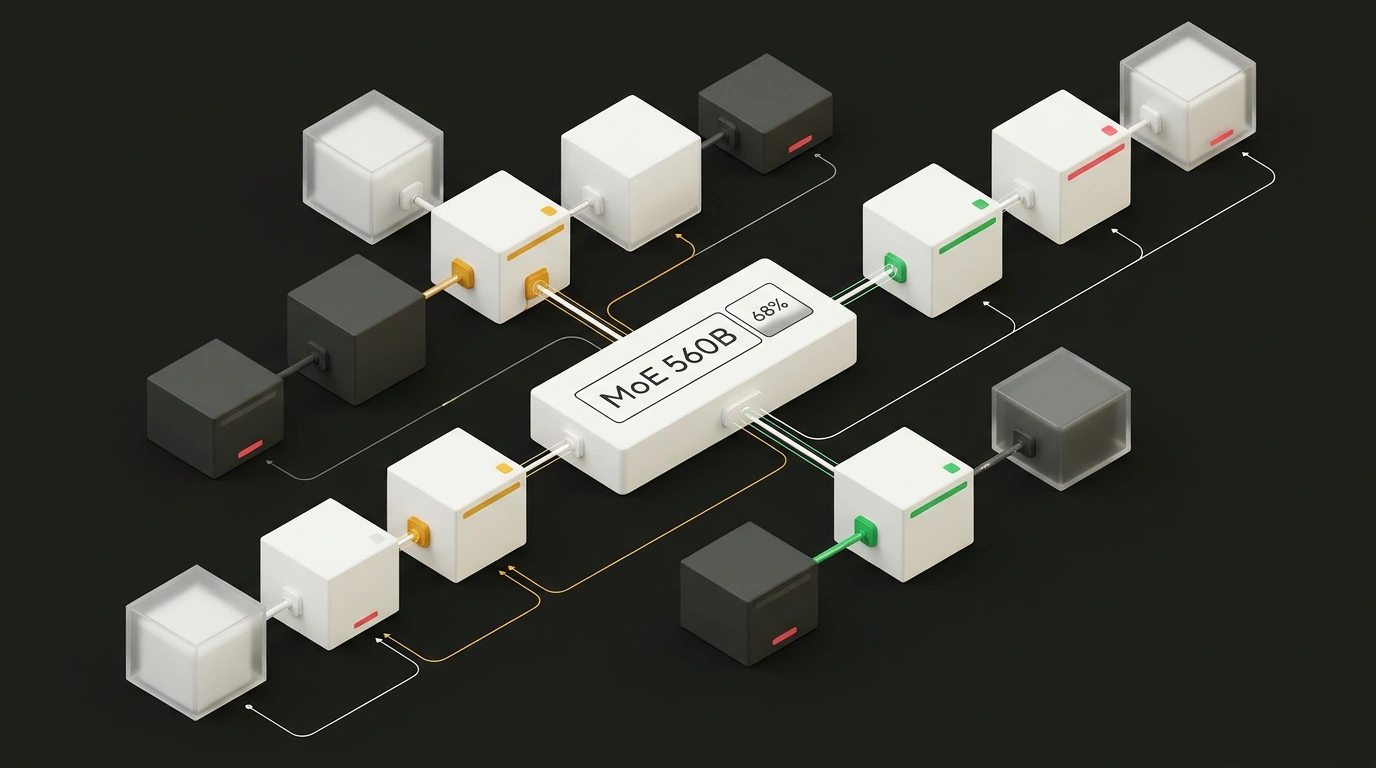
Una actualización menor del checkpoint número 1019 elevó la tasa de éxito del modelo en 6 puntos porcentuales de golpe, pasando del 62% al 68%. A primera vista parecen seis puntos cualquiera, pero en la automatización compleja de múltiples pasos esto supone un giro tectónico: un modelo abierto con arquitectura Mixture-of-Experts (MoE) se ha puesto casi a la altura de los gigantes propietarios pesados, ejecutando tareas con latencia de fracciones de segundo y a una fracción del coste de inferencia.
Qué es AutomationBench: por qué las pruebas sintéticas mienten sobre los agentes
Para entender el peso de este avance, veamos cómo está construido AutomationBench. Lo creó el equipo de ingeniería de Zapier, la plataforma por la que pasan a diario millones de integraciones entre miles de aplicaciones en la nube. A diferencia de los exámenes escolares de opción múltiple, AutomationBench simula el trabajo real y «sucio» de un empleado en seis áreas corporativas clave: ventas, marketing, operaciones diarias, soporte al cliente, finanzas y recursos humanos.
Aquí no hay preguntas abstractas. Al modelo se le entrega un escenario de producción completo:
- recoger los leads entrantes desde un formulario web;
- validar el formato de teléfonos y correos electrónicos;
- comprobar en el CRM mediante API REST si existen duplicados;
- calcular un descuento según una matriz compleja de reglas;
- generar una factura de cobro en el sistema contable;
- enviar una notificación estructurada al chat del equipo.
La gran trampa de estas tareas es la propagación catastrófica de errores (error propagation). Si el modelo falla en la sintaxis de un JSON o se salta un parámetro obligatorio en el segundo paso, toda la cadena de veinte acciones se viene abajo. Históricamente, solo unos pocos pesos pesados cerrados como Claude 3.5 Sonnet o GPT-4o lograban llevar estos flujos hasta el final con estabilidad. Ling 3.1 Flash demostró que el software abierto ya sabe mantener la atención durante todo el recorrido.
Arquitectura MoE 560B: cómo 25 mil millones de parámetros activos sostienen la cadena
Detrás de la familia Ling está el laboratorio de investigación InclusionAI (perteneciente a Ant Group). A nivel arquitectónico, Ling 3.1 Flash es un modelo Mixture-of-Experts monumental con un conjunto total de 560 mil millones de parámetros. Pero que esa cifra colosal no te asuste: en cada instante concreto, al procesar un token, solo se activan exactamente 25 mil millones de parámetros («expertos activos»).
Este diseño combina lo mejor de dos mundos:
- Erudición y profundidad: la memoria acumulada de 560B parámetros almacena un volumen enorme de conocimiento sobre estructuras de API, estándares de datos y lógica de programación.
- Inferencia ultrarrápida: físicamente, las tarjetas gráficas solo multiplican matrices para 25B parámetros. Eso garantiza una latencia mínima al generar la respuesta, comparable a la de modelos compactos.
Si a esto sumamos una ventana de contexto de 1 millón de tokens y optimización de hardware (como ya vimos en el análisis de la versión temprana de Ling 3.1 Flash), el modelo lee al instante esquemas OpenAPI y especificaciones de herramientas. No pierde el hilo al pasar el contexto entre pasos —siguiendo la tendencia hacia modelos abiertos rápidos para agentes— y conecta con precisión las variables de entrada con los argumentos de cada función objetivo.
El fenómeno del razonamiento excesivo: el precio oculto de la precisión
Sin embargo, no todo es perfecto y conviene conocer la letra pequeña. Al revisar a fondo los registros de inferencia de la versión 1019, salió a la luz un efecto secundario curioso del ajuste fino para tareas agénticas: el modelo peca de una notable verbosidad.
Antes de emitir el comando compacto final para llamar a una herramienta API, Ling 3.1 Flash dispara una larga cadena de razonamiento interno (Chain-of-Thought). Se repite a sí mismo paso a paso cada detalle intermedio: «Primero comprobaré el formato del correo... luego lo compararé con la expresión regular... después consultaré el endpoint de búsqueda...». Por un lado, ese monólogo interno protege al algoritmo de errores tontos. Por otro, multiplica por 1.5 o 2 el consumo de tokens dedicados al razonamiento auxiliar.
Si conectas Ling 3.1 Flash a flujos de automatización con alta carga, limita de forma estricta el parámetro max_tokens para los razonamientos auxiliares y exige en el prompt del sistema que genere la llamada a la herramienta sin largos monólogos introductorios.
Qué cambia este 68% para la automatización local en empresas
Hasta ahora, las empresas que querían agentes de IA autónomos en contabilidad, logística o atención al cliente chocaban con un dilema duro. O pagaban facturas enormes por tokens de API cerradas en la nube —asumiendo además que bases confidenciales de clientes viajaran a servidores extranjeros—, o desplegaban modelos abiertos en local y sufrían fallos constantes al sexto paso del flujo.
El 68% en AutomationBench demuestra que la brecha entre los gigantes propietarios y los pesos abiertos se está cerrando a toda velocidad. Un modelo de esta categoría puede desplegarse dentro del perímetro corporativo cerrado (on-premise) en un clúster propio de servidores con cuantización de pesos a 4 bits. Obtienes un ejecutor autónomo fiable que no filtra secretos comerciales a la nube, no exige pagar cuotas mensuales y cumple con disciplina reglamentos complejos de múltiples pasos.