En la industria del código generativo reinó durante mucho tiempo un consenso tácito: si necesitas diseñar y programar desde cero una aplicación web funcional, olvídate de las redes neuronales baratas. Se daba por hecho que solo modelos insignia pesados como Claude 3.5 Sonnet o GPT-4o podían dar un resultado decente, con sesiones completas que quemaban fácilmente decenas de dólares en suscripciones y tokens.
Pero ahora mismo estamos viendo un giro tectónico: la nueva generación de modelos chinos ligeros (las familias «Flash») demuestra que es posible armar un prototipo de producto terminado literalmente por calderilla.
Alexey Rybak, fundador de Devhands y reconocido especialista en sistemas de alta carga (highload), realizó un experimento de ingeniería muy revelador. En directo, encargó a dos modelos chinos —DeepSeek 4.1 Flash (compilación 1017) y MiMo 2.6 Flash— construir desde cero un servicio web completo para aprender inglés mediante repetición espaciada de tarjetas (un análogo funcional de Anki y Quizlet). El pago se hizo estrictamente por API pay-as-you-go, sin suscripciones fijas ni límites ocultos.
Los resultados salieron tan contrastados y elocuentes que merecen un análisis detallado.
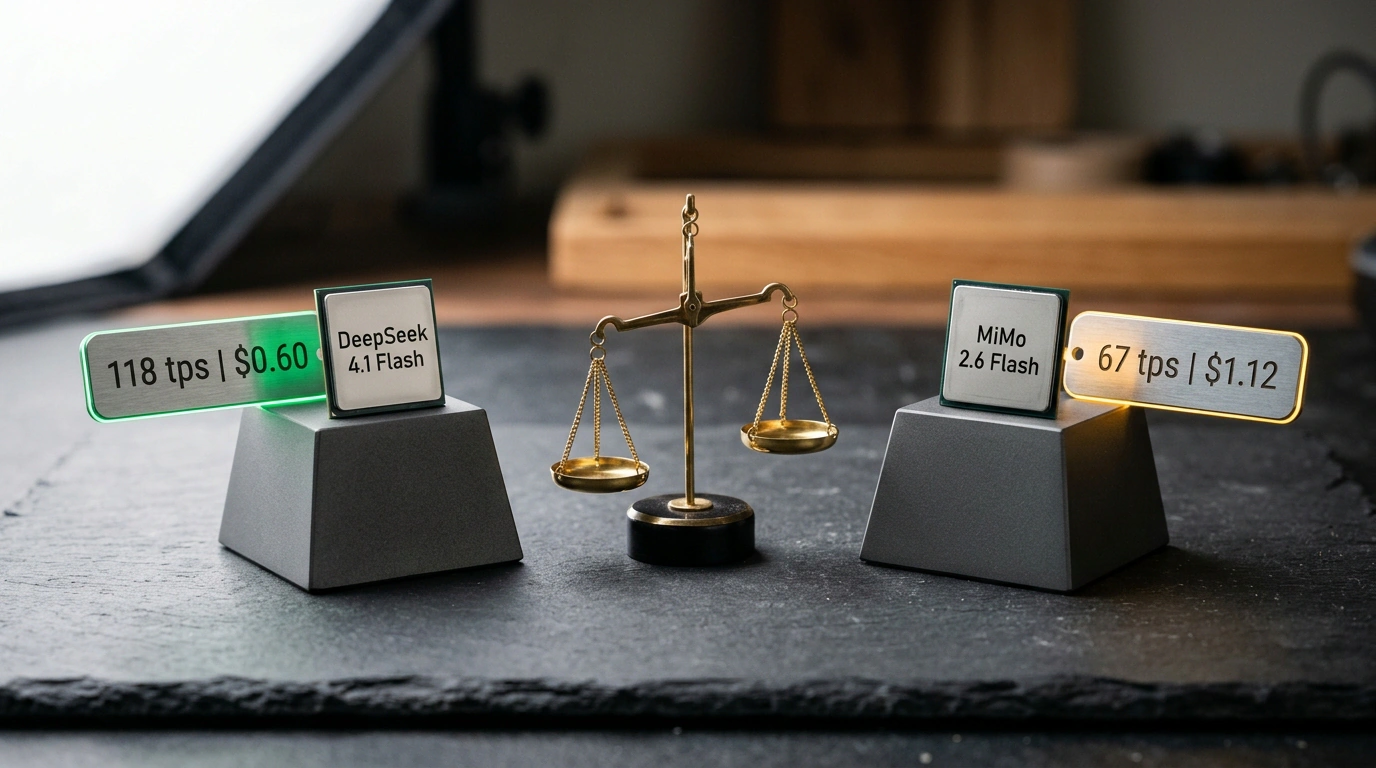
Batalla de métricas: 118 tokens contra 67 y un coste de 60 centavos
La aplicación exigía un stack serio: registro y sesiones de usuario, motor de tarjetas, estadísticas de progreso, editor de mazos, panel de administración para moderar contenido y exportación de datos.
Al terminar la retransmisión se registraron las siguientes cifras:
- DeepSeek 4.1 Flash: alcanzó un rendimiento medio de 118 tokens por segundo (tps), completó la tarea en 298 peticiones de red y costó en total $0.60 (¡sesenta centavos!). El modelo logró terminar la aplicación en pleno directo.
- MiMo 2.6 Flash: marcó una velocidad de 67 tokens por segundo, necesitó 515 peticiones de red y costó $1.12. Debido a su ritmo más lento, terminó cuando la transmisión ya había acabado.
Estas cifras coinciden con los benchmarks independientes de Artificial Analysis, donde las configuraciones optimizadas de DeepSeek mantienen de forma estable la barrera por encima de 120 tps a un precio récord por millón de tokens.
Y aquí se esconde un factor clave de Developer Experience (DX). La diferencia en tiempo real entre 118 y 67 tokens por segundo es abismal. Cuando un modelo escupe menos de 70 tps, el desarrollador acaba distrayéndose, cambiando de pestaña y saliendo del flujo de trabajo. Por encima de 100 tps, el código fluye por la pantalla a la velocidad de lectura rápida, creando la sensación de un diálogo vivo y continuo.
Contraste de estilos: interrogatorio previo frente a programación directa
Sin embargo, la velocidad es solo la mitad de la historia. Lo más interesante salió a la luz en la fase de descomposición de la tarea.
Al principio, DeepSeek mostró tendencia a un «interrogatorio» excesivo (grilling). Nada más recibir el encargo, empezó a lanzar decenas de preguntas minuciosas: qué esquema de base de datos elegir, cómo validar exactamente las contraseñas, qué animaciones añadir a las tarjetas. Para un principiante es útil, pero a un ingeniero con experiencia ese dar vueltas sin crear archivos empieza a desesperarlo.
MiMo 2.6 Flash actuó de otra manera: fijó con rapidez y seguridad los límites arquitectónicos y casi de inmediato pasó a generar archivos. Parecía que MiMo ganaría la carrera. Pero en cuanto empezó la escritura masiva de código, ir a la mitad de velocidad de generación de tokens le jugó una mala pasada: mientras MiMo redactaba cada función, DeepSeek generó de una tacada los módulos de autenticación, administración y maquetación, adelantando a su rival por medio cuerpo.
Este contraste ilustra muy bien las tendencias que vimos al analizar el dumping de precios en el desarrollo web: la velocidad de salida se convierte en el factor decisivo cuando se genera código de forma autónoma.
La nueva realidad: ¿hacen falta modelos insignia de $20?
El experimento entierra de forma gráfica el mito de que validar una hipótesis o levantar un prototipo exige suscripciones occidentales caras. Una sesión de 60 centavos te da un monolito funcional con base de datos, rutas y frontend.
Pero tampoco conviene caer en la euforia. Los modelos Flash ligeros escriben de maravilla el código estándar («happy path»): operaciones CRUD, formularios básicos, componentes típicos. Sin embargo, siguen necesitando supervisión estricta de un arquitecto humano en los escenarios críticos:
- Gestión correcta de transacciones en la base de datos;
- Protección frente a race conditions en peticiones paralelas;
- Validación rigurosa de tipos entrantes en las fronteras de la API.
Aun así, el equilibrio de fuerzas en el mercado ha cambiado para siempre. Los modelos chinos DeepSeek, MiMo, Qwen y MiniMax han demostrado que la era del monopolio caro sobre la generación de código ha terminado, y que el coste de prototipar tiende al coste de la electricidad.