Cada vez que en una presentación muestran al enésimo «agente de IA autónomo», nos pintan la misma estampa futurista: cae un servidor, el equipo de guardia duerme a pierna suelta y la red neuronal lee los logs, corrige la configuración y cierra el incidente por su cuenta. Cualquier ingeniero que haya hecho guardias en producción bajo cientos de miles de RPS se limita a sonreír: en una infraestructura real hay demasiadas dependencias ocultas y pistas falsas como para entregarle producción a un modelo de lenguaje.
¿O quizá ya nos hemos acercado a esa frontera más de lo que parece?
En la conferencia Signals Berlin intervino Alex Palcuie, ex Staff SRE en Google con ocho años de experiencia que actualmente hace guardias en el equipo de fiabilidad de Anthropic. Su charla llevaba un título directo al grano: «Can Claude fix itself? From no to maybe». En primavera, durante QCon London, su veredicto había sido un «no» rotundo. Sin embargo, tras seis meses de guardias reales con el agente de consola Claude Code, su postura viró hacia un prudente «tal vez».
Tras revisar la charla de Alex Palcuie, decidí analizar tres incidentes reales dentro de Anthropic para entender en qué brillan ya los agentes de IA y dónde siguen siendo un peligro mortal para los sistemas en producción.
Tres incidentes reales: del destello «Move 37» a la pista falsa
Lo más valioso de la experiencia de Anthropic es la crónica honesta de cómo se comporta el agente ante anomalías repentinas en la telemetría.
El primer caso ocurrió en Nochevieja. El modelo insignia de Claude empezó a devolver un pico de errores HTTP 500. El ingeniero de guardia lanzó Claude Code para localizar el fallo. El modelo escaneó las trazas y detectó algo extraño: la caída se producía en el módulo de preprocesamiento de imágenes exclusivamente en peticiones que llevaban exactamente 22 imágenes adjuntas.
Un ingeniero de guardia normal habría abierto un ticket para el equipo de backend y reiniciado los servicios. Pero el agente fue más allá: cruzó los metadatos de los clientes y descubrió que las peticiones llegaban desde 200 cuentas con correos electrónicos similares, creadas tres días antes dentro de un lote de 4,000 cuentas. Era un ataque DoS coordinado. El agente recomendó avisar de inmediato al equipo de seguridad, que bloqueó a los atacantes. En Anthropic bautizaron este episodio como su momento «Move 37», en alusión a la inesperada jugada número 37 de AlphaGo en el tablero de go.
El segundo incidente destapó un fallo en la propia monitorización. El router de inferencia desconectó de golpe un clúster operativo y desvió el tráfico hacia los nodos vecinos, provocando una sobrecarga. En el chat del incidente culpaban a la red del centro de datos. Pero Claude se fijó en los números: varios servidores reportaban una velocidad de generación de tokens físicamente imposible para los aceleradores instalados. El agente comprendió que el hardware estaba sano y que lo que fallaba era el medidor. Resultó que el recolector de métricas había pasado por un resharding y dos shards habían estado consultando en paralelo los mismos servidores durante cinco minutos, duplicando las cifras de carga.
Sin embargo, el tercer incidente enfrió el entusiasmo. En un clúster, la tasa de errores saltó al 41%. Claude examinó los paneles y notó que justo antes la tasa de aciertos de la caché local (hit rate) había caído casi a cero. El modelo armó una teoría impecable: la caché se vació, las peticiones fueron al disco lento y el nodo sufrió un timeout. Sonaba lógico, pero era una pista falsa (red herring). Más tarde se comprobó que las peticiones fallidas en local se servían sin problemas desde la caché distribuida compartida, y que la causa real era una banal saturación de CPU. El agente cayó en una trampa clásica: si buscas anomalías entre cientos de gráficos sin una hipótesis previa, siempre encontrarás alguna correlación.
El agente en el bucle OODA: dónde es fuerte la IA y dónde es peligrosa
Para evaluar de forma sistemática los límites de la IA en operaciones, en Anthropic mapearon las acciones del modelo sobre el ciclo militar OODA: «Observar — Orientar — Decidir — Actuar».
En la fase de Observación (Observe) el agente muestra una velocidad fenomenal. A un humano le cuesta mantener abiertas decenas de pestañas de Grafana y filtrar terabytes de logs a la vez. El agente lo hace en segundos y saca a la luz patrones poco evidentes.
Pero en la fase de Orientación (Orient) aparece la principal línea de riesgo. El modelo tiende a confabular: dibuja relaciones causales donde solo hay una coincidencia fortuita. Confiar a ciegas en las conclusiones del agente puede alargar la extinción de un incendio durante horas.
En la etapa de Decisión (Decide) el modelo resulta útil: propone opciones de mitigación contrastando con la base de conocimiento y los postmortems de fallos anteriores.
Pero en la etapa de Acción (Act) hay una línea roja absoluta. Ningún departamento SRE debería darle a un modelo permiso para ejecutar comandos que alteren el estado del clúster sin control.
Clasificador de acciones y el techo de contexto en telemetría
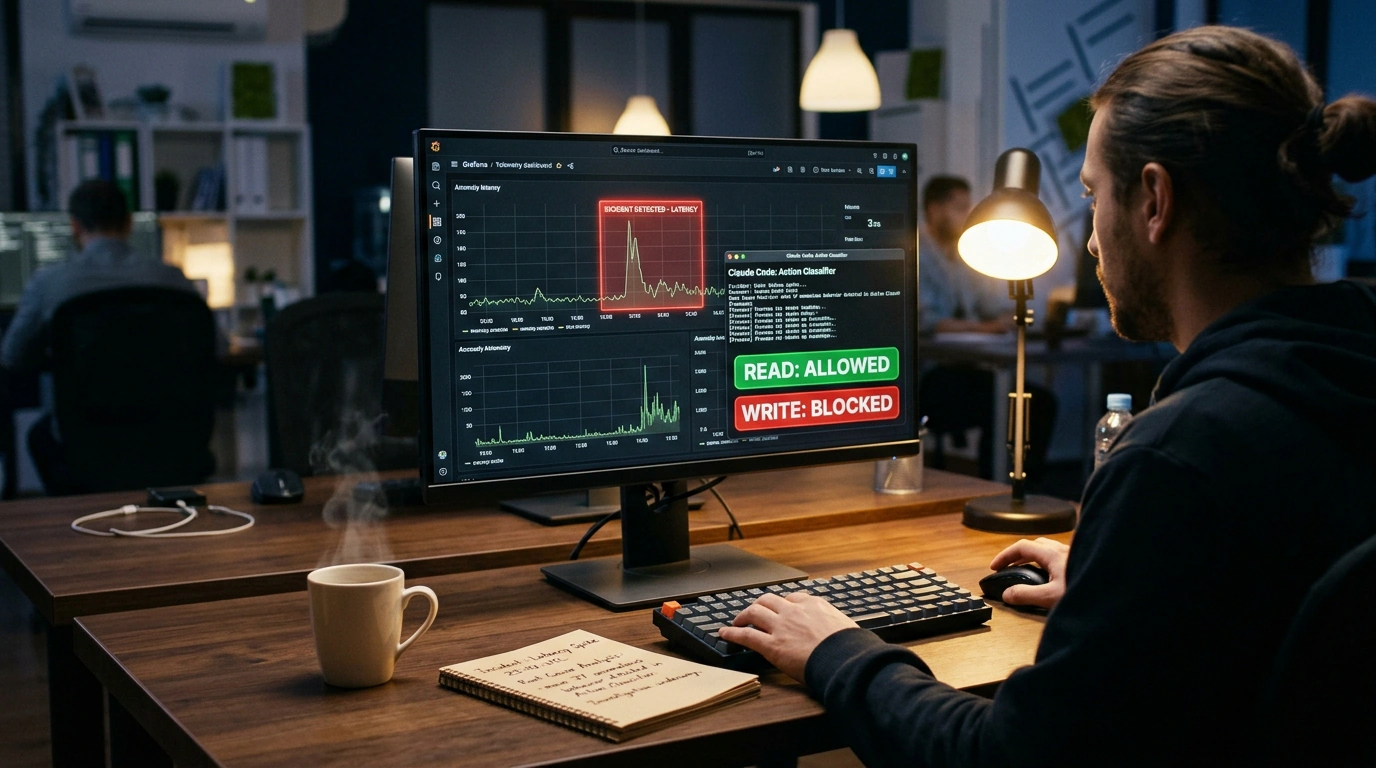
La conclusión principal de la práctica en Anthropic es clara: la autonomía del agente debe ser estrictamente asimétrica mediante un clasificador de acciones (Action Classifier) obligatorio.
Cualquier operación segura de lectura —ejecutar peticiones GET, consultar logs, medir latencias, tomar volcados de memoria— puede ejecutarla el agente de forma autónoma. Pero en cuanto el modelo intenta lanzar un kubectl delete, reiniciar un balanceador o desplegar un hotfix, la ejecución se bloquea hasta recibir confirmación explícita de una persona. Estos principios conectan directamente con la experiencia práctica trabajando con Claude Code, donde el control estricto de permisos marca la fiabilidad.
La segunda barrera es el coste y la fragmentación de la telemetría. Como señala Sylvain Kalache, de Rootly, en empresas reales enviar logs en streaming hacia almacenamiento en la nube choca con facturas enormes de tráfico. Además, el contexto del incidente está disperso: las métricas viven en Prometheus, los logs en Loki y las trazas en Jaeger. Sin una integración profunda mediante protocolos como MCP, el agente trabaja a ciegas.
Hoy en día, Claude Code ya puede convertirse en un excelente copiloto durante una guardia. Pero el timón de producción debe seguir bien sujeto por un ingeniero de carne y hueso.