El internet de toda la vida, construido alrededor del buscador clásico, se desvanece a toda velocidad. Durante un cuarto de siglo las reglas no cambiaron: el usuario escribía una consulta, el buscador devolvía diez enlaces azules y las webs peleaban por los primeros puestos orgánicos para recibir tráfico directo de referencia.
Hoy ese cimiento cruje por todas partes. El CEO de Google, Sundar Pichai, lo dijo sin rodeos: la búsqueda web está siendo absorbida por una «capa agéntica» (Agentic Layer). La barra de búsqueda se transforma en una única ventana conversacional (one-box), donde los algoritmos de IA agregan datos de decenas de fuentes, sintetizan una respuesta lista para usar y ejecutan acciones. Todo creador de contenido se enfrenta a la misma duda: ¿quedará espacio para lectores humanos, o la web abierta acabará convertida en una mina de materia prima cerrada para entrenar robots?
Para separar el ruido emocional de los datos duros, revisé a fondo varios estudios empíricos de gran escala: el análisis de 380 000 respuestas generativas de Foundation Marketing (Ross Simmonds), la base de citas de Ahrefs con 168 millones de enlaces, el boletín SEOFOMO de Aleyda Solis y las aclaraciones técnicas de Google Search Central. El panorama real resultó mucho más matizado de lo que suele contarse.
1. El fin de los diez enlaces azules: la capa agéntica de búsqueda
Las declaraciones de Sundar Pichai certifican un cambio tectónico: el buscador ya no aspira a ser un escaparate de páginas ajenas. Si antes alguien buscaba un tutorial para configurar un servidor, hacía clic en un artículo y lo leía en el sitio del autor, ahora Google AI Overviews o el modo conversacional AI Mode sueltan la lista de comandos lista para copiar en la propia página de resultados.
Según un estudio de la plataforma SE Visible (sobre una muestra de 1000 búsquedas de marca y categoría en EE. UU.), el bloque de AI Overviews ya se activa en el 42 % de los casos. El impacto para las webs es tangible: cuando aparece una respuesta generativa en la parte superior de la pantalla, el CTR medio de las posiciones orgánicas cae un 32 %. El usuario resuelve su duda en cinco segundos y cierra la pestaña.
En la industria cundió el pánico ante la era de los «cero clics» (zero-click search). Pero si diseccionas cómo seleccionan sus fuentes las redes neuronales, emerge la clave: los clics no han desaparecido, sino que se han redistribuido bajo reglas nuevas.
Si estás adaptando tu estrategia de posicionamiento a los nuevos algoritmos, seguro que te suenan nuestros análisis sobre el seguimiento de impresiones en AI Overviews desde Google Search Console, la transformación del recorrido del cliente en la búsqueda sin clics y la IA generativa, y las nuevas reglas en el concepto de GEO y la citación en AI Search. Veamos estos mecanismos a través de cientos de miles de consultas reales.
2. Dos internets divididos: por qué Google elige YouTube y ChatGPT prefiere Reddit
Uno de los hallazgos más llamativos de los últimos meses es la existencia de dos ecosistemas aislados dentro de la búsqueda generativa. Al cruzar 168,5 millones de enlaces en Ahrefs Site Explorer salió a la luz una grieta profunda entre los grandes buscadores y los asistentes conversacionales.
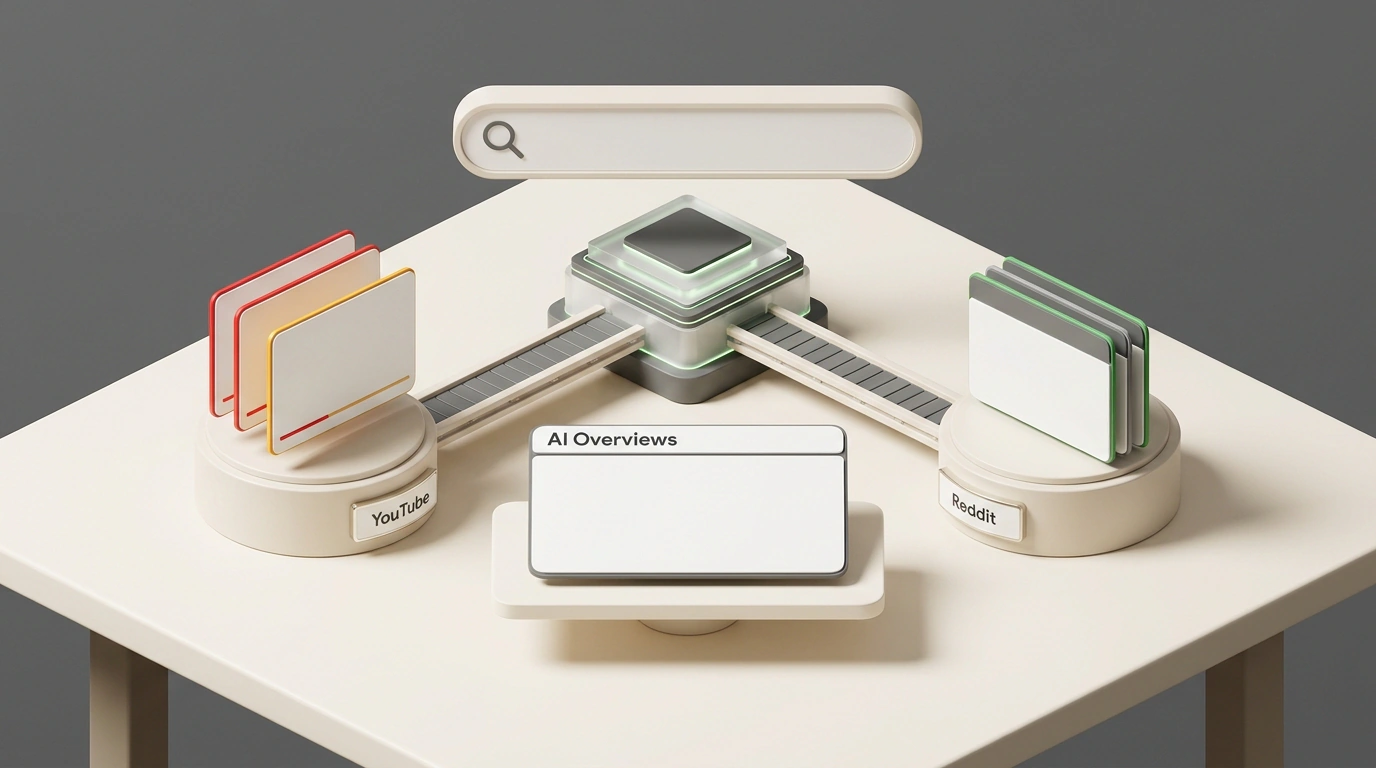
Comparación infográfica de la proporción de citas de YouTube y Reddit en los buscadores Google, Copilot y ChatGPT.
Fíjate en las cifras de proporción entre citas a YouTube y al foro Reddit:
- Las superficies de búsqueda de Google (AI Overviews y AI Mode) destinan entre el 5,6 % y el 5,8 % de todas sus citas externas a YouTube. En respuestas que enlazan fuentes primarias, YouTube aparece entre el 38 % y el 47 % de las veces. La relación de enlaces YouTube frente a Reddit es de 2,1 a 1 a favor del vídeo.
- Microsoft Copilot muestra un sesgo aún más acusado: la proporción de citas de YouTube frente a Reddit alcanza un 10,1 a 1. Tanto los motores de Microsoft como los de Google devoran contenido en vídeo.
- Los asistentes conversacionales (ChatGPT Search, Perplexity, Claude) habitan el universo opuesto. En las respuestas de Perplexity la relación YouTube/Reddit es de 0,6 a 1, y en ChatGPT baja a 0,4 a 1. ¡Aquí Reddit se cita 2,5 veces más que la plataforma de vídeo de Google!
El motivo de esta fractura es arquitectónico. Los generadores de búsqueda de Google se apoyan en el índice web clásico, donde ya tienen dominadas la transcripción de vídeos, la división por capítulos y la extracción de fotogramas. Para Google, el vídeo es un bloque de datos denso, estructurado y protegido contra el spam SEO textual.
En cambio, OpenAI y Perplexity apuestan por capturar experiencia humana sin filtros. El acuerdo de licencia con Reddit abrió a sus modelos el pulso vivo de las discusiones. Cuando alguien pregunta a ChatGPT cómo sale de verdad un coche tras años de uso o qué CMS elegir, el modelo busca hilos reales en Reddit y Quora, ignorando los vídeos promocionales pulidos.
La conclusión es rotunda: si solo publicas artículos de texto en tu blog, te amputas la mitad del mapa de búsqueda. Sin presencia en YouTube eres invisible para Google AI Overviews; sin participar en comunidades eres invisible para ChatGPT.
3. La fórmula para entrar en la respuesta: anatomía de 380 000 generaciones de búsqueda
El equipo de Foundation Marketing, liderado por Ross Simmonds, analizó una muestra de 380 000 respuestas de IA generativa en el sector de software B2B.
El estudio reveló que los algoritmos de citación en AI Overviews obedecen a tres patrones estructurales:
La primera ley es el «Principio de dominio del top-1 en consultas en abanico». Cuando un usuario lanza un prompt complejo («compara CRM para retail con precios y soporte para 1C»), el agente de búsqueda descompone la petición en una serie de subconsultas (fan-out queries): arquitectura, tarifas, integraciones. En cada una de esas subbúsquedas, la fuente en primera posición se lleva el 58 % de todas las citas posteriores en el bloque sintetizado. El segundo puesto recibe el 16 %, el tercero un 9 % y por debajo del quinto prácticamente desaparecen. Si tu contenido no resuelve una intención concreta de forma exhaustiva, tus opciones de entrar son mínimas.
La segunda ley es «Listas estructurales y modularidad». Los artículos maquetados como listas con criterios claros de comparación se citan en el 64 % de las respuestas comparativas de IA. A los modelos transformer les cuesta extraer hechos de un bloque denso de texto sin subtítulos. Cuando la página presenta una estructura nítida («Parámetro 1: Límites», «Parámetro 2: Coste»), el algoritmo traslada ese bloque al resultado sin distorsiones.
La tercera ley son los «Anclajes definitorios (Definitional Anchors)». Los textos que arrancan con una definición concentrada de la esencia del concepto en sus dos primeras frases se convierten en los principales donantes para los párrafos introductorios de AI Overviews. El modelo busca una formulación densa que pueda encajar justo debajo de la barra de búsqueda.
Estructura tus ideas como bloques autosuficientes: un subtítulo que formule con claridad el problema, una primera frase que dé una definición precisa sin relleno y una lista de 3 o 4 puntos con parámetros o pasos. Esos ladrillos son los que el agente de búsqueda copia primero en su resumen.
4. Barreras técnicas y protocolo: la falsa protección de robots.txt
Ante la inquietud de los editores, muchos sitios empezaron a cerrar el paso a los rastreadores mediante el archivo robots.txt. Sin embargo, la explicación técnica de los ingenieros de Google Search Central (Gary Illyes y Cherry Prommawin) desmonta varias ilusiones peligrosas sobre esta práctica.
La especificación RFC 9309 se creó únicamente para regular la descarga de páginas por parte de bots buscadores. No prohíbe usar datos que ya están en el índice para entrenar redes neuronales. Si una página ya fue indexada antes, añadir una directiva Disallow no la borra de la base de conocimiento del modelo.
Es más: bloquear rastreadores especializados (Google-Extended, GPTBot, PerplexityBot) expulsa a tu web de la lista de fuentes citadas. El modelo no deja de responder sobre tu marca; simplemente pasa a apoyarse en lo que cuentan tus competidores y en reseñas de sitios externos.
Los ingenieros de Google también recordaron un detalle técnico: las rutas en robots.txt que contengan caracteres no latinos deben codificarse con percent-encoding. Un fallo de sintaxis provoca que los rastreadores ignoren la regla o dejen fuera del índice secciones válidas de tu sitio.
Bloquear rastreadores de nueva generación vía robots.txt no protege tus datos de ser utilizados, pero garantiza que tu empresa desaparezca de los bloques de recomendación. La estrategia inteligente pasa por servir datos estructurados y hechos verificables mediante APIs abiertas.
5. Nueva economía de la atención: del clic directo al consenso semántico
¿Cómo trabajar en una época en la que los clics dejan de reflejar la realidad? Analistas de búsqueda como Gianluca Fiorelli, Cyrus Shepard y Eli Schwartz proponen cambiar la óptica de medición.
Medir la presencia en la búsqueda con IA solo por el último clic (last-click attribution) es un callejón sin salida. El tráfico directo desde el enlace al pie en AI Overviews es modesto, pero su efecto indirecto es enorme. Cuando un comprador ve recomendada tu plataforma en una respuesta sintetizada de ChatGPT o Google, nace la confianza. Dos días después buscará tu marca directamente o entrará a contratar el servicio. La analítica registra un repunte claro de conversiones asistidas y tráfico directo justo donde la marca aparece citada de forma recurrente por sistemas generativos.
Para ganar hace falta la estrategia de «consenso semántico» de Ross Simmonds. Una red neuronal confía en un dato cuando lo encuentra respaldado en varios nodos independientes de la red. Tu autoridad debe repartirse en cinco capas:
- Longread experto en tu propio dominio — fuente primaria de términos, cifras y metodología.
- Vídeos formativos en YouTube — transcripciones y material visual para Google y Copilot.
- Hilos vivos en foros y Reddit — prueba social para los LLM conversacionales.
- Fichas estructuradas en directorios — atributos inequívocos y legibles por máquina.
- Citas en medios especializados del sector — respaldo de autoridad para el ranking.
La era de rellenar webs con texto insustancial para cazar clics orgánicos ha terminado. Pero para quienes saben crear contenido basado en pruebas y distribuirlo por todo el ecosistema de canales, la búsqueda agéntica abre un potente multiplicador de visibilidad.