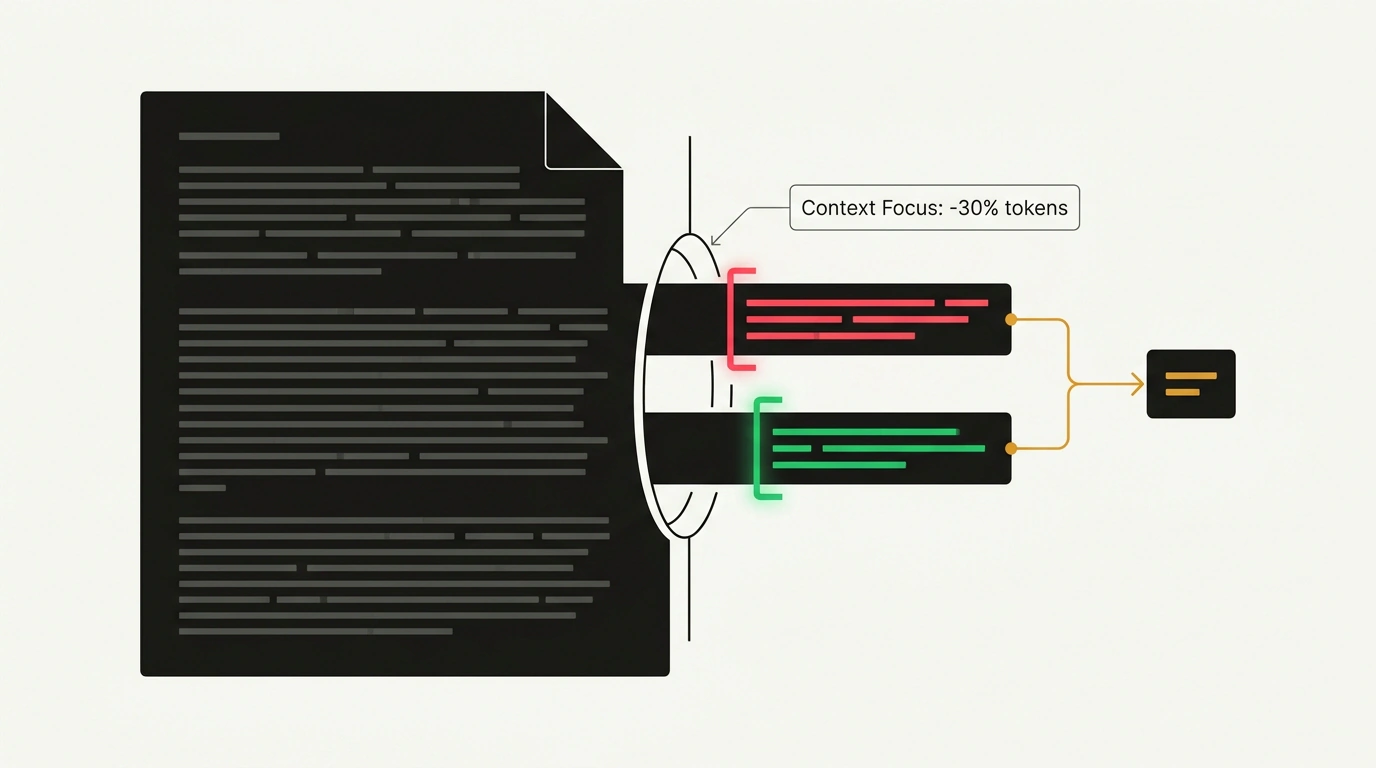
El error clásico al diseñar pipelines de búsqueda RAG resulta demasiado familiar. Configuras la base vectorial, lanzas la búsqueda por embeddings, recuperas una decena de fragmentos de texto completos y los metes sin filtrar en el contexto de un modelo generativo caro. Al final, la mayor parte del contexto se llena de ruido irrelevante, la factura de tokens se dispara y la red neuronal sufre el efecto «perdido en el medio» (lost in the middle), pasando por alto el dato clave entre páginas de paja técnica.
El lanzamiento de la familia de modelos Cohere Rerank 5 ataja este problema de raíz. Su gran novedad es el mecanismo Context Focus, que no se limita a reordenar los documentos por relevancia, sino que recorta de forma quirúrgica los fragmentos semánticos exactos, reduciendo el gasto en contexto en más de un tercio.
Dos perfiles: versiones Pro y Fast para distintas cargas
En su quinta generación, la gama Rerank se divide en dos modelos especializados según el escenario:
rerank-v5.0-pro— el modelo insignia de máxima precisión. Está pensado para analizar documentación técnica compleja, normativas, informes financieros y tablas semiestructuradas.rerank-v5.0-fast— un modelo ligero de latencia mínima, optimizado para bucles agénticos de alta carga donde el reordenamiento se invoca decenas de veces por minuto en segundo plano.
Ambos modelos amplían su ventana de contexto hasta los 32 000 tokens (frente al límite de apenas 4000 tokens de la generación anterior), añaden soporte nativo para más de 100 idiomas y analizan directamente estructuras JSON y YAML sin tener que aplanarlas a texto plano.
Además, Rerank 5 introduce puntuaciones de relevancia calibradas (calibrated scores). Antes tocaba adivinar a ojo y quedarse con un número fijo de documentos mediante top_n. Ahora las puntuaciones están normalizadas y son comparables entre consultas, lo que permite fijar un umbral estricto de corte (por ejemplo, aceptar solo fragmentos con score > 0.35).
Mecanismo Context Focus: cortar el ruido antes de generar
El verdadero salto arquitectónico de Rerank 5 es la función Context Focus. Un reranker convencional recibe una lista de documentos encontrados y la devuelve en un orden distinto, pero los documentos siguen intactos. Si dentro de un reglamento de 2000 palabras solo había una frase útil sobre los plazos de garantía, el bloque entero acababa viajando al modelo generativo.
Context Focus funciona de otra manera: el modelo analiza el texto del documento y devuelve los rangos exactos de caracteres (start y end) que contienen la respuesta directa a la pregunta. Al construir el prompt final para el generador, solo pasas esos párrafos extraídos. Según las pruebas de Cohere, esto recorta el volumen del contexto en más de un 30 % a la vez que reduce el riesgo de alucinaciones.
Si estás optimizando de forma sistemática el coste de tu infraestructura, te recomiendo revisar nuestros artículos sobre estrategias para reducir el gasto en peticiones API y técnicas de compresión de contexto con Ponytail. Combinar un filtrado previo con un reordenamiento selectivo genera un ahorro muy tangible en producción.
En la práctica: integración con Python SDK y LlamaIndex
Conectar Context Focus en Python se hace a través del cliente oficial Cohere API v2 pasando el parámetro relevant_spans:
import cohere

# Inicialización del cliente Cohere API v2
co = cohere.ClientV2(api_key="COHERE_API_KEY_HERE")

documents = [
    "Регламент возврата оборудования: клиент обязан уведомить поддержку в течение 14 дней с момента поставки.",
    "История основания компании: первый офис был открыт в Торонто в 2019 году группой исследователей.",
    "Условия гарантийного обслуживания: при нарушении пломбы корпус признается негарантийным."
]

query = "В какой срок необходимо сообщить о возврате оборудования?"

# Llamada a rerank-v5.0-pro con extracción de intervalos exactos de respuesta
response = co.rerank(
    model="rerank-v5.0-pro",
    query=query,
    documents=documents,
    top_n=2,
    relevant_spans={"mode": "enabled", "threshold": 0.15, "max_spans": 2}
)

for rank, result in enumerate(response.results):
    doc_text = documents[result.index]
    print(f"Ранг {rank + 1} | Score: {result.relevance_score:.4f}")
    if hasattr(result, "relevant_spans") and result.relevant_spans:
        for span in result.relevant_spans:
            print(f"  -> Context Focus: {doc_text[span['start']:span['end']]}")
En un stack de búsqueda basado en LlamaIndex, el modelo se integra como posprocesador de nodos:
from llama_index.core import VectorStoreIndex
from llama_index.postprocessor.cohere_rerank import CohereRerank

# Configuración del nodo de reordenamiento con el modelo rápido Rerank 5 Fast
reranker = CohereRerank(
    model="rerank-v5.0-fast",
    api_key="COHERE_API_KEY_HERE",
    top_n=3
)

# Construcción del motor con recuperación inicial y compresión posterior
query_engine = index.as_query_engine(
    similarity_top_k=15,
    node_postprocessors=[reranker]
)

response = query_engine.query("Каковы штрафы за несоблюдение SLA во 2 квартале?")
print(str(response))
El mecanismo ofrece sus mejores resultados en fragmentos grandes de texto de entre 1000 y 10 000 caracteres (artículos, normativas, informes). En trozos pequeños de menos de 100 caracteres, la sobrecarga de calcular los intervalos no compensa el ahorro de tokens.
Límites de aplicación y equilibrio económico
La principal limitación de Cohere Rerank 5 viene de su dependencia de red: el modelo se ofrece como servicio en la nube, por lo que hay que tener en cuenta la latencia. Además, la opción Context Focus viene desactivada por defecto, así que debes habilitarla explícitamente en tu código mediante el diccionario relevant_spans.
Aun así, incorporar un reranker dedicado se amortiza con creces en cualquier base de conocimiento corporativa. El coste de llamar a Rerank 5 es órdenes de magnitud inferior al de pasar tokens sobrantes por un LLM generativo, y la precisión de las respuestas deja de verse lastrada por el ruido aleatorio de la búsqueda.

