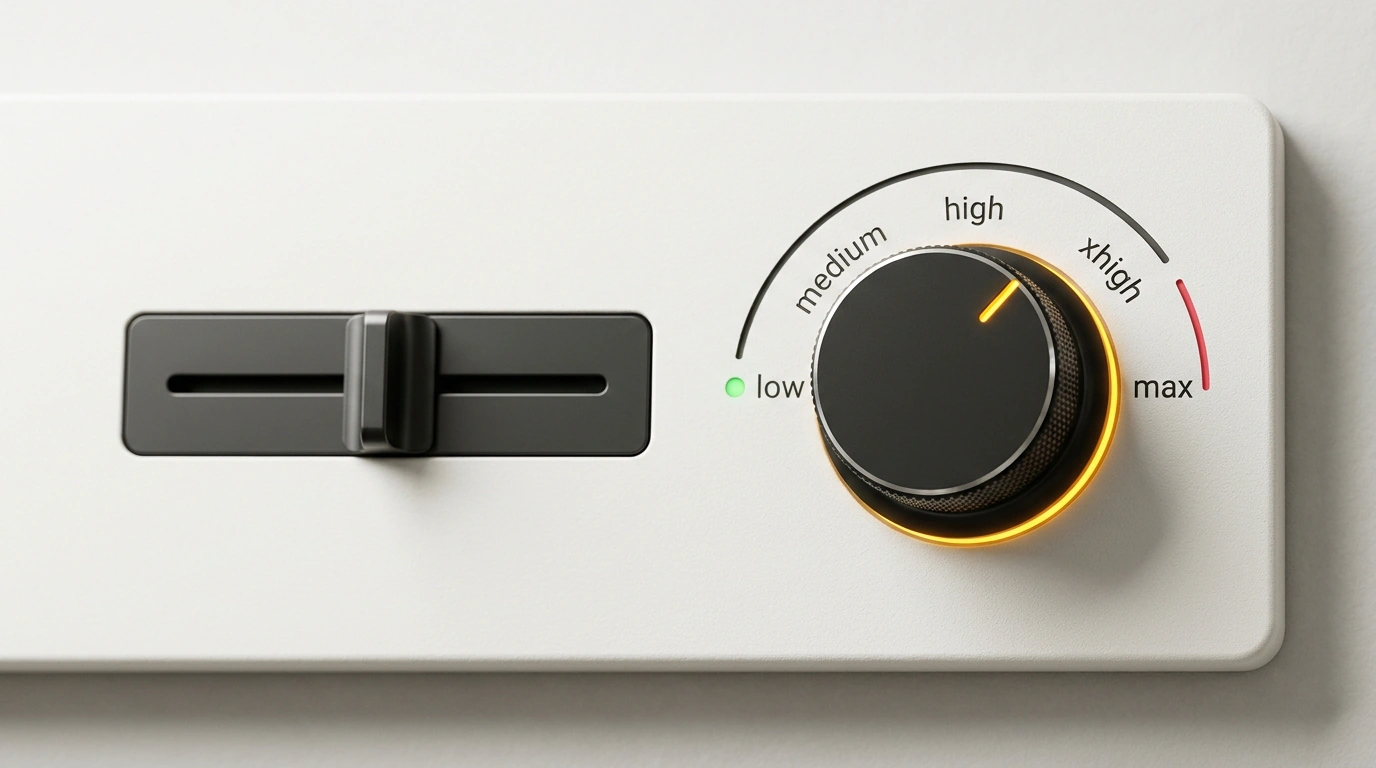
Cuando a los desarrolladores nos ponen delante un nuevo selector de «potencia de pensamiento» para una red neuronal, la primera reacción natural es subir la perilla al máximo. Suena lógico: ¿para qué conformarse con una respuesta superficial si puedes hacer que el modelo piense a pleno rendimiento? Sin embargo, en el agente de terminal Claude Code de Anthropic, ese maximalismo acaba en un golpe de realidad inesperado. Lanzas una tarea sencilla, vas a prepararte un café, vuelves cuarenta minutos después y la terminal sigue probando hipótesis, quemando tokens y levantando abstracciones alrededor de un script de veinte líneas.
El parámetro effort llega para poner fin a este dilema. El equipo de Anthropic, liderado por Thariq Shihipar y Lydia Hallie, formalizó el gasto computacional del agente dividiéndolo en cinco niveles claros: desde el esprint instantáneo de low hasta la maratón autónoma de max. Veamos cómo funciona esta escala, cuándo el modo máximo realmente salva un proyecto y en qué situaciones solo sirve para vaciar tu saldo de API.
Cinco niveles de razonamiento: del esprint a la maratón
Por debajo, el parámetro effort controla el presupuesto de razonamiento (reasoning budget). Define cuántos pasos internos, llamadas al sistema de archivos, comprobaciones de hipótesis y ejecuciones del linter puede hacer el agente antes de decidirse a devolverte una respuesta.
Los ingenieros de Anthropic establecieron cinco escalones discretos:
low— modo de respuestas rápidas. El agente toma la primera hipótesis viable, hace el mínimo de llamadas a herramientas y devuelve el control de inmediato. Ideal para maquetación, generación de plantillas y borradores de funciones.medium— modo equilibrado para el día a día. El modelo realiza una autocomprobación básica, pero no se pierde en disquisiciones filosóficas sobre la base de código.high— auditoría minuciosa con modelado de casos límite. El agente evalúa deliberadamente rutas alternativas de implementación, rastrea efectos secundarios y ejecuta pruebas.xhigh(extra high) — perfil especializado para sesiones largas (a partir de 30 minutos) que exigen cientos de pasos y millones de tokens en los modelos de razonamiento más avanzados.max— modo de autonomía máxima (one-shot). El modelo intenta resolver un problema arquitectónico complejo sin hacer preguntas intermedias al usuario.
Anatomía de la sobrecarga: 1,5 minutos frente a 67 minutos
Las mediciones sobre Claude Opus demuestran de forma cristalina por qué no conviene dejar el modo max encendido por defecto. En un experimento para crear el prototipo de una aplicación web a partir de una descripción breve, el modo low resolvió la tarea en 1,5 minutos: montó la interfaz básica, conectó los gráficos y entregó un resultado funcional. El mismo prompt en modo max tardó 67 minutos, es decir, ¡44,6 veces más! El agente construyó una simulación compleja y consumió una montaña de tokens donde solo hacía falta un boceto inicial.
Eso sí, tampoco hay que descartar los modos profundos. En el benchmark TerminalBench 3.0, pasar de low a max elevó la proporción de tareas resueltas con éxito de 140 a 214 sobre 370 (un +52,8 % de eficacia). En pruebas atípicas de procesamiento de datos, el nivel low obtuvo un 0 de 5 al aferrarse al primer método que encontró. Con high, el resultado subió a 4 de 5: el agente probó dos algoritmos distintos, detectó una anomalía en los datos de entrada y reescribió el parser.
Si estás afinando flujos de trabajo alrededor de este agente de terminal, te recomiendo repasar nuestro análisis sobre la optimización de Claude Fable 5 y la reducción del consumo de tokens, así como el stack práctico de ahorro de tokens en Claude Code. El nuevo parámetro effort complementa esas prácticas directamente desde la línea de comandos.
En la práctica: flags de CLI, comandos de sesión y caché
Puedes controlar el nivel de esfuerzo de tres maneras. Para una ejecución puntual en la terminal se usa el flag --effort:
# Boceto rápido de la estructura sin razonamiento prolongado
claude --effort low "Создай структуру TypeScript-проекта для парсинга OpenAPI-спецификаций"

# Búsqueda profunda de un fallo intermitente en código multihilo
claude --effort high "Проанализируй race condition в пуле воркеров worker_pool.ts и напиши стресс-тесты"

# Fijar un nivel cómodo por defecto en el perfil del shell
export CLAUDE_CODE_EFFORT_LEVEL=medium
Dentro de una sesión activa de Claude Code ni siquiera hace falta reiniciar: basta con ejecutar /effort o abrir el menú global /config:
# Comprobar la configuración actual del modelo y el consumo de contexto
/config

# Cambio inmediato al modo económico para ajustes menores
/effort low

# Paso al modo de verificación estricta antes de hacer commit
/effort high
No mantengas toda la sesión en el mismo nivel. Empieza descomponiendo la tarea en low o medium. Cuando el esqueleto esté listo, cambia a high para escribir los tests unitarios y verificar los casos límite. Esta estrategia ahorra hasta un 70 % de tokens sin sacrificar la calidad final.
Cuándo echar el freno: límites de uso
Ten en cuenta los compromisos arquitectónicos. Cambiar dinámicamente el nivel de razonamiento con /effort en conversaciones largas puede invalidar la caché de prompts (Prompt Caching), aumentando de forma temporal la latencia de la primera respuesta. Además, el modo max tiende a entrar en bucle en tareas triviales: al verse con un límite enorme de pasos, el modelo empieza a refactorizar módulos vecinos sin necesidad y a multiplicar abstracciones innecesarias.
Reserva max y xhigh para cuando el problema sea realmente de gran escala, el coste de un error resulte crítico y estés dispuesto a dejar al agente trabajando de forma autónoma. Para el desarrollo cotidiano, combinar medium con activaciones puntuales de high sigue siendo la opción más rápida, barata y fiable.

