Edición 15 de noviembreDigest del día · 12 materiales
Qué hay en esta ediciónRevisamos 35 fuentes, reunimos 12 materiales
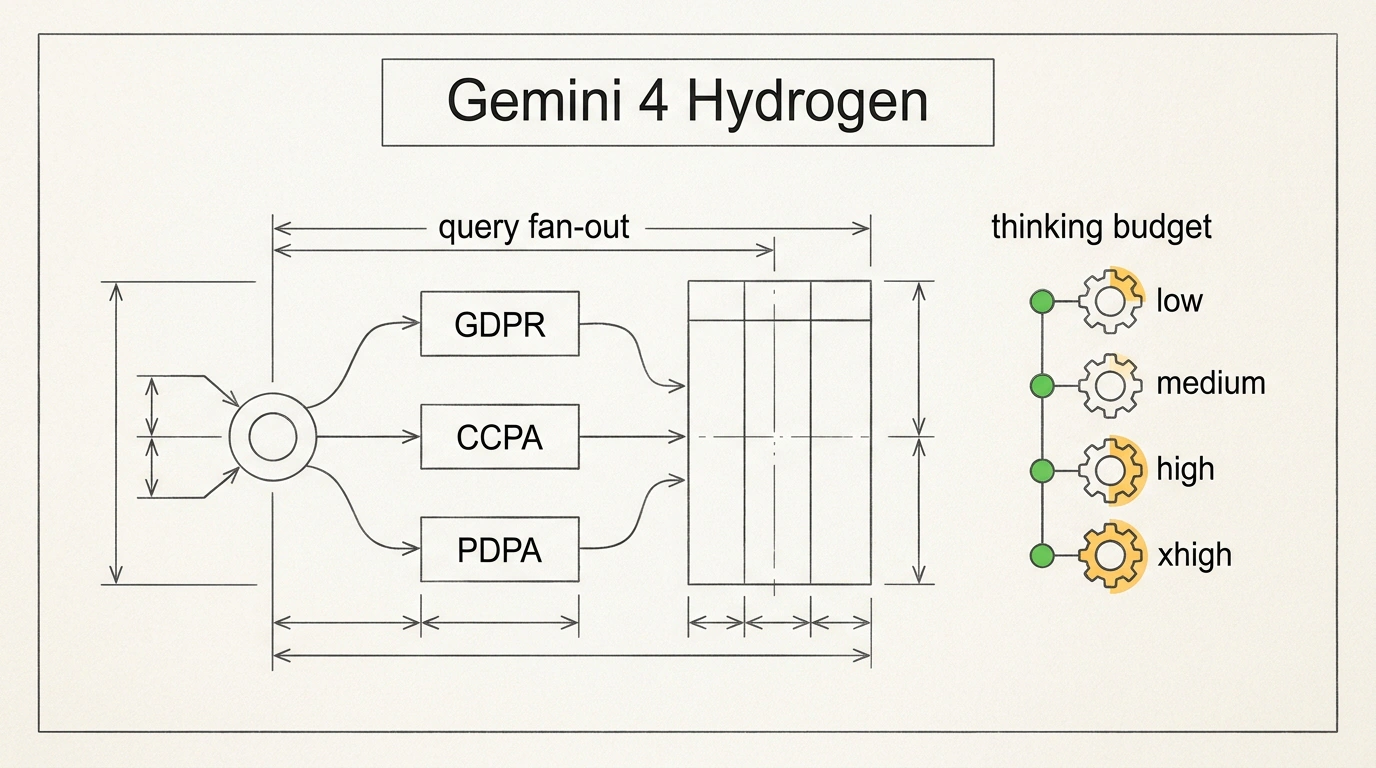
Esquema comparativo de búsqueda en abanico y niveles de razonamiento del modelo Gemini 4 Hydrogen sobre un plano técnico
ArtículoIAInteligencia artificialGeminiModelos

Gemini 4 Hydrogen: arquitectura del modelo rápido, estreno en Google AI Mode y pruebas frente a Argon

La costumbre de confiar la analítica compleja solo a modelos pesados sale demasiado cara: mientras el buque insignia Gemini 4 Argon tarda 14,2 segundos en cruzar leyes sobre biometría, el ligero Gemini 4 Hydrogen arma la misma tabla con un 100% de precisión en las citas en 5,6 segundos.

El nuevo motor de Google AI Mode y Antigravity corre 2,5 veces más rápido que la serie Flash y, en su nivel máximo, supera a Argon en pruebas de inteligencia con un precio de $1.50 por millón de tokens de entrada. Eso sí, subir un escalón innecesario de razonamiento en una tarea simple duplica tu factura sin mejorar la calidad.
👍 35
Julian Goldie SEOGoogle Blog: Gemini 4 Hydrogen Architecture and AnnouncementGoogle AI Studio: Gemini 4 Hydrogen Developer Documentation
15 de noviembre
Escritorio con la pantalla de un portátil mostrando tarjetas conectadas de Claude Whiteboards y hojas de cálculo Sheets
NotaIAInteligencia artificialClaudeAnalítica

Pizarras interactivas, hojas de cálculo y análisis de datos en Claude: así funciona el nuevo espacio de trabajo

Al ver Claude Sheets y Claude Whiteboards en Artifacts, es fácil caer en la tentación de mudar allí los informes de equipo desde Google Sheets. Esa mudanza choca enseguida con los límites de la beta: faltan tablas dinámicas, macros y rangos protegidos, y compartirlo con compañeros sin suscripción resulta incómodo.

En cambio, estos lienzos junto al módulo Claude Data resuelven otro problema: dibujan diagramas de embudos al vuelo y detectan anomalías en las cifras sin salir del chat. Aun así, al armar historias visuales sobre caídas de ingresos, el generador muestra un inesperado punto ciego.

👍 11
The AI AdvantageAnthropic Claude Workspace: Whiteboards, Sheets and Data
15 de noviembre
Terminal de consola del compilador Remotion con código y guion gráfico del anuncio sobre la línea de tiempo de montaje
NotaIAAutomatizaciónProducción de videoCreatividad

Creación programática de vídeos publicitarios con Claude Code: alternativa a la IA generativa sin pagar por re-renders

Las redes de vídeo por difusión como Higgsfield y Runway clavan tomas orgánicas y cámara en mano por la calle, pero en banners publicitarios con precios y logotipos queman el presupuesto: mover el tiempo aunque sea 0,5 segundos obliga a pagar el re-render de todo el clip desde cero.

El montaje programático con Claude Code y el framework Remotion funciona al revés: el agente traduce la referencia a código, ajusta el color de una etiqueta o la velocidad de animación en 2 segundos y exporta el MP4 gratis en local. Aun así, en ciertos guiones publicitarios el código puro se queda corto sin ayuda de las redes de vídeo.

👍 20
Jason WestJulian Goldie SEORemotion Documentation: AI Agent Skills and Claude Code Integration
15 de noviembre
Noticias · 15 de noviembre2 noticias

Guardar personajes en ChatGPT: cómo la etiqueta @Nombre fija la apariencia en todas tus imágenes

Ya no hace falta subir la imagen original en cada chat nuevo para crear una serie con el mismo protagonista. Guarda la imagen en ChatGPT con el comando save this as a reference bajo un nombre corto e invócala con la etiqueta @Nombre en cualquier conversación. El modelo mantendrá proporciones y detalles incluso al llevar la mascota a un pin o un globo aerostático.

Lanzamiento de datasette-llm 0.1a11: soporte para cualquier endpoint compatible con OpenAI en bases de datos

Simon Willison lanzó el plugin datasette-llm 0.1a11, que abre en Datasette compatibilidad con cualquier endpoint estilo OpenAI. Ahora puedes conectar con un solo comando mediante uvx una base SQLite a un modelo local en LM Studio, Ollama o llama.cpp v1.0.0 y analizar tablas privadas sin conexión.

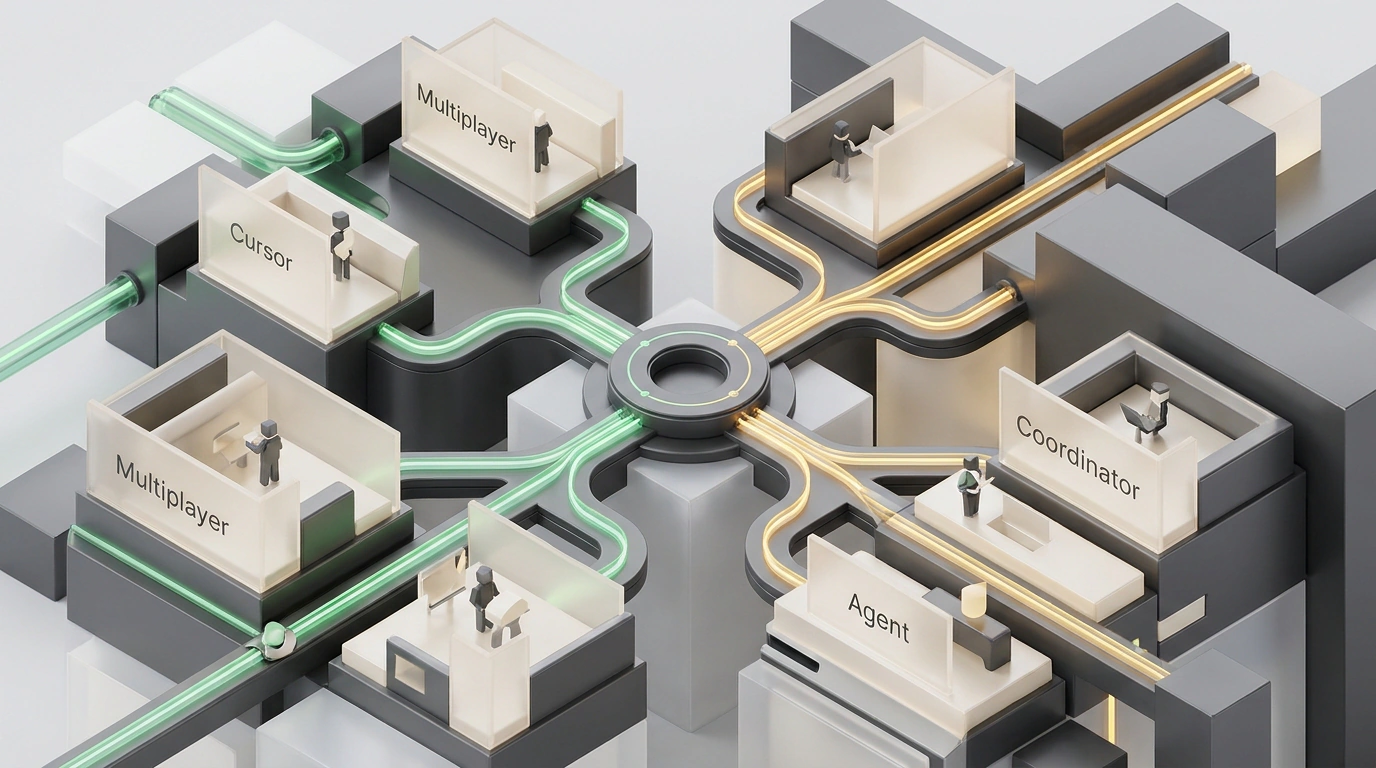
Corte isométrico arquitectónico de un repositorio modular con ramas de código y el nodo de coordinación de Cursor
NotaIAAutomatizaciónCursorHerramientas

Modo Multiplayer en Cursor: cómo trabajan en equipo el coordinador y los agentes de IA en segundo plano

¿Cómo lograr que los agentes de IA de todo el equipo trabajen sobre un mismo repositorio sin pisar cambios ajenos ni bloquear tu editor? En Multiplayer Projects para Cursor, cada miembro cuenta con su propio agente coordinador, que contrasta planes con los bots de sus compañeros mediante una memoria común .cursorrules y un tablero kanban unificado.

Mientras tú escribes el controlador de la API, los Cloud Agents en segundo plano corren en la nube los tests de Jest, verifican tipos de TypeScript y adjuntan un vídeo de comprobación al Pull Request. Sin embargo, en tareas cortas y borradores verdes este engranaje se vuelve caótico con facilidad.

👍 15
Julian Goldie SEOCursor Blog: Introducing Multiplayer Projects and Cloud Agents
15 de noviembre
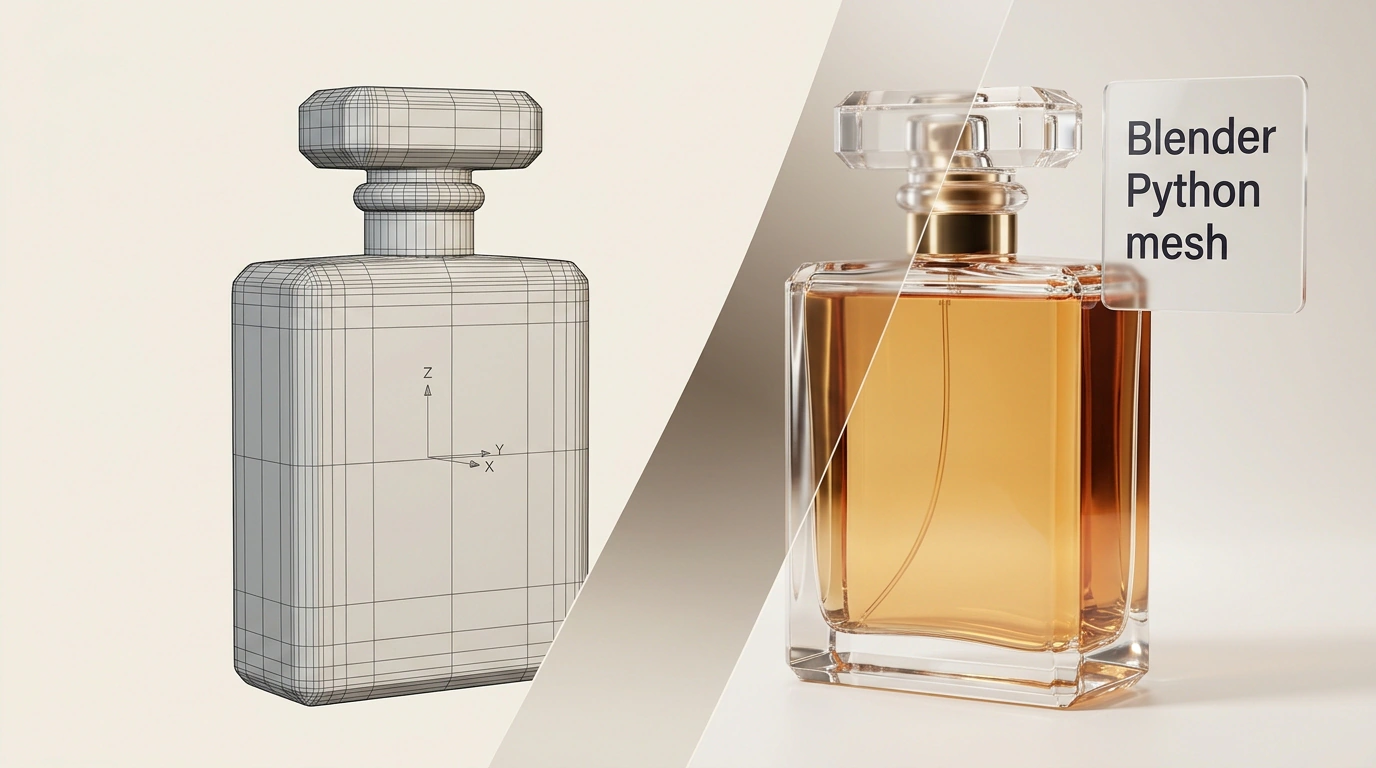
Contraste entre la malla alámbrica y el frasco de cristal fotorrealista en el visor 3D de Blender
NotaIADiseñoInteligencia artificialHerramientas

Modelado 3D procedural en Blender con Claude: generación de escenas precisas por script en lugar de mallas deformadas

Cuando intentas fotografiar un producto con generadores 3D convencionales, la etiqueta se deforma y la malla torcida rompe los brillos. Conectado a Blender, el modelo Claude Fable 5.2 escribe un script limpio en Python con bpy y arma un frasco de 30 mililitros en 287 líneas de código:

  • construye geometría paramétrica con biseles y piezas independientes para el dosificador;
  • configura la refracción del cristal Glass BSDF y una iluminación de estudio de tres puntos;
  • revisa sus propios renders en 6 pasadas y pega las sombras a la mesa.

Pero incluso tras seis comprobaciones, la cánula del gotero dentro del frasco desaparece de la vista sin un ajuste concreto del render.

👍 14
Julian Goldie SEOBlender MCP Connector for Claude and LLMs
15 de noviembre
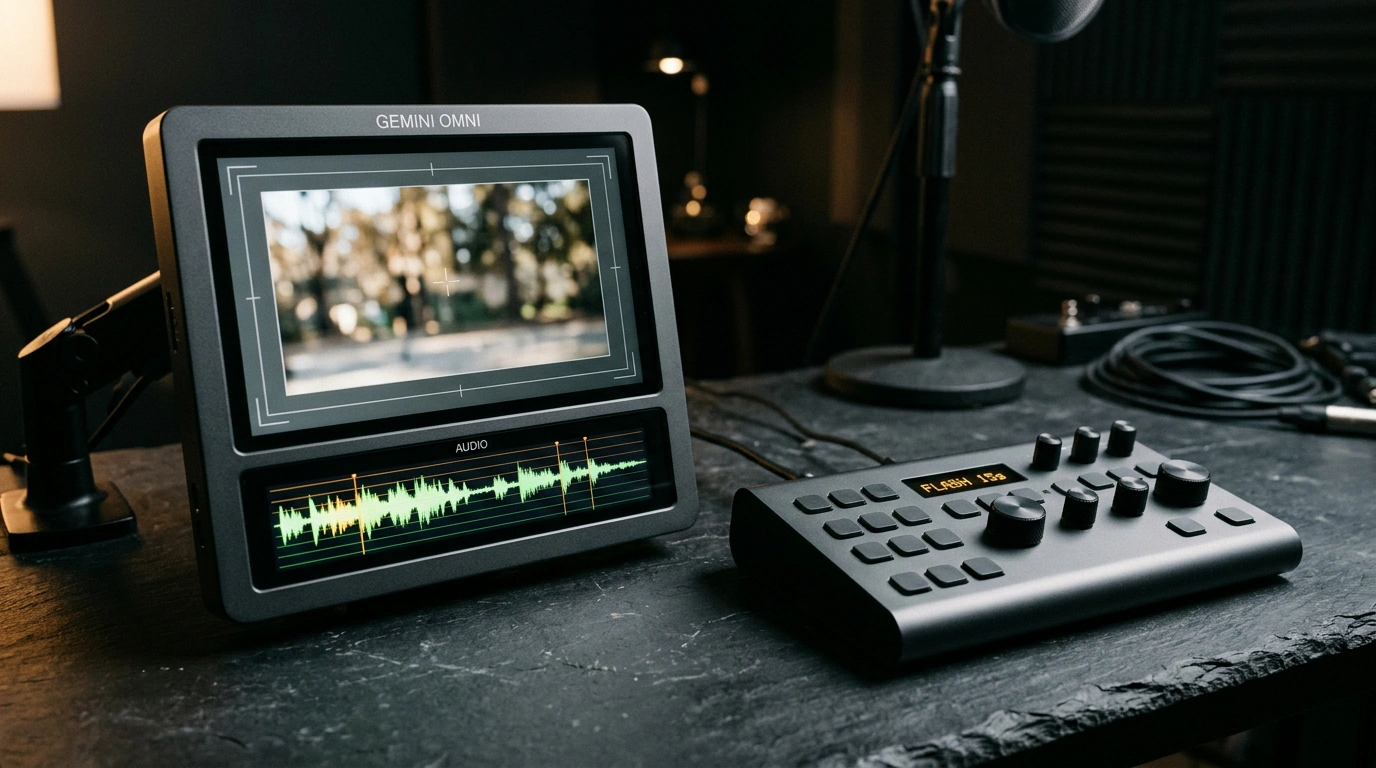
Visor de director y pista de onda audiovisual del editor de vídeo Gemini Omni 1.2 Flash
NotaIAInteligencia artificialProducción de videoGemini

Lanzamiento de Gemini Omni 1.2 Flash: vídeos de 15 segundos con audio integrado y edición paso a paso

Parece que cinco segundos extra en un clip generado por IA apenas cambian nada. En la práctica, la llegada de Gemini Omni 1.2 Flash de Google DeepMind a disponibilidad general con formato de 15 segundos y liderazgo en LMSYS Arena (1541 puntos) permite rodar en una sola toma una escena completa con sonido y voz sincronizados por $0.07 por segundo a 720p.

Mediante ajustes de texto paso a paso cambias la luz, el clima o la relación de aspecto en el propio chat sin romper la apariencia del protagonista ni el movimiento en cuadro. Eso sí, intentar renderizar desde el primer intento en alta resolución o rodar acción frenética funde el presupuesto sin remedio.

👍 19
Julian Goldie SEOGoogle DeepMind: Gemini Omni 1.2 Flash Video General Availability
15 de noviembre
Conjunto de pantallas móviles interactivas con botones e interruptores ensamblado en Google Stitch Rapid
NotaIADiseñoAutomatizaciónGoogle

Google Stitch Rapid: interfaces interactivas en 5 segundos con Gemini Decisions API

Cuando armas el prototipo de una app mediante un chatbot tradicional, la reunión se atasca enseguida en esperas: el modelo imprime la maquetación token a token y tarda 40–90 segundos en montar pantallas, reescribiendo el código con cada cambio.

En Google Stitch Rapid, impulsado por Gemini Decisions API, el modelo gemini-decision-1 no redacta texto, sino que en 150–250 milisegundos elige bloques ya listos y en 5 segundos entrega un diseño clicable editable por voz pulsando la barra espaciadora. Pero una sola pestaña cerrada por descuido borrará tu borrador al instante.

👍 19
Julian Goldie SEOGoogle Blog: Announcing Gemini Decisions API and Stitch Rapid
15 de noviembre
Arquitectura conceptual en dos niveles del motor en segundo plano Meta Muse Ember con flujos de tareas
NotaIAInteligencia artificialAutomatizaciónModelos

Meta Muse Ember: motor de IA especializado en operaciones masivas en segundo plano para pipelines agénticos

Al lanzar un agente de IA para clasificar solicitudes y hacer auditorías SEO, eliges entre dos arquitecturas: pasar cada paso por un único modelo insignia o repartir papeles entre el estratega Muse Wonder y el ejecutor en segundo plano Muse Ember de Meta. La primera vía es más simple al arrancar, pero tras miles de registros en el CRM la factura de API se come todo el beneficio.

El pipeline en dos niveles deriva el flujo de correos, PDFs y capturas a un motor con ventana de 1.000.000 de tokens de entrada, salida de hasta 512.000 tokens y tarifa de $0.10 por millón de tokens. Aun así, el más mínimo desajuste de roles convertirá la cadena barata en una fábrica de respuestas robóticas a clientes.

👍 19
Julian Goldie SEOMeta AI Blog: Muse Ember for Scalable Agent Pipelines
15 de noviembre
Terminal abierta en un portátil con la interfaz de OpenCode ejecutando el modelo grande de lenguaje LongCat
NotaIAOpen SourceInteligencia artificialHerramientas

LongCat 2.5 en OpenCode: acceso gratuito a un modelo de 1,6 billones de parámetros para programar

¿Cómo probar programando un modelo gigante de 1,6 billones de parámetros si solo tienes un portátil normal y cero presupuesto para API? En el agente abierto de terminal OpenCode han abierto gratis durante 2 semanas el acceso a LongCat 2.5 de Meituan: su arquitectura Mixture-of-Experts activa solo 48.000 millones de parámetros por token y mantiene una ventana de 1 millón de tokens bajo política Zero Data Retention.

Con el comando /models, la IA arma en un solo prompt un juego funcional de Tower Defense en el navegador. Pero el límite de 100 peticiones diarias y el alojamiento en servidores chinos exigen una táctica de prompting cuidada.

👍 19
Julian Goldie SEOLongCat AI: LongCat-2.5 Architecture and Developer Guide
15 de noviembre
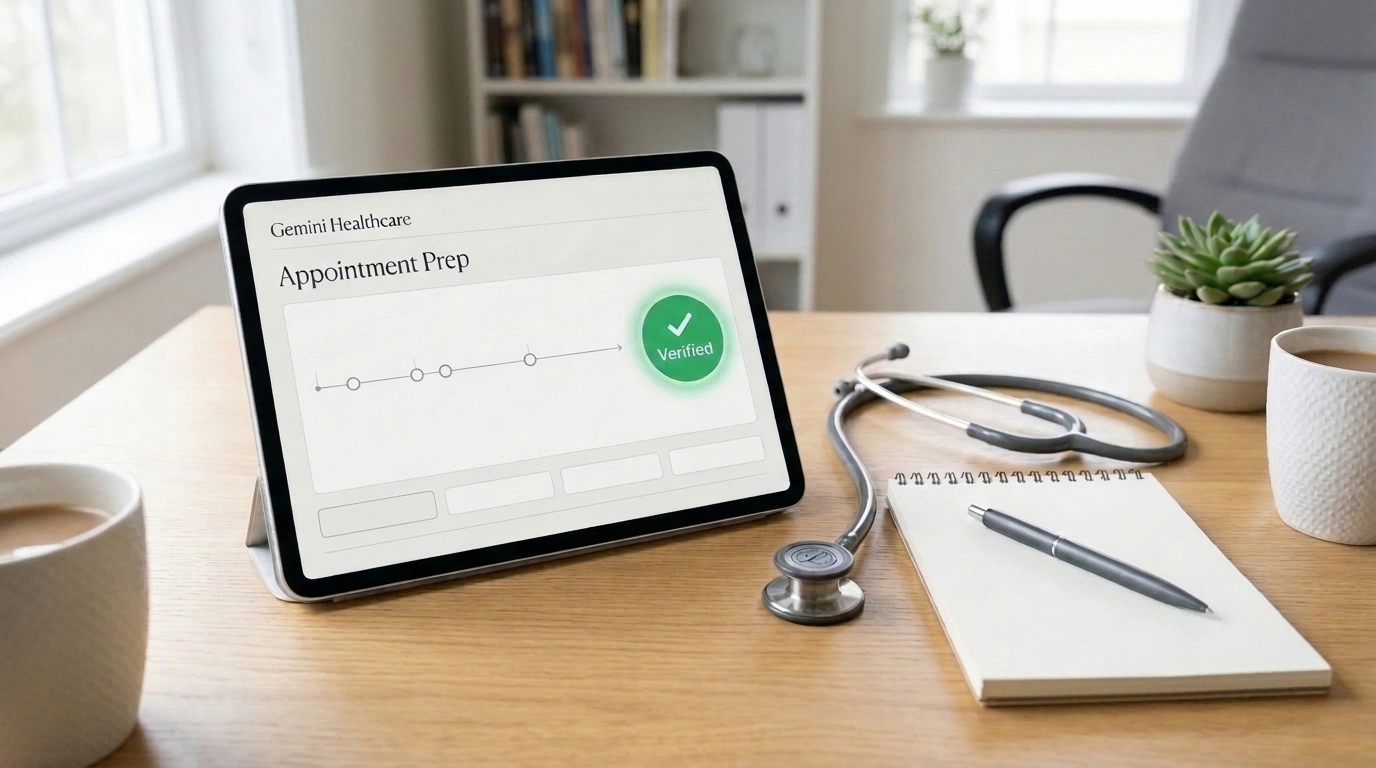
Tableta médica con la ficha de preparación de consulta y mapa cronológico de datos del paciente
NotaIAAutomatizaciónGoogleSalud

Gemini for Healthcare de Google Cloud: sistema multiagente para sintetizar historiales médicos y preparar consultas

Cuando un médico dedica 27–28 horas a la semana a informes y búsqueda de volantes, apenas le queda energía para hablar contigo en consulta. El sistema Gemini for Healthcare de Google Cloud ordena ese atasco en tres niveles:

  • Síntesis del historial: reúne 40 páginas de analíticas de Epic y Oracle Health en una línea temporal única con cita a cada documento original.
  • Autorizaciones del seguro: prepara las pruebas para la póliza en minutos en vez de días.
  • Perímetro de seguridad: acceso solo de lectura y estado de borrador hasta la firma del médico.

Pero incluso con soporte HIPAA, adaptar este esquema a tu propio proyecto es más fácil que entrar en la plataforma oficial.

👍 11
Julian Goldie SEOGoogle Cloud Healthcare: Medical Record Synthesis and Clinical Agents
15 de noviembre