Cuando hablas con una IA en una ventana de chat solo ves la fachada bonita: mandas una consulta y en un par de segundos tienes respuesta. Pero en la trastienda de la automatización nadie mantiene charlas: los pipelines en segundo plano clasifican correos, cruzan tablas y mueven datos entre servicios durante horas.
Para ese trabajo de pico y pala, Meta Superintelligence Labs lanzó el 9 de noviembre de 2026 el modelo Muse Ember (muse-ember-1.0). Al ver el anuncio me surgió al instante la pregunta: ¿para qué necesitaba Meta un motor aparte dedicado a la rutina si el mercado rebosa de modelos universales potentísimos?
Por qué los buques insignia universales arruinan a quienes operan agentes
La respuesta está en la diferencia de carga entre una conversación humana y una cadena de montaje autónoma. En el chat haces 1 o 2 preguntas y cierras la pestaña, así que el coste de llamar a una red pesada pasa inadvertido. Un agente autónomo, en cambio, lanza cientos de ciclos recursivos por una sola tarea: parsea logs, filtra listados y llama a herramientas externas.
Pasar todo ese flujo por un modelo insignia único es como repartir cartas en un camión volquete de cantera. El modelo tope de gama sacará sin problemas los teléfonos de un formulario, pero la factura de API tras miles de iteraciones se comerá todo el margen. Los ingenieros de Meta aplicaron división del trabajo: las decisiones complejas se quedan en el modelo superior y el grueso de microoperaciones pasa a un motor de ejecución barato (execution engine).
Cómo se reparten los papeles dentro de la familia Meta Muse
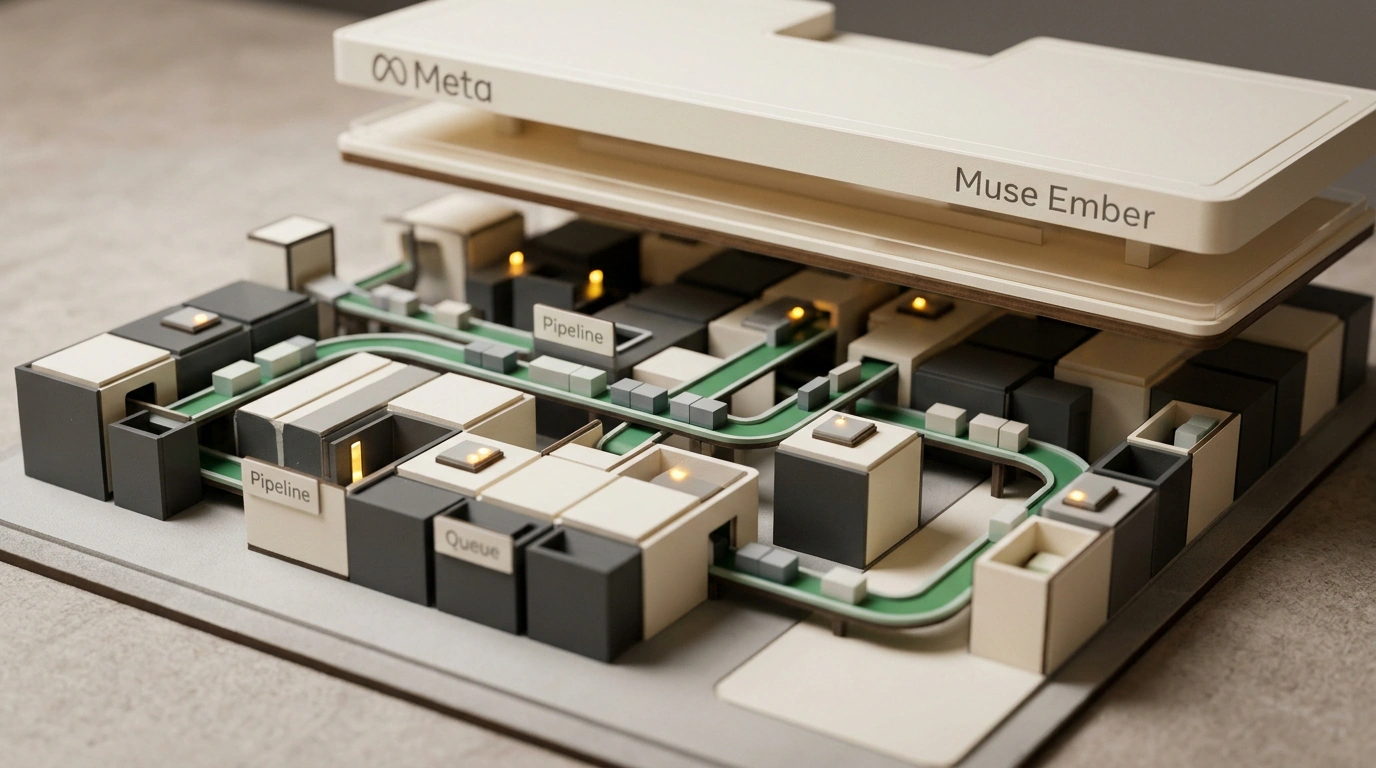
En el blog de Meta resumen el principio con la fórmula «Muse Wonder plans, Muse Ember handles the volume»: el planificador traza la ruta y el ejecutor absorbe el volumen. La familia Muse se divide en tres eslabones:
- Muse Wonder ejerce de estratega: analiza el objetivo, fija las reglas y descompone los pasos (y en productos de usuario crea interfaces en Spaces).
- Muse Spark se encarga de escribir código y escenarios agénticos amplios.
- Muse Ember actúa como ejecutor lineal: siguiendo instrucciones cerradas, clasifica entidades, llama a APIs y extrae campos JSON.
Autonomía técnica, precio ajustado y límites reales
Contrasté las especificaciones: el modelo menor viene preparado para analítica seria. Muse Ember ofrece una ventana de 1.000.000 de tokens de entrada y genera hasta 512.000 tokens de salida por pasada, suficiente para alojar una auditoría técnica web, un perfil de enlaces y la documentación de un proyecto. Además es multimodal de forma nativa: procesa directamente texto, informes en PDF, capturas de dashboards, audios de reuniones y vídeo sin conversores intermedios.
Su gran baza es una tarifa en torno a $0.10 por millón de tokens de entrada (ya comparamos su posicionamiento en el análisis de Muse Ember en la frontera de Pareto). Como muestra Julian Goldie (Julian Goldie SEO) sobre la documentación de Meta, procesar 10 millones de tokens de entrada y 2 millones de salida a tarifa estándar cuesta céntimos. A cambio hay que asumir dos límites: el modelo no diseña estrategias desde cero (si lo sueltas sin el marco del modelo superior da respuestas superficiales) y solo está disponible vía la nube de Meta Model API, sin fecha de lanzamiento para pesos locales.
Pipeline de clasificación de leads y reglas para montarlo sin quemar margen
En el flujo de embudo B2B que Julian Goldie detalla desde AI Profit Boardroom, el estratega Muse Wonder define los criterios de cualificación y Muse Ember lleva la operativa. En cada ciclo, el ejecutor lee correos, extrae nombre y email, consulta la web del cliente mediante petición web y, según señales de intención, clasifica los leads en calientes, templados o fríos. Acto seguido actualiza el CRM y redacta un borrador de respuesta para el comercial por fracciones de céntimo por lead. De forma similar, Ember busca brechas de contenido (content gaps) en SEO —cruza URLs de competidores con el blog y arma una tabla de palabras clave con estimación de dificultad— o ejecuta baterías de tests de código.
Para llevar este esquema en dos niveles a tus proyectos sin disparar el gasto, ten presentes tres reglas prácticas:
- Separa la planificación de la cinta de montaje: deja la descomposición del objetivo al planificador superior y pasa a Muse Ember los cientos de ciclos de parseo y filtrado.
- Entrega archivos variados directamente: aprovecha el contexto de un millón de tokens y la multimodalidad para meter PDFs, capturas y grabaciones de reuniones en una sola llamada.
- Deja en manos humanas la revisión de correos externos: confía al motor la clasificación de leads y la actualización del CRM, pero guarda las respuestas a clientes como borrador para evitar envíos robóticos sin pulir.
Repartir papeles entre un arquitecto y un ejecutor incansable derriba la barrera económica y vuelve rentables los pipelines agénticos complejos.